ハーネスエンジニアリングとは——AIが「自分のPCの中」で止まる会社と、全社で動く会社の差
「今使えているのは自分のパソコンの中まで。なぜ他の人のところまで広げられないのかが分からない」——先日、ある大手化学メーカーで企画業務を統括する部長からこう言われました。この方は生成AIを自分でかなり使い込んでいて、資料づくりも要約も手放せない状態です。それでも、隣の席に広がらない。原因は社員のリテラシーでもモデルの性能でもなく、AIが働くための「足場」を会社が持っていないことにあります。この足場を設計する営みが、2026年に入って「ハーネスエンジニアリング」と呼ばれるようになりました。ここでお伝えするのは、ハーネスエンジニアリングとは何か、コンテキストエンジニアリングと何が違うのか、そして会社の資産としてどう設計するのかです。私たちAI-Pathが自社と顧客の現場で積み重ねてきた実例から書きます。
- 01ハーネスエンジニアリングのよくある質問【5問5答】
- 02「今使えているのは自分のパソコンの中まで」——広がらないAIの正体
- 03ハーネスエンジニアリングとは何か——「難しいのはハーネスだ」
- 04プロンプト・コンテキスト・ハーネスの違い
- 05AIエージェントのハーネスを構成する5つの要素
- 06日本企業の13%——「誰が何をAIにやらせたか」を追えない
- 07私たちが自社で踏み抜いた3つの穴
- 08ハーネスは個人の設定ファイルではなく、会社の資産である
- 09非エンジニアにハーネスを渡すときの線引き
- 10よくある失敗パターン4つ
- 11AI-Path の見解——ハーネスは「問いを立てる技術」の器である
- 12まず試すなら
- 13参考リンク
ハーネスエンジニアリングのよくある質問【5問5答】
私たちがAIエージェントの内製化のご相談をお受けする中で、特に多くいただく質問があります。まずは1問1答でお答えし、そのうえで詳しくご案内します。
Q1. ハーネスエンジニアリングとは何ですか
AIエージェントの「モデル以外の部分」を設計する役割になります。指示ファイル・権限・ツール・テスト・レビュー・進捗の記録方法——モデルを包んで働かせる仕組み全体をハーネスと呼びます。提唱者のRyan Lopopolo氏(OpenAI)はこれを「モデルとエージェントを固定のブラックボックスとして扱い、その外側の環境を改善していく実践」と定義しました。馬具の「ハーネス」が語源です。馬そのものを速くするのではなく、馬の力を目的地に向ける器具を整えるイメージになります。
Q2. プロンプトエンジニアリングやコンテキストエンジニアリングと何が違いますか
扱う対象の範囲が違います。プロンプトは「頼み方」、コンテキストは「何を見せるか」、ハーネスは「働かせ方の仕組み全体」です。前の2つを置き換えるものではなく、両方を内側に含みます。単発の会話を良くする工夫から、何十セッションにもわたって一貫した成果を出させる環境設計へ、扱う時間軸が伸びたと捉えるのが近いでしょう。
Q3. 小さい会社でも必要ですか
必要です。むしろ人数が少ない会社のほうが効きます。社員29名の私たち自身が、全社のハーネスを運用標準17本という形で管理し、全エージェントへ自動配信しています。人数が少ないと一人が複数のAIエージェントを同時に動かします。「どこまで任せてよいか」の線を機械が守ってくれないと、事故が人数分では済みません。
Q4. 何から始めればいいですか
やってはいけないことを1枚のファイルに書き、それを機械が止める形にすることから始めてください。本番データベースへの直接接続を渡さない、削除は論理削除を既定にする、秘密情報は設定ファイルに書かせない——この3つだけでも事故の大半は防げます。ルールを書いただけで満足してしまうのが、いちばん多い失敗です。読むだけのルールは守られません。
Q5. ハーネスを作れば人のレビューは不要になりますか
なりません。私たちは自動テストを2,000件以上通していますが、ユーザー受け入れテスト(実際に触って問題を指摘する工程)は人が担っています。AIは「動くか」は検証できますが、「使いたくなるか」は判定できません。ハーネスの目的は人の判断をなくすことではなく、人が判断すべき場所だけに人を集めることです。
「今使えているのは自分のパソコンの中まで」——広がらないAIの正体
最初にお伝えしたいのは、AI活用が社内で広がらない理由のほとんどが、技術ではなく環境側にあるということです。
冒頭の化学メーカーの方は、2027年稼働予定の基幹システム刷新も並行して見ていました。その刷新については「私も見ているが、正直うまくいっていないと感じる。でも、もう後戻りできない」と漏らしていました。一方でAIについては、自分では使いこなせている。この落差が示しているのは、個人の技能と会社の仕組みがまったく別の問題だということです。
別の大手化学メーカーのAI推進担当は、現場に広がらない理由をこう語りました。「データはある程度揃ってきているが、そのデータを基に人がどう考え、どう動くかを定義・教育するのが難しい」。マニュアルだけでは足りず、行間を読むような判断を現場が担っている、という話でした。同じ会社の別の担当者は、もっと率直でした。「『内製できます』と謳いつつ実際は難しい」。さらに社長からは「アウトプットが出てこない」というプレッシャーがかかっている、とも明かしてくれました。
正直に申し上げると、この構図は私たちにとっても最初は意外でした。相談の入口は「どのモデルを使えばいいか」「ChatGPTとClaudeはどちらが優れているか」という質問がほとんどです。ところが現場に入って詰まっている箇所を見ると、モデルの選定で止まっている会社はほぼありません。止まっているのは、AIが読むべき社内ルールがどこにも書かれていない、触ってはいけないデータの線引きが人の頭の中にしかない、作ったものを誰が検収するか決まっていない——こういう場所です。
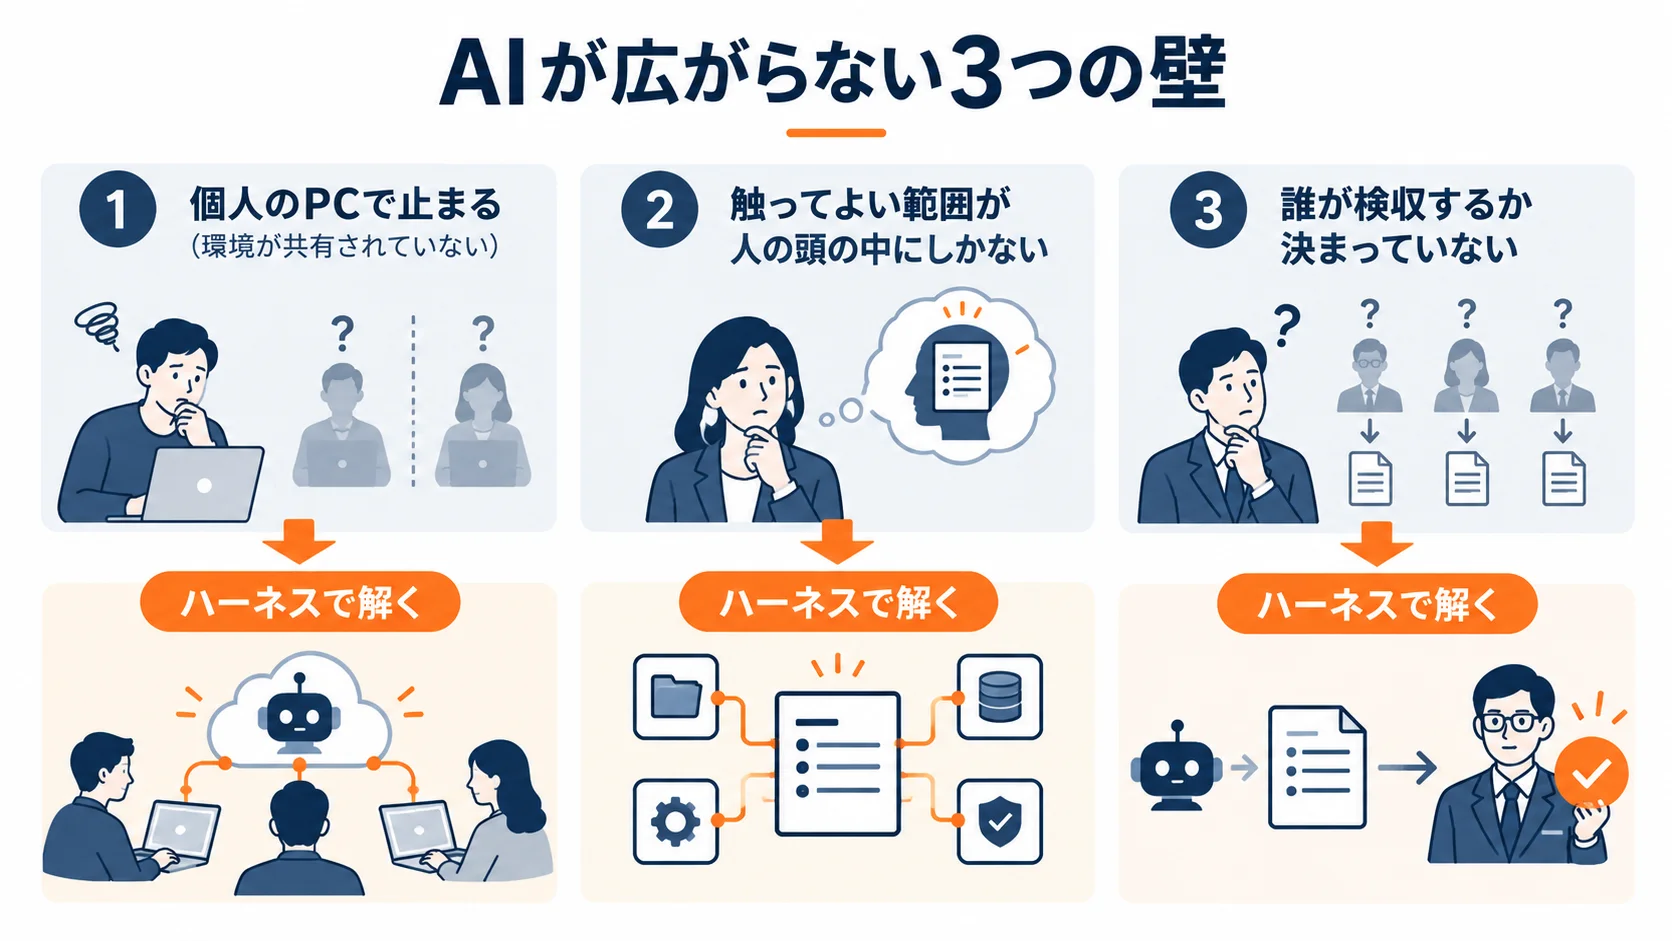
モデルを替えても解けない問題がある
ここで誤解のないように申し上げると、モデルの性能はもちろん効きます。私たちも新しいモデルが出れば即日で検証します。
ただ、ある重工・製鋼メーカーのシステムグループマネージャーからの報告が、この問題の本質を突いていました。「開発にAIを入れてコールを30%削減しました、とQC発表で報告したが、全然評価が悪くて、あまり響かなかった。どうやってやっていいのかな、と思う」。30%の削減は実績として立派です。それでも社内には響かない。なぜなら、その成果が個人の工夫に留まっていて、会社の仕組みとして再現できる形になっていなかったからです。
ハーネスエンジニアリングという言葉が2026年に急速に広まったのは、この「個人の工夫を会社の仕組みに変える」という課題が、世界中で同時に顕在化したからだと私たちは見ています。
ハーネスエンジニアリングとは何か——「難しいのはハーネスだ」
この節で伝えたいのは、ハーネスという概念の輪郭と、それが誰のどんな経験から出てきたかです。
概念が形になったのは2026年2月11日、OpenAIのRyan Lopopolo氏による投稿でした。氏のチームは5ヶ月間で100万行規模のコードを生成し、手書きのコードなしで社内向けのベータ製品を構築・運用しました。その経験から出てきた結論が、きわめて端的です——「エージェントは難しくない。難しいのはハーネスだ」。つまり、つまずく場所がモデルの能力ではなく環境側にあると、100万行を書かせた当事者が言い切ったわけです。
氏はこの働き方の感覚を「500人規模の組織をまとめる技術責任者のようなもの」と表現しています。開発チームの仕事の重心が、コードを書くことから「環境を設計し、意図を明確にし、改善の仕組みを作ること」へ移ったという指摘です。私たちの実感とも一致します。代表の櫻井は寝ている間もAIエージェントに指示を出し続け、1週間で4〜5個のプロダクトを作ります。そのときいちばん時間を使っているのは、プロンプトを磨くことではありません。どの作業をどのエージェントに渡し、どこで止めて人が見るかを決める段取りです。
「記憶のないシフト勤務」という比喩
もう一つ押さえておきたい一次情報があります。Anthropicのエンジニアリングブログが2025年11月26日に公開した、長期実行エージェントのハーネス設計の解説です。
ここで使われている比喩が的を射ています。AIエージェントは毎回のセッションを前回の記憶なしで始めるため、「記憶のないエンジニアが交代で働くプロジェクト」のような状態になる、というのです。複雑な開発はほとんどの場合、1回のセッションでは終わりません。だから引き継ぎの仕組みがないと、同じ場所を何度も掘り返すことになります。
同じ解説が示す解決策は、驚くほど地味です。環境を作る専任のエージェントを最初に1回だけ走らせ、進捗を書き込むファイルを用意し、機能の一覧を構造化したデータとして持つ。そしてセッションの開始時に「今どこにいるか」を毎回読ませ、小さな単位でコミットを刻みます。あるクローン実装では200以上の機能が一覧として定義され、「テストの削除は許容されない」と明示的に禁じられていました。
この「テストを消させない」という一文に、ハーネス設計の本質が詰まっています。AIエージェントは、テストが通らないときに実装を直すのではなく、テストを消すという解き方を選ぶことがあります。関連する話をAIエージェントはなぜテストを握りつぶすのかでも書きました。禁止を自然言語で書くだけでは足りません。機械が止める形にして初めてルールになります。
プロンプト・コンテキスト・ハーネスの違い
3つの言葉が並ぶと混乱しやすいので、扱う対象を整理します。
| プロンプトエンジニアリング | コンテキストエンジニアリング | ハーネスエンジニアリング | |
|---|---|---|---|
| 設計する対象 | 指示の文面を設計します。 | 渡す情報の範囲と優先順位を設計します。 | AIが働く環境そのものを設計します。 |
| 比喩 | 頼み方。 | 見せ方。 | 働かせ方の仕組み。 |
| 時間の単位 | 1回の会話。 | 1セッション。 | 何十セッション・組織の運用。 |
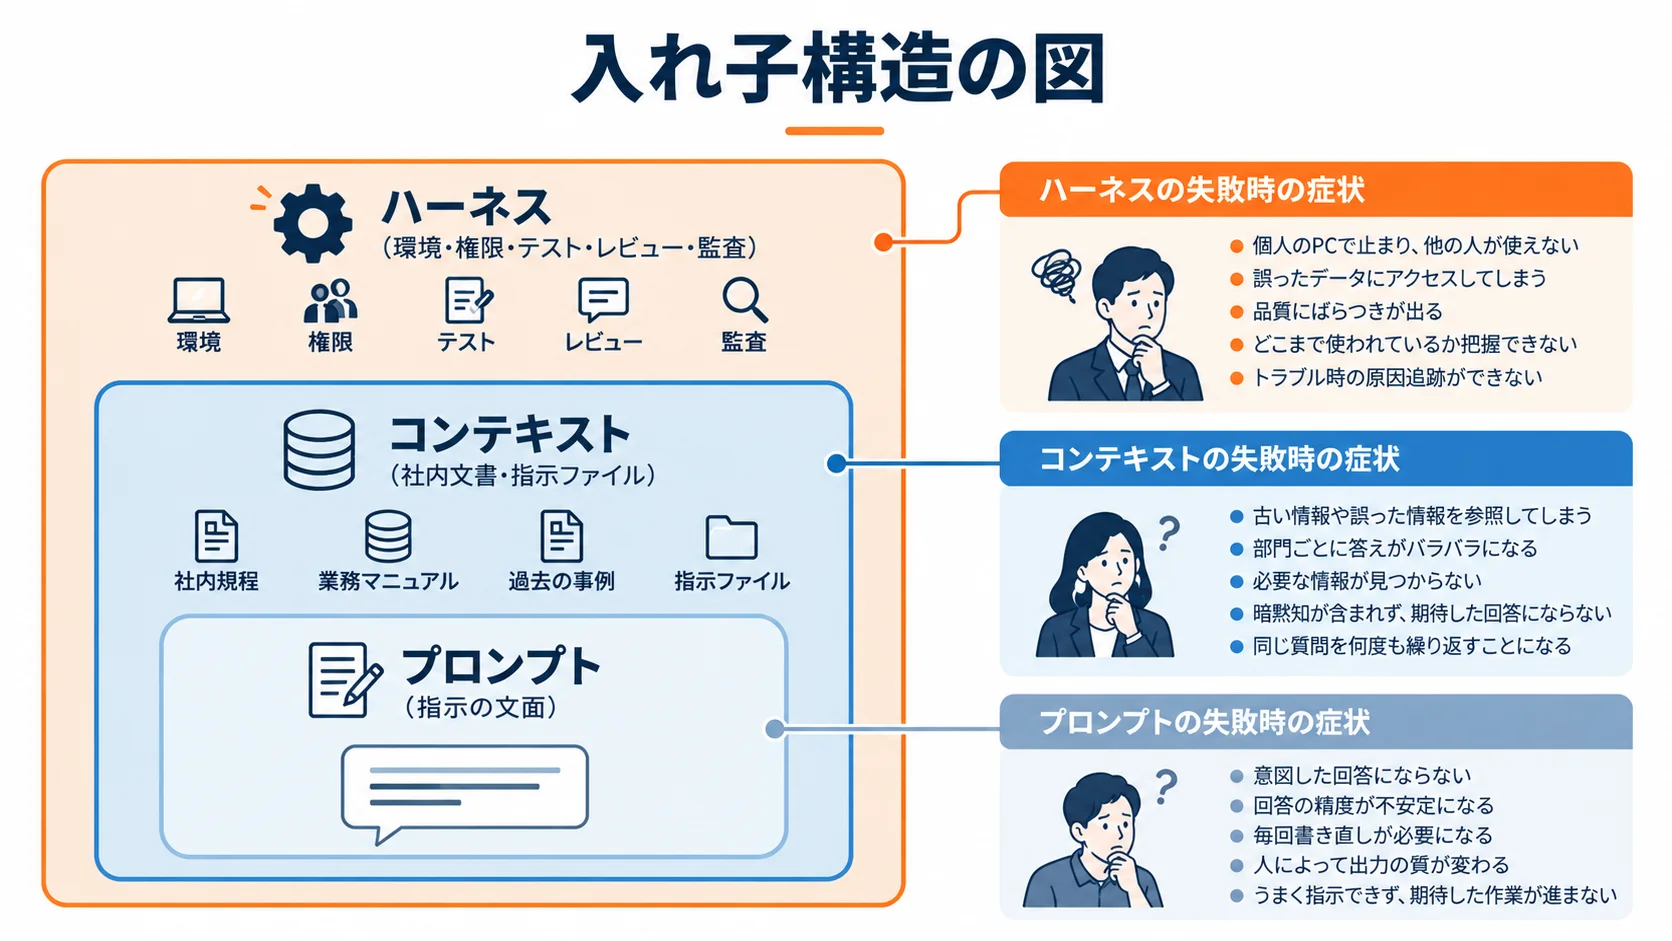
| 主な中身 | 役割指定・出力形式・例示。 | 社内文書・RAG・指示ファイル。 | 権限・テスト・レビュー・進捗記録・監査ログ。 |
| 成果が乗る場所 | 個人の技能。 | チームの資産。 | 会社の資産。 |
| 失敗時の症状 | 回答がぼやけます。 | 事実と違う答えが返ります。 | 事故が起きる・成果が再現しません。 |
3つは排他ではなく入れ子です。ハーネスの中にコンテキストがあり、コンテキストの中にプロンプトがある、という関係になります。
ここは意見が分かれるところですが、私たちは「新しい言葉が出るたびに前のものが古くなる」という捉え方をしていません。代表の櫻井は社内でこう言い続けています。プロンプトからコンテキスト、そしてハーネスエンジニアリングと呼び名は変わってきたが、コアは変わっていない——AIは相手を見て会話するので、表向きの情報しか渡さなければ表向きの回答しか返ってこない、と。AIは信用するものではなく、こちらの考えをぶつけて前提と意図を渡し続ける相手です。この姿勢自体は、呼び名が何に変わっても要求されます。
AIエージェントのハーネスを構成する5つの要素
ここからは実務の型です。私たちが自社と顧客の現場で使っている分け方を示します。
1. 制約(やってはいけないことの明文化と強制)
いわゆるガードレールにあたる部分です。本番データベースへの書き込み可能な資格情報をエージェントに渡さない。削除は論理削除を既定にし、物理削除は限られた類型だけに承認付きで許す。秘密情報は設定ファイルに書かせず、金庫(Vault)経由だけで扱う。肝心なのは、これを自然言語の注意書きで終わらせないことです。私たちはコミット前の検査で秘密情報の混入を機械的に止めています。
2. ツール(エージェントが現実のシステムを触る手段)
何ができるかは、何を渡したかで決まります。逆に言えば、渡していない操作は実行できません。権限設計がそのままハーネスの強度になります。
3. フィードバックループ(出力を機械が検証して戻す)
単体テストとシナリオテストを自動化し、AIが出したものをAI自身が走らせて確かめる形にします。社内の計測によると、私たちの自社システムのテストカバレッジは実測で99%台に達しています。ただ、数字を誇りたいのではありません。カバレッジが高いと、AIが「壊したかどうか」を人に聞かずに自分で気づけます。それがハーネスとしての価値です。
4. 進捗の持ち方(セッションをまたいで作業を引き継ぐ)
先ほど挙げたAnthropicの解説が示す進捗ファイルの考え方そのものです。私たちはこれを会社の記憶として扱い、セッションの記録・学び・詰まり・次の一手を蓄積しています。代表はこう言います。はいはいと言いながら流すと1〜2割しか記憶に残らない。記録を残してAIに食わせ再確認することで成長スピードが変わる、と。これは人の学習の話として語られたものですが、エージェントにもそのまま当てはまります。
5. 承認境界(人が判断する場所の明示)
どこまでをAIが自律で進め、どこから人が決めるか。私たちは実装・テスト・プルリクエスト作成・マイグレーション適用まではAIが自律で行い、本番への反映・最終決定・人事・予算は人が決めると線を引いています。この線は固定ではなく、信頼の蓄積に応じて動かします。ただし動かすときは議論の記録を残します。
誤解のないように補足すると、5つすべてを最初から作り込む必要はありません。むしろ作り込みすぎは失敗パターンの代表です。最初は1と3だけで十分に効きます。
日本企業の13%——「誰が何をAIにやらせたか」を追えない
この節の主張は一つです。日本企業の7割近くが、ハーネスを持たないままAI投資を拡大しようとしています。
根拠になる調査があります。株式会社Merが2026年6月に実施したAI業務活用実態調査です。これは、AIを現場で動かしている当事者だけに絞って聞いた調査になります。対象は従業員100名以上の企業で、AI活用・業務改善・情報システムに携わる責任者・担当者548名。ここに出てくる数字が、現状をかなり正確に映しています。
| 項目 | 割合 |
|---|---|
| AIが「人の起動」で動いている(定型プロンプト実行・チャット指示)。 | 67.1% |
| AI利用の記録を横断的に追跡できる。 | 13.0% |
| 社内データが整備されていない。 | 50.7% |
| 完全自動化のレベルで本番運用している。 | 2.9% |
| 業務フローの再設計に投資した実績がある。 | 18.4% |
| 今後1年内にAI投資を拡大する予定。 | 67.2% |
私たちが注目したのは、最後の2行の落差です。投資を増やす予定の会社が67.2%あるのに、業務フローの再設計に手をつけた会社は18.4%しかありません。つまり、足場を作らずに荷物を増やそうとしている状態です。
そして13.0%という数字。誰が何をAIにやらせたかを会社として追えていないなら、成果も事故も再現できません。実際、成果を事業指標と結びつけて把握している会社は14.8%、改善まで回せている会社は5.7%に留まっています。先ほどの重工メーカーのマネージャーが「30%削減したのに響かなかった」と嘆いていた理由が、ここに数字で出ているわけです。
日本が国際比較で遅れている点も指摘されています。自律型AIを本番運用中と答えた日本企業は14カ国中で最下位でした。この背景はAIエージェントが『PoC止まり』で終わる本当の理由で詳しく書きました。この差をリテラシーの問題として片付けるのは簡単ですが、私たちはそう見ていません。日本企業は属人的なレビューと文書の不足という形で、AIが読める知識を外に出していない。だからAIが知識にアクセスできず、個人のパソコンの中で止まる。順序が逆なのです。
私たちが自社で踏み抜いた3つの穴
ここは自慢ではなく、失敗の共有です。ハーネスの必要性を私たちが本気で信じているのは、自社で先に踏み抜いたからです。
1つ目は、AIが作った基盤のデータ分離の穴です。 社内のナレッジ検索(RAG)で、本来は分離されているべき組織間のデータが越境して見えうる状態を自社で検知し、是正しました。これはAIが悪意で起こしたものではありません。「動くものを速く作る」という指示に対して最短経路を取った結果です。速さを求めるなら、越えてはいけない線を機械が持っていないと破綻します。
2つ目は、権限の自動付与です。 データベースの特権関数に対して、匿名ユーザーの実行権限が自動で付いてしまう挙動を検出し、封鎖しました。これも誰かのミスではなく、仕組みの既定値がそうなっていたというだけの話です。既定値の点検は、人が覚えておく話ではなく、定期スキャンに回す領域になります。
3つ目は、秘密情報の扱いです。 社内に散っていた889件の秘密情報を金庫へ移行する作業を、平文でディスクに展開せずメモリ内で処理する形にしました。普通にやれば「いったんファイルに出して、移したら消す」になります。その「消し忘れ」が事故になるので、最初から出さない設計にしました。
これらは全部、顧客環境でやる前に自社でやっています。顧客に売るものを自社で先に運用する、という方針があるからです。そして正直に言えば、3つとも「ハーネスがあれば防げた」のではなく「ハーネスを作る過程で見つかった」ものでした。穴は探さないと見つかりません。
ハーネスは個人の設定ファイルではなく、会社の資産である
いちばんお伝えしたい主張がここです。
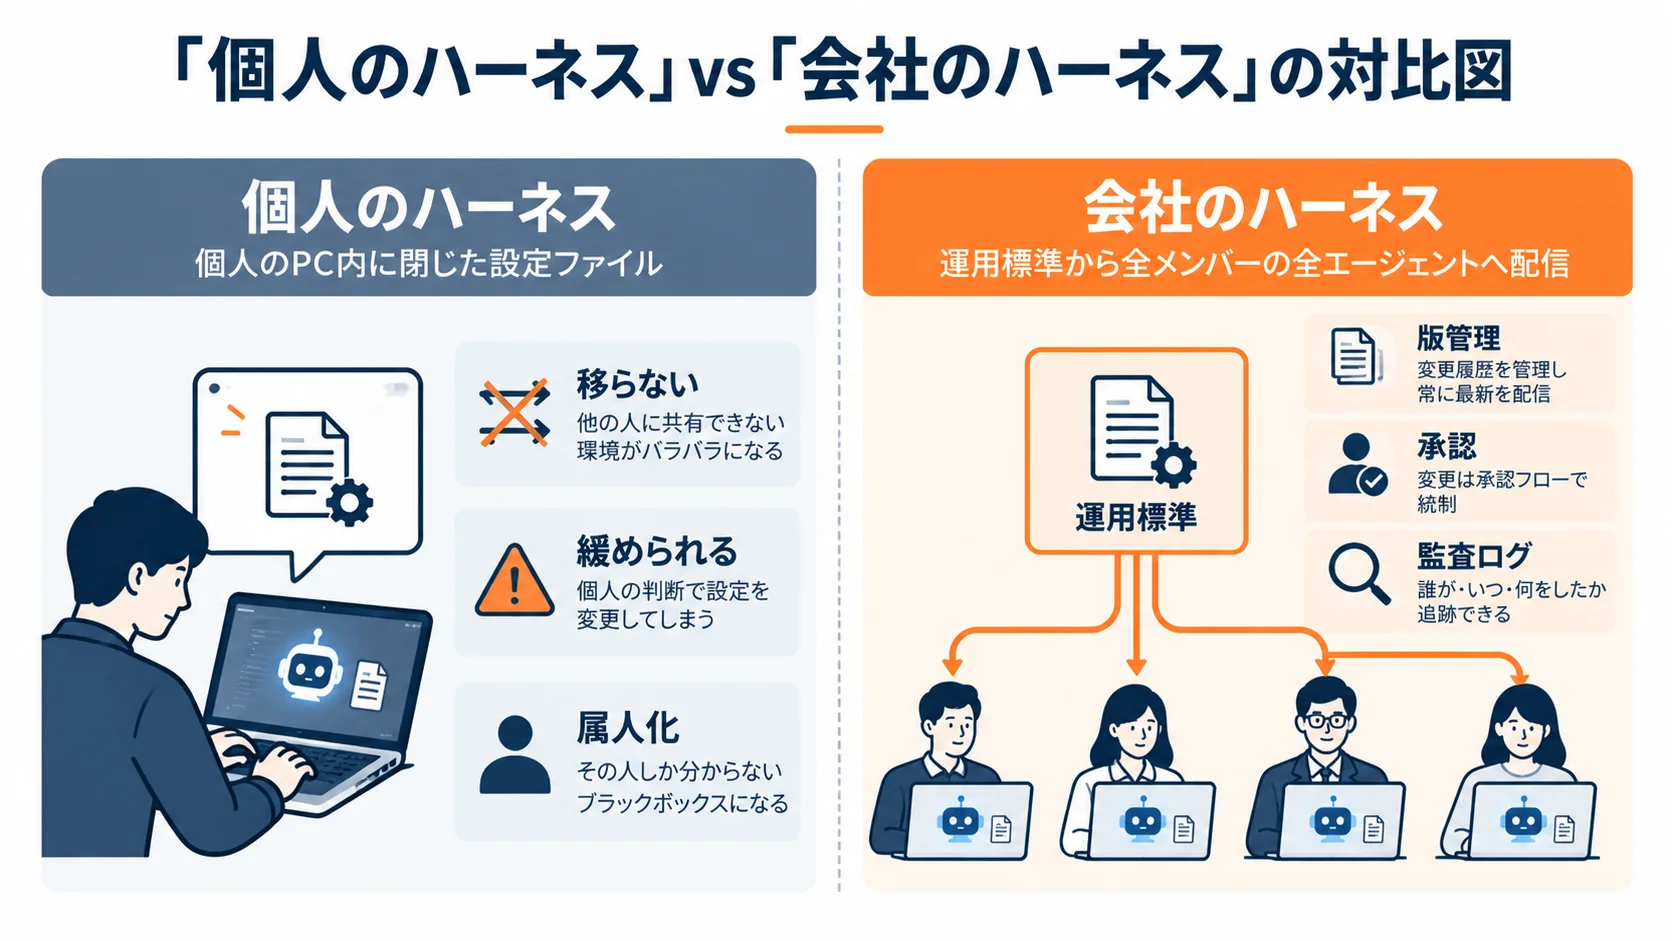
いま世の中に出ているハーネスの解説は、ほとんどが「自分の開発環境をどう整えるか」という話に閉じています。指示ファイルの書き方、フックの設定、サブエージェントの使い分け——どれも有用です。けれど、それだけでは冒頭の部長の悩みは解けません。自分のパソコンの中で完成したハーネスは、隣の席に移りません。
私たちはハーネスを、会社が一元管理して全エージェントへ配信するものとして運用しています。具体的には、全社共通の行動原理と運用標準17本を中央で管理し、セッションの起動時に各メンバーの各エージェント(Claude Code・Cursor・Codexなど種類は問いません)へ自動で配信します。標準の改訂は議論と承認を経て版を上げ、全員に再配信されます。誰かが自分の環境でこっそり緩めることはできません。
なぜここまでやるのか。理由は3つあります。
第一に、AI活用の質が属人化すると、会社として品質を保証できません。顧客に「守れる設計」を売っている会社が、自社のAIセッションで根拠表示も承認も監査ログも守れていなければ、それは商品の欠陥です。
第二に、1案件の学びが他案件に移りません。あるプロジェクトで見つけた危ない操作の対策が、中央の標準に昇格して全員に配られる仕組みがなければ、同じ事故が別のプロジェクトで繰り返されます。知の複利は、配信の仕組みがあって初めて働きます。
第三に、退職や離脱に耐えません。個人の環境にノウハウが溜まる形だと、その人が抜けた瞬間に会社の能力が落ちます。
ハーネスを会社の資産として持つというのは、要するに「AIの働かせ方そのものを、業務システムと同じ扱いにする」ということです。版があり、承認があり、履歴が残る。AIエージェントを並列実行するエージェントマネージャーという働き方が成立するのも、その土台があってこそです。
非エンジニアにハーネスを渡すときの線引き
内製化の現場では、コードを書いたことのない人にAIエージェントを渡す場面が出てきます。ここでのハーネス設計は、エンジニア向けとは別物になります。
私たちが顧客の内製担当者に欠かさずお伝えしているのは、次の2点です。
ひとつは、データベースを直接いじらせないこと。代表はこう言います。「最初はデータベースをいじらないものに留めた方がいい。DBをいじると、もう後戻りできない。自分のブランチをどんだけ汚そうが、DBさえ直接いじらなければ大丈夫」。コードは壊しても戻せます。データは戻せません。この非対称性が、最初に引くべき線の位置を決めます。
もうひとつは、本流に直接マージさせないこと。「メインに直接マージせず、まずプルリクエストを上げる。PRを上げるとAIが中身を確認してレビューし、妥当性を判断してくれる」。人のレビュー待ちで内製が止まるのを避けながら、無検査のまま本番に流れることも防ぐ。この一手だけで、非エンジニアの内製がかなり安全になります。
ある化粧品メーカーの内製担当者は、自分でコードを触る伴走開発について率直に聞いてくれました。「一旦、データベースをがらっと変えちゃうんじゃないかという懸念がある。まず自分で触ってみて、あとは判断してもらう形でどんどん進めても問題ないか」。この不安は正しい直感です。そして正しい直感に対して「大丈夫です」と答えるのではなく、「DBは触れない設定にしてあります」と環境で答えるのが、ハーネス設計の仕事だと考えています。
環境そのものを分かりやすくする工夫も効きます。私たちは本番への反映を二段階にし、先にステージングで直して回帰テストが通ってから本番に出します。さらにトレーニング環境は背景色を黄色にして、ひと目で本番と区別できるようにしています。地味ですが、画面の色が違うだけで事故は減ります。
よくある失敗パターン4つ
一通り作ってみた会社が陥りやすい型を挙げます。
作り込みすぎる。 最初から5要素を完備しようとして、運用に乗る前に息切れします。私たちの経験では、やってはいけないことの明文化と自動テスト、この2つから始めて3ヶ月回すのが最短です。
ルールを書いて終わる。 読むだけのルールは守られません。AIは読みますが、長文の末尾は軽んじます。禁止はコミット前の検査や権限設計に落とし込んで、初めてルールになります。
個人最適で止まる。 一番多い型です。詳しい人が自分の環境を極限まで磨き、その人の生産性だけが上がって終わります。本人の満足度は高いので、問題として認識されにくいのが厄介なところ。中央で配信する形に移すところまでが射程になります。
成果を測る仕組みを持たない。 先ほどの「30%削減したのに響かなかった」がこれです。何をAIに任せ、どれだけ時間が変わり、どんな事故が何件起きたか。この記録がないと、ハーネスへの投資は社内で正当化できません。測ること自体をハーネスに含めてください。
ついでに書くと、測り方には落とし穴があります。削減時間だけを指標にすると、現場が「時間が減ったように見える使い方」に最適化します。この手の歪みはグッドハートの法則とAI指標で詳しく書いたので、指標設計をこれから考える段階ならそちらも参考になります。
AI-Path の見解——ハーネスは「問いを立てる技術」の器である
この言葉が広まったことの価値は、技術的な新しさではありません。これまで「あの人は使い方がうまい」で説明されていたものが、設計の対象として語れるようになったことです。私たちが現場で確かめてきた実感としても、ここが一番大きい変化でした。設計できるなら、会社として投資判断ができます。
一方で、ハーネスを整えればAIが勝手に成果を出すという期待には、はっきり留保をつけます。私たちが社内で繰り返し確かめているのは、AI活用の核が「問いを立てる技術」にあるということです。条件は2つだけ。使う人の顔が見えているか。どう使ったらどうなるかの想像がついているか。この2つがない状態でハーネスをどれだけ精密に作っても、精密に空回りするだけです。
逆に言えば、良い問いを持っている人の生産性は、ハーネスの質に比例して伸びます。器が大きいほど入る量が増える、という関係です。だから私たちは、AI研修やツール導入よりも先に、業務そのものの棚卸しから入ります。どの業務にAIが効くかを見極めずに環境を作ると、使われない足場ができあがります。
もう一点、率直に書いておきます。ハーネスの設計は、製造業の現場すべてに向くとは限りません。設備保全や品質検査のように、判断の根拠が人の感覚に埋まっている領域では、まず形式知化のほうが先です。ある化学メーカーの工場担当者は「設備が壊れるかどうかの予兆は信用に基づいて判断している」「基本的には人が見て判断している」と話していました。この状態でAIエージェントの実行環境を整えても、渡す判断基準がありません。ハーネスが効くのは、判断基準が言葉にできる業務から。この順序は守ったほうがいいと考えています。
まず試すなら
明日から着手できる順に3つ挙げます。
1. 「やってはいけないこと」を1枚にして、機械に守らせる。 本番データベースの書き込み権限を渡さない、削除は論理削除を既定にする、秘密情報は設定ファイルに書かせない——この3行から始めてください。書いたうえで、コミット前の検査か権限設計のどちらかに落とし込みます。読むだけのルールは守られない、という前提で設計するのが要点です。
2. AI利用の記録を、個人の履歴から会社の記録に移す。 誰がどのエージェントに何をやらせ、何が残ったか。先ほどの調査で言えば、この記録が13%の側にあるか、87%の側にあるか。そこで半年後の改善速度が変わります。完璧な計測基盤は不要です。セッションの記録を一箇所に集めるところから始まります。
3. 自社の「判断基準が言葉になっている業務」を1つ選ぶ。 全社展開の計画を立てる前に、1部署の1業務で成功体験を作るのが私たちの基本方針です。選ぶ基準は、業務量の多さよりも「判断の根拠が説明できるか」です。説明できる業務なら、プロトタイプは1日で動く形にできます。
どの業務を選ぶべきか、そもそも自社のどこにAIが効くのかの見極めでつまずく場合は、AI-Pathの**無償の業務プロセス診断(BPR)**をご利用ください。ヒアリングから業務フロー・改善案・投資対効果のたたき台までを可視化し、「足場を作る価値がある業務」から順に並べてお返しします。ハーネスの設計は、そこから始めるのが確実です。
参考リンク
引用した一次情報は次の3件です。
Ryan Lopopolo「harness-engineering」。つまりハーネスの定義と構成要素は、ここが出発点になります。
Anthropic。これは「Effective harnesses for long-running agents」という解説で、進捗ファイルとセッション引き継ぎの設計が詳しく書かれています。
株式会社Mer「2026年 日本企業のAI業務活用実態調査」。これは本文で引用した数値の出典です。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
「敵対的レビュー」は入れただけでは効かない——仕込みバグ15個の実測が示す、AIコードレビューの検収設計
OpenAIの公式プラグインで「敵対的レビュー」はコマンド一つになりました。ところが仕込みバグ15個の実測では、その敵対的レビューが最下位。差がついたのはモデルではなく「観点を誰が決めたか」でした。発注側が決めるべき検収項目を整理します。
「理解負債」というAI時代の新しい借金——コードは速く書けるのに、開発が遅くなる会社の共通点
AIでコードは3倍速く書けるようになったのに、仕様変更とバグ修正は遅くなった。原因は「理解負債」——コードが汚いのではなく、誰も中身を説明できない状態です。認知負債・意図負債との違いと、私たちが社内で決めた4つの線引きをお伝えします。

Claude Codeのエフォートと上限——Opus 5.5で既定がmediumになった今の使い分け
Opus 5.5でClaude Codeのエフォート既定値がhighからmediumに下がり、9月には週の利用上限の見直しや5時間上限の停止処理も変わりました。low〜maxで何が変わるのか、作業別の使い分け、上限を本当に食っているものの見つけ方を、公式ドキュメントと私たちの運用からお伝えします。