「理解負債」というAI時代の新しい借金——コードは速く書けるのに、開発が遅くなる会社の共通点
「作ったものは動いています。ただ、中身を説明できる人がもういません」——AI活用が進んだ会社ほど、この報告が増えてきました。コードを書く速度は確かに上がったのに、仕様変更とバグ修正だけが前より重い。原因は技術的負債ではなく、2026年に名前が付いた「理解負債」という別の勘定です。ここでお伝えするのは、理解負債・認知負債・意図負債という3つの借金の違い、請求書が誰に届くのか、そして私たちAI-Pathが自社とお客様の現場で決めた線引きです。実際の運用を交えてご説明します。
- 01「作った本人が、もう中身を説明できない」——最初の違和感は社内から出た
- 02理解負債とは何か——技術的負債との決定的な違い
- 03なぜ「速く書けるのに遅くなる」のか——請求書は後から、別の人に届く
- 04負債は3種類ある——理解・認知・意図
- 05請求書は誰に届くか——理解負債を会社の勘定に載せる
- 06非エンジニアのVibeCodingが生む「新種の属人化」
- 07私たちが社内で決めた、負債を増やさない4つの線引き
- 08意図を外部化する——「なぜそう決めたか」を会社の資産にする
- 09自社の理解負債を測る7つの質問
- 10内製と外注の線引きは「作る」ではなく「分かり続ける」で決める
- 11よくある質問
- 12まず試すなら
- 13参考リンク
「作った本人が、もう中身を説明できない」——最初の違和感は社内から出た
正直に申し上げると、この問題に最初に気づいたのは顧客の現場ではなく、私たち自身の社内でした。
AI駆動開発(VibeCoding)を全社の標準にしてから、プロダクトは明らかに速く増えました。1週間で4〜5個のツールが立ち上がる週もあります。ところが、しばらくしてレビューの場でこんなやり取りが起きるようになりました。「この分岐、なぜこの条件なんですか」「……すみません、AIが書いたところで、理由は分かりません」。
コードは動いています。テストも通っています。それでも、仕様を一つ変えようとすると誰も即答できない。プロダクトの数が増えるほどこの質問が増える、という相関は想定していませんでした。速くなったはずの開発が、変更の局面だけ遅くなっていたのです。
同じ構造の話を、お客様からも立て続けに聞くようになりました。ある大手化学メーカーの執行役員は、内製化への関心をこう語っています。「一度作ったら、メンテナンスはさすがにできない。ある程度は内製化していかないと世の中の力についていけない」。同社の別の担当者は、もっと率直でした。「個別にプログラミングで作ったシステムの運用・管理が昔からの課題」「『内製できます』と謳いつつ実際は難しい」。
興味深いのは、この会社がAIを使えていないわけではないという点です。むしろ現場では使われていました。使えているのに、運用に回ると詰まる。問題は技術力ではなく、別のところにありました。
理解負債とは何か——技術的負債との決定的な違い
この現象には2026年3月に名前が付きました。@ITの「AIコーディングはなぜ後から苦しくなるのか?」。この解説が「理解負債(Comprehension Debt)」と「認知負債(Cognitive Debt)」という2つの概念を整理しています。
@ITは理解負債を、「AIが生成したコードを開発者が正確に理解できないままプロジェクトに組み込む」ことで発生する後発的コストと定義しています。読んだとき、社内のレビューで起きていたことがそのまま言語化されていて驚きました。
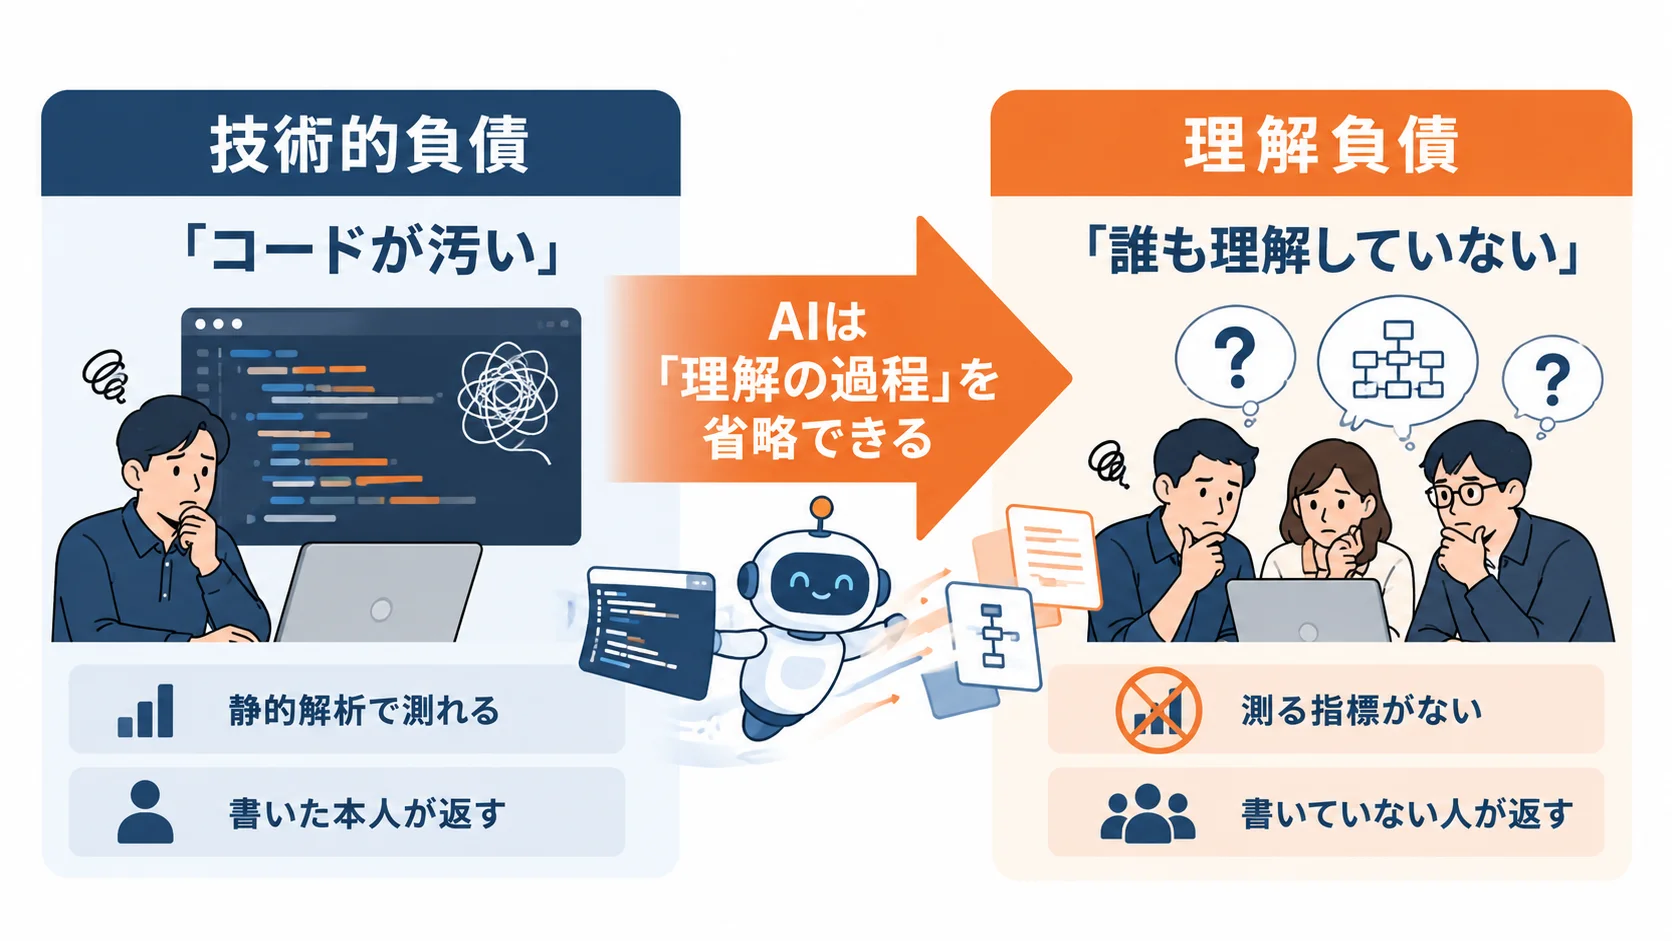
技術的負債との違いは、一行でまとめられます。
| 技術的負債 | 理解負債 | |
|---|---|---|
| 何が悪いのか | コードが汚い・設計が古い | コードは綺麗だが、誰も理解していない |
| 見つけ方 | 静的解析・コードメトリクスで測れる | 測る指標がなく、人に聞くまで分からない |
| 発生する瞬間 | 急いで妥協した実装をマージしたとき | 理解しないまま「動いたのでOK」としたとき |
| 返済する人 | たいてい書いた本人かチーム | 書いていない誰か |
| 従来からの変化 | AI以前から存在 | AIが「理解の過程」を省略できるようにして急増 |
ここが厄介なところです。技術的負債は、見れば分かります。関数が500行ある、テストがない、同じロジックが7箇所にコピーされている——指標で検出できるので、返済計画も立てられます。
理解負債は違います。コードは整っていて、命名も自然で、テストまで付いている。静的解析も通ります。それでも「なぜこうなっているか」を答えられる人がいない。レビューの場で質問が出て、初めて帳簿に載っていない借金が見つかります。
@ITが引用しているCodeRabbitの2025年の調査が、この差を数字で裏づけています。AIが生成したコードのレビューでは、人間が書いたコードと比べて検出された問題が約1.7倍——AIコードで10.83個、人間のコードで6.45個だったといいます。@ITはMIT Media Labの研究も引いており、ChatGPT使用者の83%が出力の正確性を十分に検証できないと回答したとされています。
つまり、問題はコードの品質そのものよりも、検証されないまま通過する量にあります。私たちの実感とも一致します。AIが書いたコードで事故になるのは、たいてい「読まずに通したところ」であって、「読んで妥協したところ」ではありません。
なぜ「速く書けるのに遅くなる」のか——請求書は後から、別の人に届く
このセクションで言いたいことは一つです。生産性の数字が上がっているのに体感が遅いのは、錯覚ではありません。
有名な実測があります。METRのランダム化比較試験です。2025年に実施されました。大規模なオープンソースリポジトリで日常的に開発している熟練開発者16名に、実際の課題246件を割り当て、AIツールの使用を許可する群と許可しない群にランダムに分けました。
結果は、開発者自身の感覚とは逆でした。METRの報告では、事前の予測は24%の高速化、作業後の自己評価も20%の高速化。ところが実測では19%遅くなっていたのです。遅延の主因は、生成された出力をレビューして統合する手間だったと報告されています。
誤解のないように申し上げると、この研究をそのまま2026年の現在に当てはめるのは乱暴です。METR自身が、この結果は歴史的なものであり、現在のAIツールや開発者のワークフローを反映するとは限らないと注記しています。使われたのはCursor ProとClaude 3.5/3.7 Sonnetの時代の組み合わせで、エージェントの自律性も今とは違います。私たちの現場でも、同じ条件で19%遅くなるとは考えていません。
それでも、この研究が捉えた構造は今も残っています。書く時間は短縮され、理解する時間は誰かのところへ移動するという構造です。
ここが経営の視点で見たときの核心になります。コードを書いた人の工数は確かに減ります。削減は実測できるので、報告もしやすい。一方で、増えたコストはレビュワー・障害対応・引き継ぎ・次の担当者に分散して現れます。しかもすぐには現れません。
ある重工・製鋼メーカーのシステムグループマネージャーによると、この非対称性は社内発表の場で別の形で現れたそうです。「開発にAIを入れてコールを30%削減しました、とQC発表で報告したが、全然評価が悪くて、あまり響かなかった。どうやってやっていいのかな、と思う」。削減した数字は出せるのに、社内に響かない。周囲が、どこかで増えたコストを体感しているからだと私たちは見ています。
負債は3種類ある——理解・認知・意図
日本語の議論は今のところ理解負債と認知負債の2つで止まっていますが、研究のほうは一歩先に進んでいます。
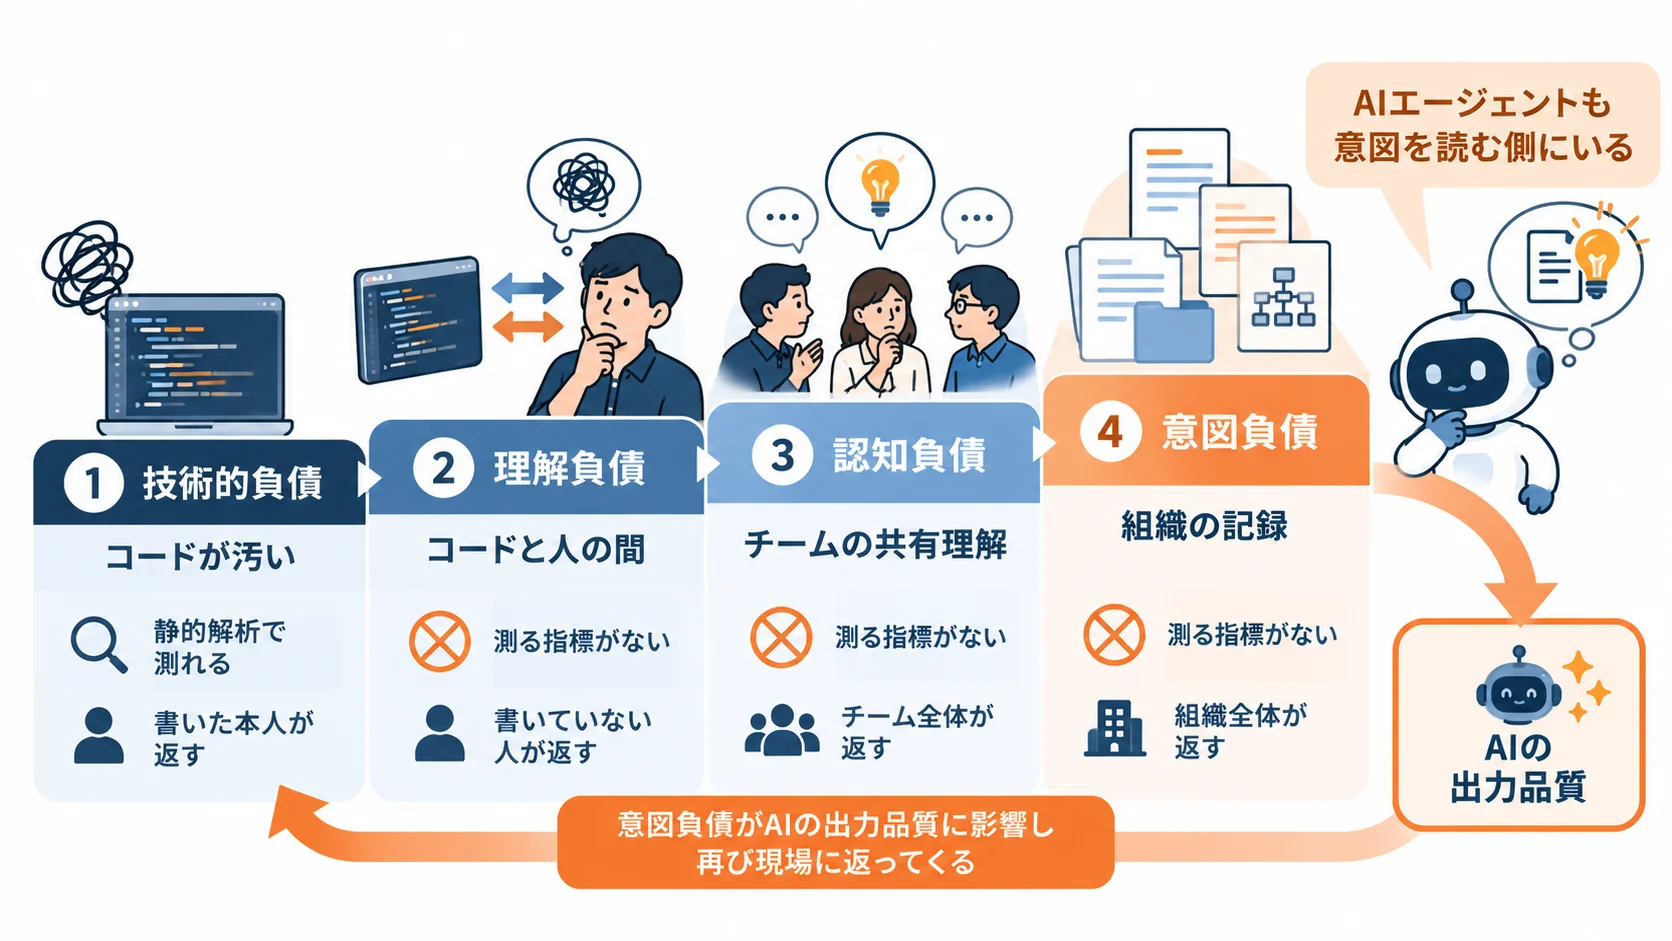
ソフトウェア工学の研究者 Margaret-Anne Storey が2026年3月に論文を発表しました。「From Technical Debt to Cognitive and Intent Debt」。AI時代のソフトウェアの健全性を、3つの負債で捉え直す内容です。ここで出てくる3つ目が、意図負債(Intent Debt) です。
論文は意図負債を、「開発者とAIエージェントがコードと安全に作業するために必要な、外部化された根拠の欠落」と説明しています。設計の目標・制約・判断理由が、どこにも書き残されていない状態です。
3つを並べると、自社の現状がどの段階にあるかが見えます。
| 負債 | どこに溜まるか | 症状 | 払う方法 |
|---|---|---|---|
| 技術的負債 | コードの中 | 変更すると壊れる | リファクタリング |
| 理解負債 | コードと人の理解のあいだ | 動いているが誰も説明できない | 読む・検証する・文書化する |
| 認知負債 | チームの共有理解 | 全体像を描ける人がいなくなる | 設計の議論を人間がやり直す |
| 意図負債 | 組織の記録 | 「なぜそう決めたか」が残っていない | 判断理由を外部化して残す |
Storey の論文が認知負債を「チーム全体における共有理解の喪失」というチームレベルの性質として定義しているところに、私たちは注目しました。個人のスキル問題ではなく、組織の問題だという整理です。
そして意図負債は、さらにその先にあります。ここで決定的に重要なのは、AIエージェントもまた意図を必要とする読み手であるという点です。根拠が残っていなければ、次に入るエージェントもまた、意図の分からないコードに対して推測で手を入れます。人の理解負債が、AIの出力の品質に直接跳ね返る。この循環が、AI内製化を進めた会社で起きている詰まりの正体だと私たちは考えています。
請求書は誰に届くか——理解負債を会社の勘定に載せる
ここまでは技術の話に見えるかもしれません。ここからは、経営の勘定の話です。
私たちがお客様と話していて気づいたのは、理解負債の請求書は作った人以外のところに届くということです。実際に届いた先を並べてみます。
- レビュー担当者の工数 — 検出される問題が約1.7倍になるなら、同じ品質を保つにはレビューに1.7倍の目が必要になります。私たちが見てきた範囲では、この工数は増員されないまま特定のベテランに集中します
- 障害対応の時間 — 原因箇所を特定するまでの時間が伸びます。書いた本人も理由を説明できないため、調査が「読み解き」から始まります
- 引き継ぎの失敗 — 異動・退職のタイミングで一気に顕在化します。ドキュメントはあっても、判断理由がないので「なぜこの仕様なのか」が復元できません
- ベンダーへの再発注 — 最終的に、作ったものを外に出して作り直してもらう判断に至ります。内製化で削ったはずのコストが、数年後にまとめて戻ってきます
4番目が一番痛い結末です。内製化の投資効果が、理解負債の返済で消えます。
私たちの現場経験では、これは新しい問題ではなく、Excel時代からあった問題の再発です。 ある合成樹脂・産業資材メーカーの業務部門の課長が、原価表の実情をこう明かしてくれました。「中身は7割くらいブラックボックス化していて、Excelで配信されるので各担当がそれぞれカスタマイズしてしまう。部材を一つ変えるにも全シートのセルを一個一個探して変える。二重で計上していた箇所もあった」。同社の営業部門の課長は、社内で「秘伝のタレ」と呼ばれる工賃表についても語っています。「細かすぎて、どこに何が書いてあってどのケースはどの工賃を使うのかを理解した人じゃないと使えない」。
誰も中身を説明できない資産が、業務の中心で動き続ける。構造は理解負債とまったく同じです。違うのは生成速度だけ。Excelは人の手で10年かけてブラックボックス化しましたが、AIは数週間でそこに到達します。
複数の製造業のお客様から「生産管理は会社ごとの違いが大きく、現場の担当者が脳内で判断していることが多すぎる」「優秀な人材がいなくなると業務が滞る」という声を、繰り返し聞いてきました。AI内製化は、この属人化を解消する手段として期待されています。設計を間違えると、むしろ加速させます。
非エンジニアのVibeCodingが生む「新種の属人化」
ここで一段、話を広げます。理解負債が本当に深刻になるのは、エンジニアの現場ではなく、非エンジニアが作り始めた現場です。
従来の属人化は「ベテランしかシステムを理解していない」という形でした。少なくとも、理解している人は1人いました。AI時代の属人化は形が変わります。作った本人すら中身を把握していない。引き継ぐ相手がいないのではなく、引き継ぐ知識そのものが最初から存在しません。
私たちはVibeCodingで非エンジニアを戦力化することを事業の柱にしているので、この話は自分たちに刺さります。だからこそ率直に書きます。作れるようになることと、会社の資産になることは、別の工程です。
ある化粧品メーカーの内製担当者が、自分でコードを触り始めるときにこう尋ねてきました。「一旦、データベースをがらっと変えちゃうんじゃないかという懸念がある。まず自分で触ってみて、あとは判断してもらう形でどんどん進めても問題ないか」。この不安は正確です。触ってみる段階と、本番の資産にする段階の境目を、本人が感じ取っています。
別の大手化学メーカーで企画業務を統括する立場の方は、全社展開の壁を素朴な疑問の形で語りました。「今使えているのは自分のパソコンの中まで。なぜ他の人のところまで広げられないのかが分からない」。
答えの一部は、理解負債にあります。自分のパソコンの中なら、理解していなくても困りません。他の人に渡した瞬間、理解の所在が問われます。渡せないのは技術の問題ではなく、誰が中身を分かり続けるかを決めていないからです。
私たちが社内で決めた、負債を増やさない4つの線引き
では、どうするか。私たちが自社の開発とお客様の内製支援の両方で実際に使っている線引きを、具体的に4つ挙げます。きれいな理論ではなく、踏み抜いて決めたルールです。
1. データベースは直接いじらせない
非エンジニアがVibeCodingを始めるときの最初の線がここです。私たちはこう伝えています。「最初はデータベースをいじらないものに留めた方がいい。DBをいじると、もう後戻りできない。自分のブランチをどんだけ汚そうが、DBさえ直接いじらなければ大丈夫」。
理解負債の怖さは、取り返しがつくかどうかで変わります。コードは読み直せます。消えたデータは読み直せません。先に「後戻りできる領域」を囲ってから自由にやってもらう。順番が逆だと事故になります。
2. main に直接マージさせず、PRを経由させる
2つ目は、AIに最初の読み手をやらせる仕組みです。「メインに直接マージせず、まずPRを上げる。PRを上げるとAIが中身を確認してレビューし、妥当性を判断してくれる」。
ここで効くのは、作った本人とは別の文脈を持つレビュワーを1人、機械的に挟むという点です。理解負債は「読まずに通ったところ」に溜まるので、読む工程を人の意志に任せず、仕組みで強制します。ただし、自分の答案を自分で採点させては意味が薄い。性質の異なるモデルに役割を分けて検証させる考え方は、敵対的検証の記事で詳しくお伝えしています。
3. 「完了」の定義を、動くところまで引き上げる
3つ目が、一番効きました。私たちは社内の完了の定義を「実装した」ではなく、「配線されている」かつ「実際に呼び出して動く」かつ「UIの動線から到達できる」 の3条件で定めています。APIだけ作った状態、画面の骨組みだけの状態、モックで動いているように見える状態は、すべて未完了として扱います。
理解負債の観点で、これは効率の話ではありません。到達できない機能には誰も触らないので、理解されないまま残ります。使われない機能ほど危険な負債になる、という経験則です。
4. 自動テストは機械に、受け入れテストは人に
4つ目は役割分担です。単体テスト(Vitest)とシナリオテスト(Playwright)は自動化します。一方、ユーザー受け入れテスト(UAT)は人が触ってダメ出しする工程として残しています。AIはUXの観点が苦手で、VibeCodingで起こりがちな「謎の項目が勝手に増える」事故は、UATでしか止まりません。
本番反映も二段階です。「本番をいきなりいじるとユーザーが急に変わったとなる。先にステージングで直して回帰テストが通ってから本番に出す。トレーニング環境は背景を黄色にして、ひと目で本番と区別できるようにする」。背景色の話は地味ですが、現場では一番効いた工夫の一つでした。
この4つを回した結果として、社内の計測によると、経理システムのテストカバレッジは実測99%台、議事録プロダクトでは自動テスト2,000件超が全通過する状態を維持しています。数字を自慢したいわけではありません。理解負債を抑える仕組みは、品質の数字として観測できるとお伝えしたいのです。
意図を外部化する——「なぜそう決めたか」を会社の資産にする
4つの線引きは理解負債を抑えます。ただ、意図負債には届きません。意図負債を返すには、記録の設計が必要です。
Issueは「管理しやすい単位」で切る
AIに議事録から課題を自動起票させると、効率は上がります。そして意図は消えます。私たちはこの失敗をしました。「AIで議事録から丸めて起票すると、全部自分の名前になる。丸まっていると何が本当に残っているか分からなくなるので、管理しやすい単位でIssueを切る。順番に検証しないと、ここは直ったがここは直っていない、という漏れが起きる」。
粒度は効率のための設定ではなく、意図を保存できる最小単位として決めるものだと考えています。
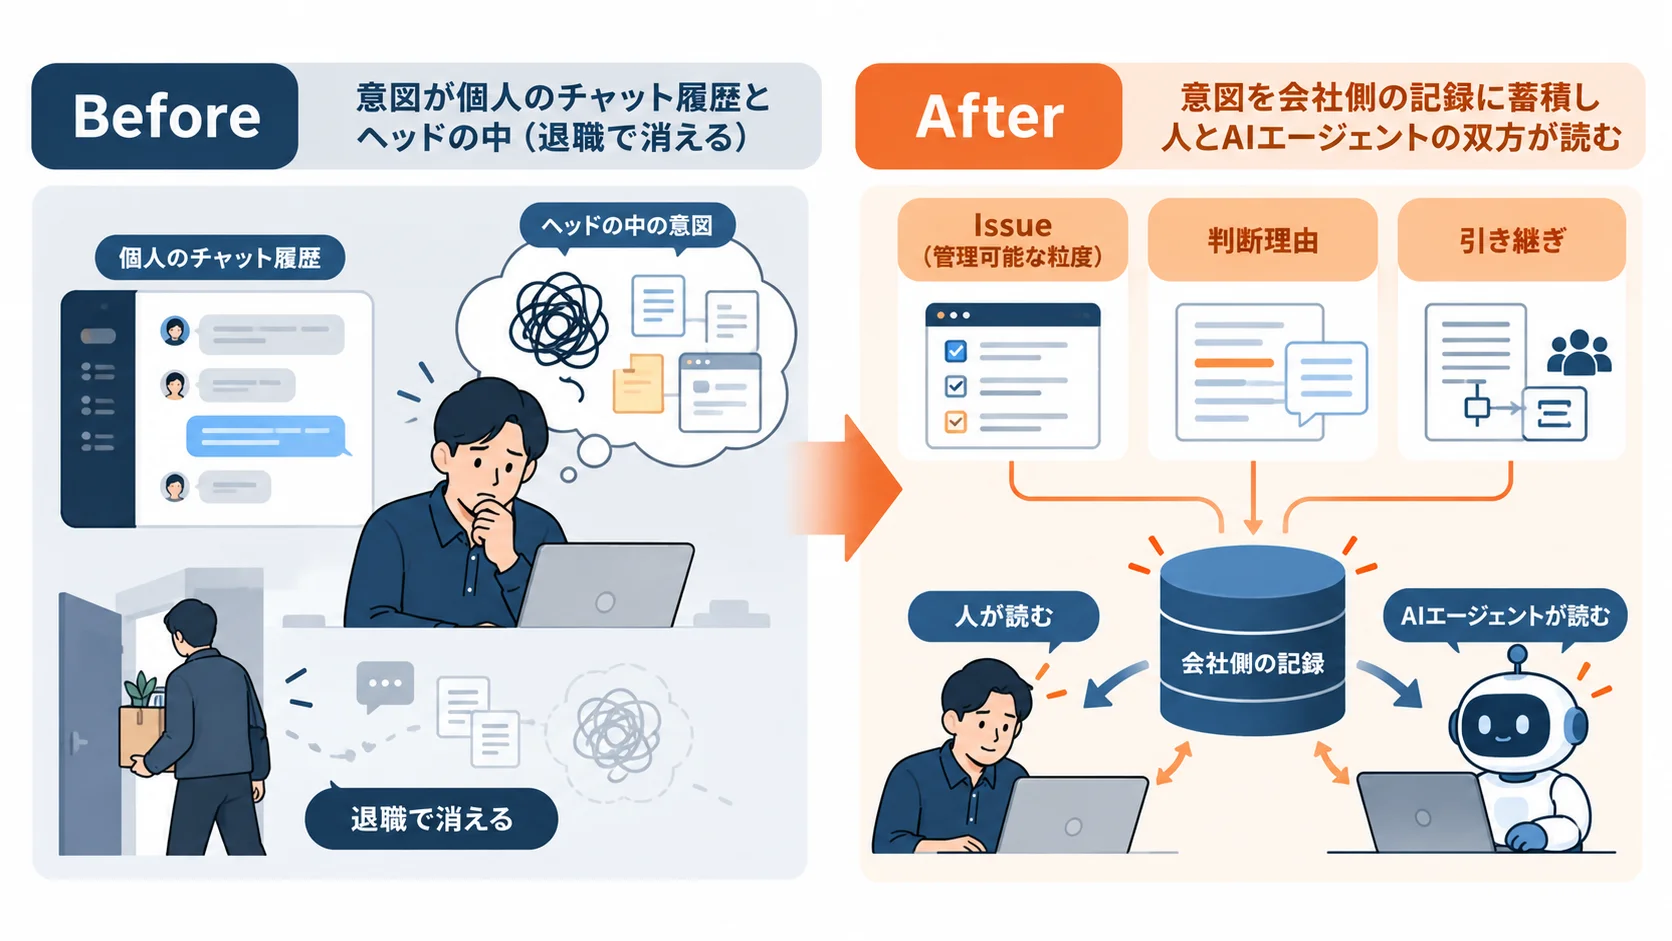
判断理由と引き継ぎを、会社側に蓄積する
私たちは自社プロダクトのSibylを、この用途に使っています。AIとの対話・業務判断・ナレッジ・タスク・改善履歴を横断して蓄積する「会社のBrain」として設計したもので、セッションの記録や引き継ぎ、判断理由を会社の記憶に変換する役割を担います。
重要なのは製品かどうかではありません。判断理由の置き場所が、個人のチャット履歴ではなく会社側にあるかという点です。個人のAI対話履歴に意図が残っている状態は、意図負債がゼロではなく、個人の端末に保管されているだけ。退職と同時に全額が貸し倒れます。
AIには意図を渡し続ける
もう一つ、現場で効いている考え方があります。「AIは信用するのではなく、こちらの考えをぶつけ、前提情報や意図を渡し続けることで深い対話が生まれる」。AIは相手を見て会話するので、表向きの情報しか渡さなければ表向きの回答しか返ってきません。
意図を外部化することは、引き継ぎのためだけではないのです。次に入るAIエージェントの出力品質を直接左右します。Storey の論文が意図負債を「開発者とAIエージェントが安全に作業するために必要な根拠の欠落」と定義していたのは、まさにこの双方向の効果を指しています。
自社の理解負債を測る7つの質問
指標がないものは測れません。ただ、兆候は質問で拾えます。私たちがお客様の現場で実際に使っている確認項目を挙げます。
- 直近3か月にマージされたコードのうち、仕様の理由を即答できる人がいる割合はどれくらいか。
- AIが生成した変更を、別の文脈を持つ誰か(人またはAI)が読む工程になっているか。
- 「動いたのでOK」でマージされたものが、本番の動線から実際に使われているか。
- 作った担当者が異動したとき、引き継ぎ先が調査なしで変更できるか。
- 設計の判断理由が、個人のチャット履歴ではなく会社側の記録に残っているか。
- Issueの粒度は、「何が直っていて何が残っているか」が追える単位になっているか。
- データベースを直接変更できる人の範囲を、意図して狭めているか。
4項目以上で「いいえ」が付く場合、負債は既に積まれていると見ていいと思います。ここは意見が分かれるところですが、私たちは3番と5番を最優先で直すことを勧めています。使われていない機能と、残っていない理由。この2つが後の返済額を最も膨らませます。
内製と外注の線引きは「作る」ではなく「分かり続ける」で決める
最後に、投資判断の話をします。AI内製化の検討では「どこまで自社でやるか」が論点になりますが、私たちは問いの立て方を変えることを勧めています。
作れるかどうかではなく、理解を持ち続けるのは誰かで切る。 比較するとこうなります。
| 完全内製 | 伴走型(FDE) | 丸投げ外注 | |
|---|---|---|---|
| 作る速度 | 速い(AI次第) | 速い | 遅い |
| 理解の所在 | 自社だが、個人に偏る | 自社に移す工程を設計に含める | ベンダー側——社内には残らない |
| 理解負債のリスク | 高い——線引きがないと急速に溜まる | 中——レビューと記録を仕組みで回す | 低いが、意図負債は最大化する |
| 向いているケース | 社内に設計を読める人がいる | 内製化を進めたいが線引きが未整備 | 自社で持つ必要のない周辺領域 |
丸投げ外注の欄に注目してください。理解負債は発生しにくいのに、意図負債は最大になります。「なぜそう作ったか」が社外にしか残らないからです。ある大手化学メーカーで企画業務を統括する立場の方は、2027年稼働予定の基幹刷新について、自分でも進捗を見ていて手応えがないと率直に述べたうえで、「でも、もう後戻りできない」と漏らしていました。要件は固めたものの、あとはどうにでもしてくれという状態だと。
これは意図負債が満額まで積まれた状態です。そして返済手段がありません。
私たちがFDEとして現場に入るとき、最初に設計するのは機能ではなく、理解の受け渡し方です。 月次定例で技術顧問として伴走し、現場からのフィードバックはIssueとして登録して翌週にはプロトタイプを持っていく。マニュアルを作って勉強会で技術移転する。ある化粧品メーカーでは、顧客の内製担当者への開発ガードレール指導(DBは直接触らず、PRベースで進める)を開発と並走させました。
誤解のないように申し上げると、コンサルやSIerが悪いわけではありません。役割が違うだけです。ただ、理解負債と意図負債という勘定を見たとき、報告書を納品するモデルでは返済まで面倒を見きれない。私たちはそう考えて、現場で本番コードを書く形を選んでいます。
よくある質問
Q1. 理解負債は、AIを使わなければ発生しないのですか
発生します。他人が書いたコードを引き継ぐ場面でも、ドキュメントのないレガシーシステムでも、同じ構造の負債は昔からありました。AIが変えたのは速度です。理解の過程を省略したまま大量のコードを通せるようになったため、Excel時代なら10年かかったブラックボックス化が、数週間で起きます。AIの問題ではなく、検証の工程が速度に追いついていない問題として捉えるほうが対策が立てやすいと考えています。
Q2. ドキュメントをAIに自動生成させれば解決しませんか
半分は解決します。「何をしているコードか」の説明はAIが十分な精度で書けるので、理解負債の一部は目に見えて軽くなります。ただ、意図負債には効きません。「なぜ別の選択肢を却下したか」「どの制約があってこの仕様になったか」は、コードの中に存在しないため、生成では復元できないからです。AIに書かせるべきは説明で、人が残すべきは判断理由。この切り分けを前提にすると、ドキュメント生成の投資効果が読めるようになります。
Q3. 非エンジニアにVibeCodingをやらせるのは、やはり危険でしょうか
線引きをしないまま本番データに触れさせるのは危険です。逆に、データベースを直接いじらせない・mainに直接マージさせない、というたった2つの線を引くだけで、取り返しのつく範囲に収まります。私たちは非エンジニアの戦力化を事業の柱にしていますが、それは「自由にやらせる」ことではなく「後戻りできる範囲を先に設計する」ことで成り立っています。この線引きの詳細は非エンジニアのガードレールの記事でお伝えしています。
Q4. 理解負債を数値で経営層に説明するには、どうすればよいですか
削減した工数だけを報告すると響きません。増えた側を同時に出すのが現実的です。具体的には、レビューに費やした時間の推移、障害の原因特定までにかかった時間、引き継ぎ時に調査が必要だった案件の割合——この3つを並べると、投資判断の材料になります。私たちがお客様と最初にやるのも、この「増えた側」の棚卸しです。削減額だけの報告が社内で評価されなかったという声は、複数の製造業から聞いています。
Q5. もう負債が溜まってしまった場合、どこから手を付けるべきですか
全部を読み直す方向には進めないほうがいいと思います。私たちが勧める順番は、まず本番の動線から実際に使われている機能を特定し、その範囲だけに理解を集中させることです。使われていない機能は、理解するのではなく消す判断のほうが安く済みます。そのうえで、今後の変更分に対して「別の読み手を挟む」工程を入れる。過去の全額返済ではなく、新規の借り入れを止めることから始めるのが現実的でした。
まず試すなら
- 直近3か月にマージされた変更を10件だけ抜き出し、「仕様の理由を即答できる人がいるか」を社内で確認してみる。4件以上で答えが出なければ、負債は既に積まれています。
- mainへの直接マージを止め、PRを経由させる。そのうえで、作ったAIとは別系統のAIに最初の読み手をやらせる工程を1つ加えてみる。
- どの業務のどこに理解負債が溜まっているか、内製と伴走の線をどこで引くべきかを、無償の業務プロセス診断(BPR)で一緒に棚卸しする。
3番については、ヒアリングから業務フロー・改善案・ROIのたたき台までを可視化したうえで、「この業務は内製で持つべきか、理解の受け渡しを設計すべきか」までお出しします。AI内製化を進めている途中の会社ほど、棚卸しの効果が出ます。
参考リンク
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム

Claude Codeのエフォートと上限——Opus 5.5で既定がmediumになった今の使い分け
Opus 5.5でClaude Codeのエフォート既定値がhighからmediumに下がり、9月には週の利用上限の見直しや5時間上限の停止処理も変わりました。low〜maxで何が変わるのか、作業別の使い分け、上限を本当に食っているものの見つけ方を、公式ドキュメントと私たちの運用からお伝えします。

Claude Codeのファイル削除事故——rm -rf禁止でも4万8000件が消えた理由とauto モード時代の防ぎ方
Claude Codeのエージェントが103秒で4万8,218ファイルを消した事故が報告されました。削除コマンドを禁止していても止まらなかった理由と、auto モードが既定になった今、削除事故をどう防ぐかを、公式ドキュメントと私たちの現場の運用からお伝えします。

AIエージェントに渡す『鍵』をどう守るか——VibeCoding内製化のシークレット管理・APIキー管理
機密データを見せない、繋ぎ先のMCPを信頼する——ここまでお伝えしてきました。今回はその両方の土台にある「渡す鍵そのもの」の話です。APIキーをどこに置き、どう失効させるかという地味な設計が、実は事故の分かれ目になります。