Claude Codeのエフォートと上限——Opus 5.5で既定がmediumになった今の使い分け

作業量は先週と変わらないのに、週の半ばで上限が尽きる。2026年9月、Claude Codeを使う開発者のあいだで、こうした声が一気に増えました。同じ月には、Opus 5.5の登場でエフォートの既定値がhighからmediumに下がり、週の利用上限の見直しも入っています。「エフォートを上げれば安心」「上限はとにかく節約」という感覚のままでは、設定の意味を取り違えかねません。この記事では、エフォートの段階ごとに何が変わるのか、作業別にどう選ぶか、上限を本当に食っているものをどう見つけるかを整理します。私たちAI-Pathが複数のエージェントを並行で動かす中で決めてきた運用も、あわせてお伝えします。
- 019月に起きた3つの変化——「前と同じ使い方」が通用しなくなった
- 02エフォートとは何か——賢さのつまみではなく「どこまで確かめるか」
- 03low〜maxで何が変わるのか——正解率ではなく、確かめ方の手間
- 04作業別の使い分け——「どれだけ任せるか」で決める
- 05設定の落とし穴——「一度きり」と「既定値」を混ぜない
- 06上限を食うのは、エフォートより「会話の長さ」だった
- 075時間枠と週枠は「別の財布」として扱う
- 08/usageで「何が食っているか」を見る
- 09チームで使うときに、先に決めておくこと
- 10私たちの現場で決めてきた運用
- 11私たちの見解: エフォートは「品質の設定」ではなく「委任の設定」
- 12よくある質問
- 13まず試すなら
- 14参考リンク
9月に起きた3つの変化——「前と同じ使い方」が通用しなくなった
最初に、この1か月で何が変わったのかを時系列で押さえておきます。どれも単独では小さな変更ですが、重なると体感が大きく変わりました。
1つ目は、週の利用上限です。BleepingComputerの報道によれば、9月14日に一時的な上乗せが終わりました。週上限は「元の150%」から、恒久的な「元の125%」に切り替わっています。Anthropic自身が「直前と比べると17%の削減になる」と認めています。夏のあいだに上乗せ後の枠に慣れていた人ほど、減ったと感じたはずです。
2つ目が、9月22日のOpus 5.5の公開です。gihyo.jpのまとめによると、APIの単価はOpus 5より入出力とも20%下がりました。サブスクリプションの利用枠も約25%長持ちするとされています。そしてClaude Codeでのエフォートの既定値が、Opus 5のhighからmediumへ変わりました。
3つ目は9月25日の変更です。5時間の利用上限に作業の途中で達したとき、Claude Codeが区切りのよいところまで進めてから止まるようになりました。仕上げに使う少量の枠は、週の上限から差し引かれます。Proでは週1回、MaxとTeam Premiumでは毎回この処理が使えるとされています。
つまり、枠は一度減り、モデルは安くなり、既定の「考える量」は下がった。この3つが1か月のあいだに同時に動いています。先週までの感覚で「なんとなく減りが早い」と感じるのは、自然な反応です。
エフォートとは何か——賢さのつまみではなく「どこまで確かめるか」
エフォートは、モデルを賢くしたり愚かにしたりするつまみではありません。1つの作業にどれだけ計算量を使ってよいかの目安です。
「Claude Code エフォート」で調べると設定手順の解説が多く出てきますが、まず仕組みから押さえます。Claude Codeの公式ドキュメント(末尾の参考リンク)によれば、Opus 5.5とSonnet 5.5のエフォートは5段階です。low・medium・high・xhigh・maxの順に、考える量が増えていきます。既定値はどちらもmediumで、「ほとんどのコーディング作業に向く」と書かれています。各段階の想定用途は次のとおりです。
| 段階 | 公式ドキュメントが想定する用途 |
|---|---|
| low | 結果を毎回見ながら進める短いやり取り。アイデア出し、たたき台、名前の変更などの小さな修正 |
| medium | 範囲がはっきりした日々の開発。新しい機能の実装など |
| high | 検証が効いてくる作業や、想定外のケースが出やすい作業。既存コードのバグ修正など |
| xhigh | より深い推論。トークンの消費は増える |
| max | 人が付き添わずに任せたい難しい問題。脆弱性の調査など。ただし効果が頭打ちになり、考えすぎることがある |
注意したいのは、Opus 5.5では思考そのものを切れないことです。公式ドキュメントにも、Opus 5.5・Sonnet 5.5・Fableの各モデルは常に拡張思考を使うと明記されています。思考のトークンは出力として数えられます。考える量を減らしたければ、エフォートを下げるほかありません。
誤解のないように言えば、mediumへの変更は「手を抜くようになった」という話ではありません。Anthropicは、Opus 5.5のmediumはOpus 5のhighと同等以上の評価だと説明しています。既定値が下がったのは、同じ品質をより少ない思考で出せるようになったからです。
low〜maxで何が変わるのか——正解率ではなく、確かめ方の手間
では、段階を変えると実際に何が変わるのか。これを確かめた実測が、Zennに公開された検証記事「そもそもClaude Codeのエフォートってなに?」です。
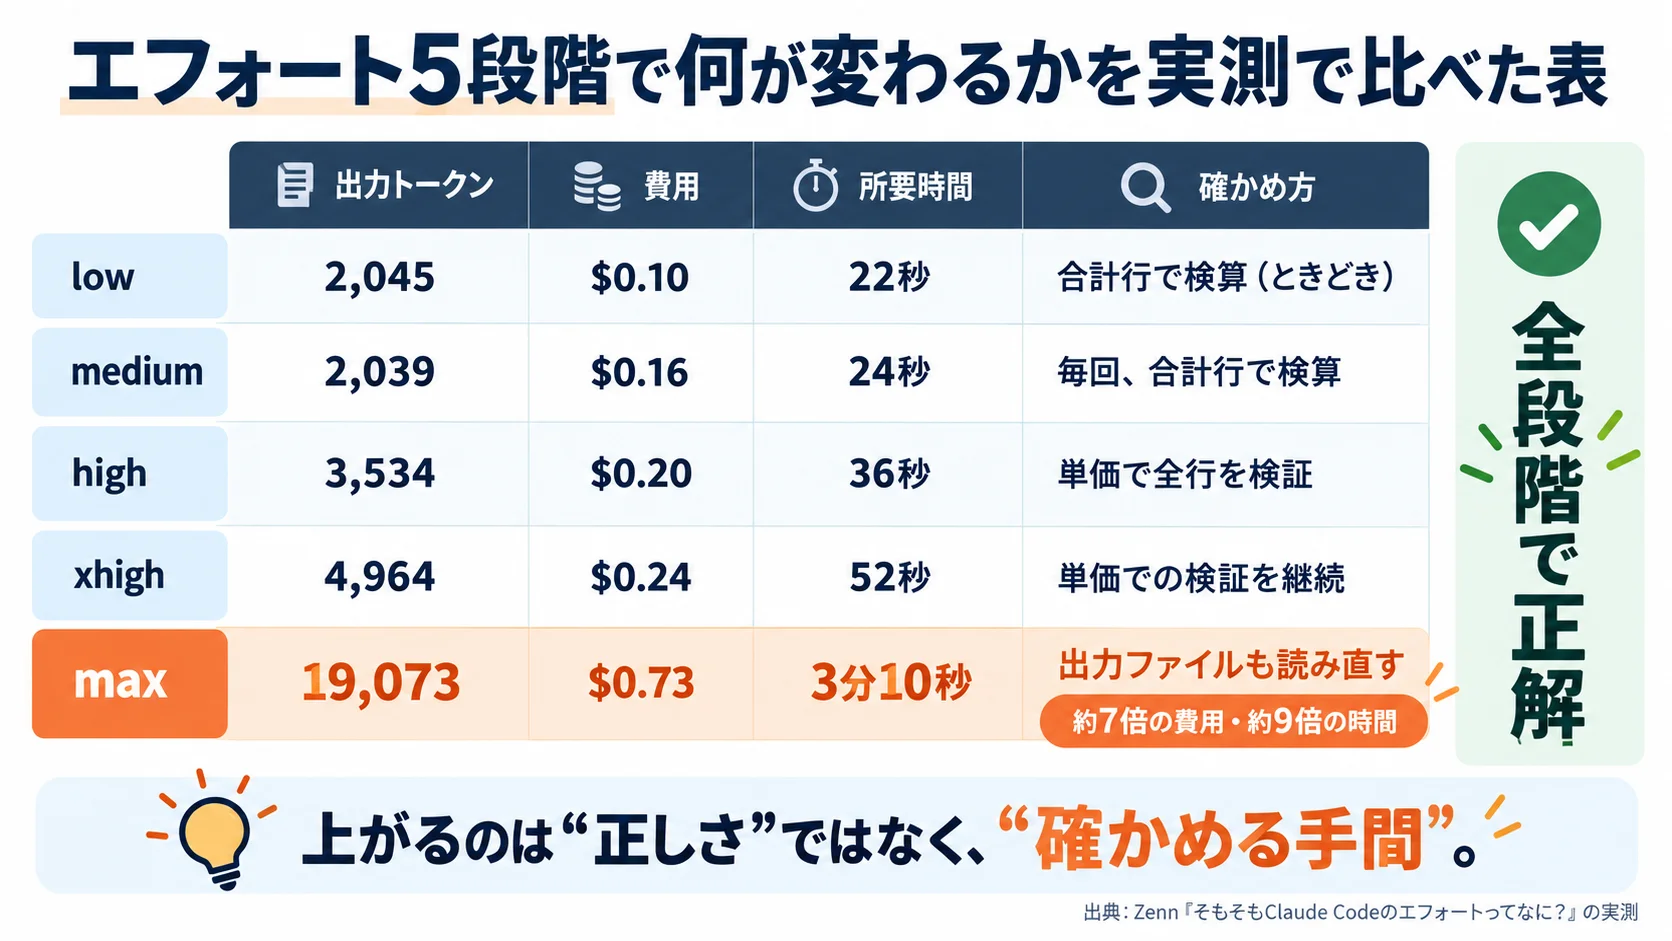
筆者は、文字コードや金額の書き方がばらばらな3つのCSVから、商品別の売上を集計させました。同じ課題を5段階それぞれで解かせた結果が次の数字です。
| 段階 | 出力トークン | 費用 | 所要時間 |
|---|---|---|---|
| low | 2,045 | $0.10 | 22秒 |
| medium | 2,039 | $0.16 | 24秒 |
| high | 3,534 | $0.20 | 36秒 |
| xhigh | 4,964 | $0.24 | 52秒 |
| max | 19,073 | $0.73 | 3分10秒 |
驚くのは、どの段階でも答えが正しかったことです。違ったのは確かめ方でした。lowは合計行で1回検算するだけのこともあり、highになると単価を使って全行を検証しています。maxは書き出したファイルを読み直す手順まで加えていました。
時差のある会議予定を日本時間に直す2つ目の課題でも、傾向は同じです。lowは1,006トークン・12秒で終わりました。maxは25,343トークン・3分54秒をかけ、夏時間のルールをWebで確かめています。答えはどちらも合っていました。
この結果は、私たちの実感ともよく一致します。エフォートを上げて増えるのは「正しさ」そのものより、「正しいことを確かめる手間」です。課題が単純で、確かめる価値が低ければ、上げたぶんはそのまま費用と待ち時間になります。
作業別の使い分け——「どれだけ任せるか」で決める
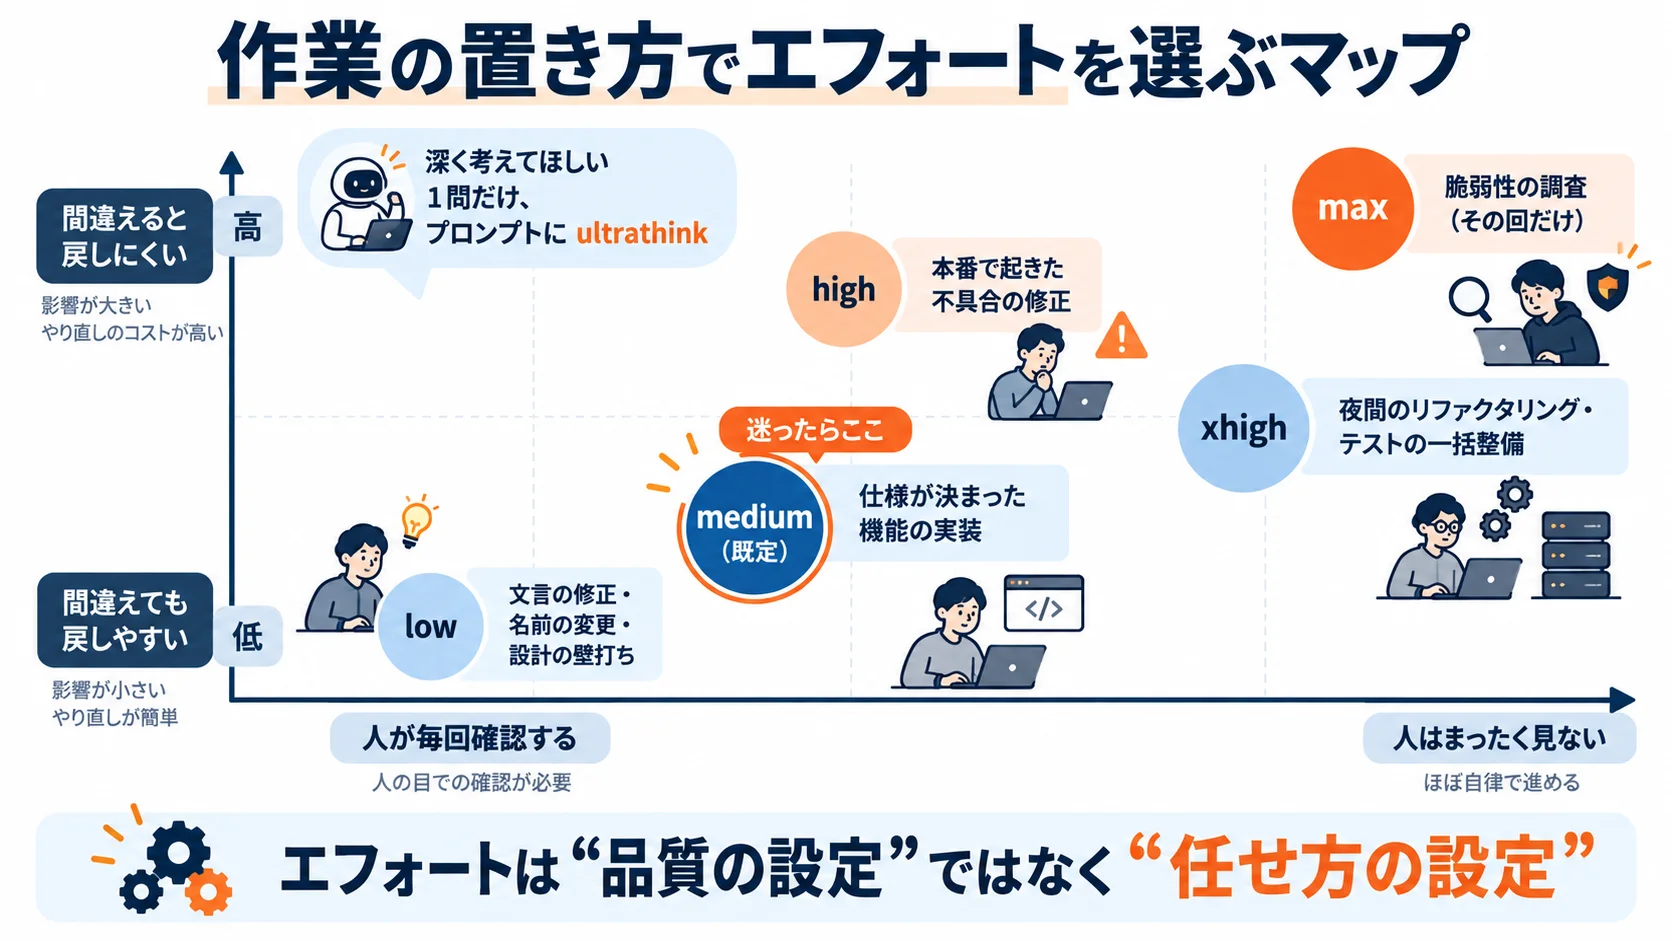
エフォートは、作業の難しさより「人がどれだけ付き添うか」で選ぶほうが外しにくいと私たちは考えています。
検証記事の筆者が引用していた、ある開発者の言葉がわかりやすいものでした。横で見ていたいならlow、完全に任せきりにするならmax。人が毎回の結果を確かめるなら、AIに何度も検算させる必要はありません。逆に誰も見ないなら、確かめる役をAIに寄せることになります。
私たちが社内で使っている目安は、次のようなものです。
| 作業の置き方 | エフォート | 例 |
|---|---|---|
| 人が1手ずつ確認する | low | 画面文言の修正、変数名の変更、設計の壁打ち |
| 範囲が決まった実装を任せる | medium(既定) | 仕様が固まった画面の追加、APIの項目追加 |
| 既存の動きを壊せない修正 | high | 本番で起きた不具合の修正、他の機能に影響する改修 |
| 夜間など人が見ない長い作業 | xhigh | 大きめのリファクタリング、テストの一括整備 |
| 見落としが許されない調査 | max(その回だけ) | 権限まわりの抜けの洗い出し、脆弱性の調査 |
表の中で、私たちがいちばん意識しているのはhighの行です。既存のコードを直す作業は、見えている不具合を直した結果、見えていない場所を壊しやすい。ここだけは、AIに自分で確かめる手間をかけさせたほうが、あとの手戻りを減らせると考えています。
もうひとつ、1回だけ深く考えさせたいときは、エフォートを変えずにプロンプトへ「ultrathink」と書く方法があります。公式ドキュメントによれば、その回だけより深い推論を求められ、セッションの設定は変わりません。普段はmediumのまま、詰まった設計判断の1問だけultrathinkを付ける。この使い方が、上限にもいちばん優しいと感じています。
設定の落とし穴——「一度きり」と「既定値」を混ぜない
エフォートは設定する場所が複数あり、どれが効いているのかを見失いやすい項目です。公式ドキュメントに沿って、よく使うものを整理します。
- その場で変える:
/effort highのように段階を指定するか、/effortでスライダーを開く - このセッションだけ変える: スライダーで
sを押す(v2.1.257以降) - モデルごとの既定値:
settings.jsonのmodelSettingsにモデル名と段階を書く - 環境全体に効かせる: 環境変数
CLAUDE_CODE_EFFORT_LEVEL - スキルやサブエージェント単位: 各ファイルの先頭に
effort: highと書く
{
  "modelSettings": {
    "claude-opus-5-5": { "effort": "medium" }
  }
}
ここで落とし穴が2つあります。1つ目は、スライダーでEnterを押すと、その段階が既定値として保存されることです。「この1件だけhighにしたい」と思ってEnterで確定すると、翌日以降のセッションもhighで始まります。一時的に変えるなら s を使う、と覚えておくと安全でした。
2つ目は、settings.json の最上位に書く effortLevel が、Opus 5.5とSonnet 5.5には効かないことです。以前のモデルで既定値を固定していた設定は、Opus 5.5に切り替えた時点で素通りになります。「highに固定しているはずなのに挙動が軽い」と感じたら、まずここを疑ってください。
なお、maxは既定値として保存できません。環境変数で指定しない限り、そのセッション限りで効きます。「誰かが一度maxにしたせいで全員の上限が溶けた」という事故は、仕組みの上では起きにくくなっています。
上限を食うのは、エフォートより「会話の長さ」だった
エフォートを下げても上限の減りが変わらない。そう感じる場合、原因は別のところにあることがほとんどです。
「Claude Code 上限」「Claude Code 使用量」で検索すると節約術の記事が並びます。中でも、TOKIUMの開発者が書いた利用上限の検証記事は、原因を丁寧に解き明かしています。エージェントはツールを1回使うたびに、それまでの会話をすべて送り直します。序盤に読んだ7,000トークンのファイルも、その後の全リクエストに毎回含まれる。100回続けば、70万トークン分の送信です。キャッシュが効いても利用量はゼロになりません。筆者の手元のログでは、消費の3分の2がキャッシュの読み込みから出ていたといいます。
この指摘は、公式のコスト管理ドキュメントの説明とも一致します。一日中開いたままのセッションでは、1行の質問でも会話全体ぶんの利用量がかかる、と明記されています。さらにキャッシュには寿命があります。サブスクリプションでは1時間、追加使用のクレジットを使い始めると5分に縮みます。昼休みを挟んで同じセッションを再開すると、最初の1通で全文を処理し直すことになります。
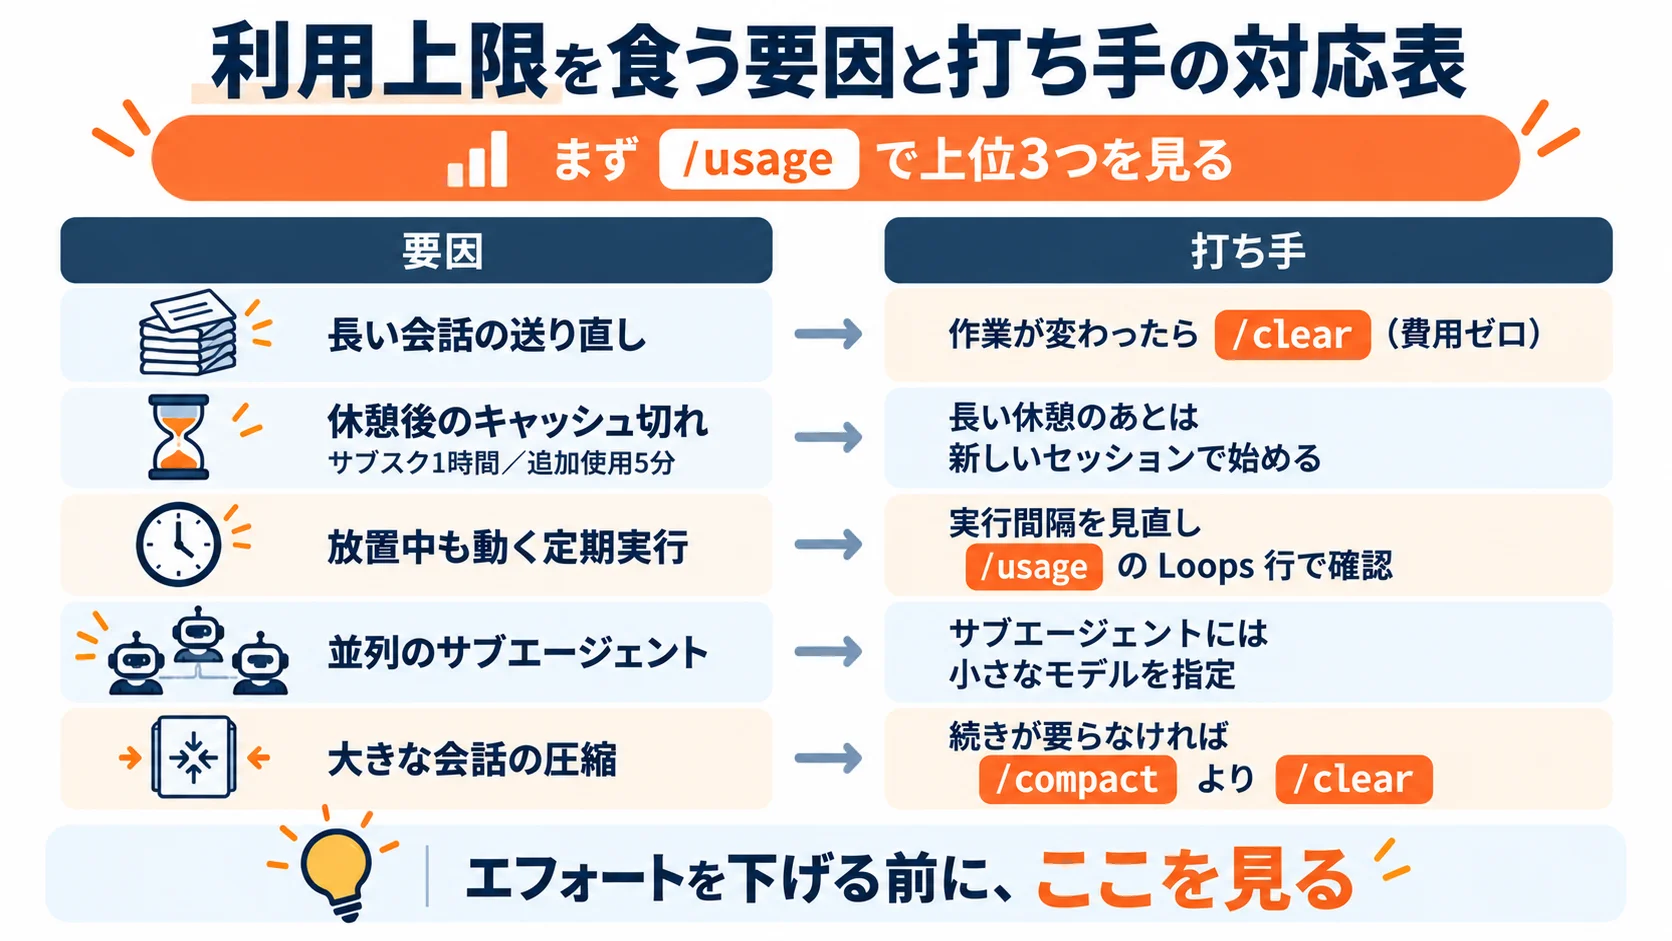
ドキュメントが「長いセッションで利用量が膨らむ理由」として挙げているのは、次のようなものです。
- 長い会話を毎回まるごと送り直している
- 休憩のあとでキャッシュが切れ、全文を読み直している
- 定期実行のタスクが、放置中のセッションでも全文を送っている
- サブエージェントやワークフローが、本体とは別にリクエストを送っている
/compactによる圧縮そのものが、大きなリクエストになっている
逆に、関係のない作業に移るときの /clear は費用がかからない、とも書かれています。私たちがチームに勧めているのも、「作業が変わったら迷わず/clear」です。必要なら /rename で名前を付けてから消し、あとで /resume で戻れば困りません。
5時間枠と週枠は「別の財布」として扱う
上限の話がややこしいのは、枠が2つ重なっているからです。公式ドキュメントによれば、TeamやEnterpriseの席ごとの枠は、5時間ごとと1週間ごとの2つの窓でリセットされます。しかもこの枠は、チャット版のClaudeやCoworkと共有です。
短時間に作業を詰め込めば5時間の枠に当たります。毎日少しずつ積み上がれば、週の枠に当たる。同じ「上限に達しました」でも、打ち手が違います。5時間枠なら待てば戻りますが、週枠に当たると数日単位で止まってしまいます。
見落としやすいのは、モデルを切り替えても枠は戻らないことです。「セッション上限」「週上限」のメッセージは全モデル共通の枠なので、/model でSonnetに変えても解決しません。「Opusの上限」のようにモデル名が付いたメッセージのときだけ、別の系統のモデルに切り替えれば続けられます。
9月25日の変更で、5時間枠に達したときの止まり方は穏やかになりました。ただ、その仕上げ分は週の枠から引かれます。夕方に5時間枠を毎日使い切る働き方だと、仕上げの分だけ週枠を前借りしていることになる。私たちはこれを「2つの財布を行き来している」状態だと説明しています。
/usageで「何が食っているか」を見る
上限の減りに悩んだら、推測で節約するより先に、/usage を開くのが近道です。
公式ドキュメントによると、Pro・Max・Team・Enterpriseのプランでは、/usage に利用量の内訳が表示されます。スキル・サブエージェント・プラグイン・MCPサーバーごとに、使った割合がわかります。長いコンテキストやキャッシュミスのように、全体の10%以上を占める挙動には警告も付きます。定期実行のタスクは、重いものから順に1行ずつ並ぶ仕組みです。d と w で、直近24時間と7日間を切り替えられます。
ひとつ注意があります。この内訳は、その端末の履歴だけから計算した概算です。別のPCやブラウザのclaude.aiで使った分は入りません。チーム全体の状況を見るなら、管理画面の利用分析や、組織向けのレポートを使うことになります。
実際に開いてみると、想像と違う場所が上位に来ることがあります。並列で動かすサブエージェントや裏で回している定期実行は、本人が手を動かしていない時間にも枠を使うからです。エフォートを1段下げるより、定期実行の間隔を見直すほうが効く場面もあります。
チームで使うときに、先に決めておくこと
Claude Codeを何人かで使い始めたら、個人の工夫に任せず、会社として決めておきたい項目があります。
公式ドキュメントによれば、企業での平均費用は、稼働日1日あたり開発者1人約13ドルです。月にすると150〜250ドルで、90%の利用者は1日30ドル未満に収まっています。裏を返せば、残り10%の使い方が全体の予算を大きく左右します。
| 決めること | なぜ必要か | 最初の一歩 |
|---|---|---|
| 既定のエフォート | 人によってmaxやhighのまま走らせていると、同じ作業でも消費が数倍違う | Opus 5.5はmediumを既定にし、上げるのは作業単位にする |
| 定期実行とバックグラウンド作業 | 本体の作業と同じ枠を黙って食う | 動かしてよい時間帯と間隔を決め、/usageで週1回確認する |
| 並列のエージェント | 1体ごとに別の会話を持つので、体数に比例して増える | サブエージェントには小さなモデルを指定する |
| 上限に当たったときの扱い | 止まったまま待つのか、追加使用で続けるのかが人によって違う | 追加使用の上限額を、組織・グループ・個人のどこで持つか決める |
ここで、私たちがはっきり避けていることがあります。利用量の多さで人を評価することです。消費が多い人は、それだけ多くの作業をAIに任せている人でもあります。量を責めれば、任せる範囲が縮むだけです。見るのは量ではなく、「同じ作業に対して消費が膨らんでいないか」のほうです。
さらに踏み込んだ例として、エムスリーのエンジニアは作業ごとに上限の割合を割り当てる仕組みを作っています。裏で回す監視用のエージェントに「5時間枠の60%まで」と上限を付け、本体の作業が止まらないようにする発想です。ここまで作り込む必要はなくても、「裏の作業に本体の枠を食わせない」という考え方は、どのチームにも役立つはずです。
私たちの現場で決めてきた運用
ここからは、私たち自身がどう回しているかをお話しします。完成形ではありませんが、実際に続けていることです。
私たちは、寝ている間もエージェントに作業を任せ、複数のツールを並行で走らせる働き方をしています。1人が同時に何体ものエージェントを抱える「エージェントマネージャー」のような動き方です。この働き方で、いちばん気を配っているのが上限です。夜間に任せた作業が枠を使い切れば、日中の本番対応が止まりかねません。
そこで決めたのが、次の3つです。
1. 夜間の長い作業と、日中の対話の作業を分けて考える。 夜間に任せる作業は、人が見ない前提なのでエフォートを上げます。その代わり、範囲を1つの課題に絞り、終わったら止まるようにしています。日中の対話はmediumを基本にして、人が確かめる手間とAIが確かめる手間を二重に払わないようにしました。
2. 強いモデルは「審判」に回す。 最初の回答は軽いモデルに出させ、より強いモデルに採点させる。社内ではこの組み立てを、エージェントの作業にも当てはめています。全部を最上位のモデルと高いエフォートで回すより、確かめる役に計算量を寄せるほうが筋がいいと考えています。
3. 作業の記録を残し、あとから消費を振り返る。 私たちは、エージェントとのセッションを記録して解析する仕組みを社内で回しています。その解析の中で、トークンの計上方法も決め直しました。全文の長さでざっくり数える方式では、実際の消費より大きく見積もってしまうためです。実際に読み込んだ量で数える方式に改め、上限の目安も付けています。数え方が正しくないと、どの作業が重いのかという議論が成り立ちません。
正直に言えば、エフォートを上げるほど安心だという感覚は、私たちの中にもありました。先ほどの実測を見て考えを改めたのは、「確かめる手間」を誰が払うのかという視点です。人が見るならAIに二重に確かめさせる必要はなく、人が見ないならAIに確かめさせる。それだけのことでした。
関連して、Opus 5系のモデルへの指示の書き方は、Claude Opus 5で「検証して」が逆効果になる理由で詳しく書いています。並列で動かす働き方については、エージェントマネージャーという働き方もあわせてご覧ください。
私たちの見解: エフォートは「品質の設定」ではなく「委任の設定」
私たちの結論は、エフォートを品質のつまみとして扱うのをやめる、ということです。
エフォートを上げれば良いものができる、という発想は分かりやすい。けれど実測が示したのは、段階を変えても答えの正しさはほとんど変わらず、確かめる手間だけが変わるという事実でした。そうであれば、決めるべきは「どのくらい良いものが欲しいか」ではありません。「どこまで人が付き添い、どこからAIに任せるか」です。
ここは意見が分かれるかもしれませんが、私たちは既定のmediumをそのまま使うことを勧めます。上げる判断は、作業の単位で下すものです。セッション全体や個人の設定でhighを固定すると、確かめる必要のない作業にまで手間を払い続けることになります。その分の上限は、本当に任せたい夜間の長い作業のために取っておく。そのほうが、同じ枠でAIに任せられる仕事の量が増えます。
そして、上限の悩みの多くはエフォートより会話の長さと裏の作業から来ています。設定をいじる前に /usage を開き、何が食っているかを数字で見る。任せる範囲を広げるほど、この「数えてから直す」順番が効いてきます。
よくある質問
Q. Opus 5.5では、エフォートをhighに戻したほうがよいですか。 一律に戻す必要はありません。AnthropicはOpus 5.5のmediumがOpus 5のhighと同等以上だと説明しています。既存コードの不具合修正のように、確かめる価値が高い作業だけ作業単位でhighにするのが効率的です。
Q. エフォートを下げれば、利用上限は長持ちしますか。
思考の量は減るので効果はあります。ただし、上限の減りが大きい原因は、長い会話の送り直しやキャッシュ切れ、定期実行であることが多いです。先に /usage の内訳を見て、上位に来ている要因から手を付けてください。
Q. 上限に達したら、モデルを切り替えれば続けられますか。 「セッション上限」「週上限」のメッセージは全モデル共通の枠なので、切り替えても戻りません。「Opusの上限」のようにモデル名が付いたメッセージのときだけ、別の系統のモデルで続けられます。
Q. maxを既定値にしておけば、品質は最大になりますか。 maxは既定値として保存できず、環境変数で指定しない限りセッション限りで効きます。公式ドキュメントも、効果が頭打ちになりやすく考えすぎることがあると注意しています。見落としの許されない調査に、その回だけ使うのが適しています。
Q. チームの誰がどれだけ使っているかは、どこで見られますか。
各自の /usage はその端末の履歴だけの概算です。TeamやEnterpriseでは管理画面の利用分析、API契約ではConsoleのダッシュボードで、利用者ごとの数字を確認できます。クラウド事業者経由で使っている場合は、各社の請求画面や監視の仕組みで見ることになります。
まず試すなら
- 自分の既定エフォートを確かめる。
/effortを開き、今どの段階で動いているかを確認してください。settings.jsonの最上位にeffortLevelを書いている場合、Opus 5.5には効いていません。モデルごとの設定に書き直すところまでが一区切りです。 /usageの内訳を1回開く。 直近7日間に切り替え、上位3つの要因をメモします。定期実行や並列のエージェントが上位にいれば、エフォートより先にそちらを見直してください。- 作業が変わったら
/clearを習慣にする。 関係のない作業へ移るときの/clearは費用がかかりません。名前を付けて残しておけば、あとで戻ることもできます。
AI-Pathでは、無償の業務プロセス診断(BPR)を実施しています。現場のヒアリングから、業務フロー・改善案・投資対効果のたたき台までを可視化します。そのうえで「どの作業をAIエージェントに任せ、どこに人が付き添うか」を一緒に整理します。Claude Codeを社内に広げる前に、任せ方と上限の使い方を決めておきたい場合は、お問い合わせからご相談ください。
参考リンク
- Model configuration — Adjust effort level(Claude Code Docs) — エフォートの段階・既定値・設定方法
- Manage costs effectively(Claude Code Docs) — 長いセッションで利用量が膨らむ理由、/usageの内訳、チームの費用管理
- そもそもClaude Codeのエフォートってなに?(Zenn) — low〜maxの実測比較
- Claude Code / Codexで「私のlimit、減りすぎ…?」と思ったときに見る記事(Zenn・TOKIUM) — プロンプトキャッシュと利用上限の実測
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム

Claude Codeのファイル削除事故——rm -rf禁止でも4万8000件が消えた理由とauto モード時代の防ぎ方
Claude Codeのエージェントが103秒で4万8,218ファイルを消した事故が報告されました。削除コマンドを禁止していても止まらなかった理由と、auto モードが既定になった今、削除事故をどう防ぐかを、公式ドキュメントと私たちの現場の運用からお伝えします。

AIエージェントに渡す『鍵』をどう守るか——VibeCoding内製化のシークレット管理・APIキー管理
機密データを見せない、繋ぎ先のMCPを信頼する——ここまでお伝えしてきました。今回はその両方の土台にある「渡す鍵そのもの」の話です。APIキーをどこに置き、どう失効させるかという地味な設計が、実は事故の分かれ目になります。

MCPツールは『後から牙を剥く』——AIエージェントを狙うラグプル攻撃とツールポイズニング
一度承認したMCPサーバーは、その後もずっと安全とは限りません。ツールの説明文が密かに書き換わる『ラグプル攻撃』と、指示を隠し持つ『ツールポイズニング』という新しい脅威と、具体的な防ぎ方をお伝えします。