「敵対的レビュー」は入れただけでは効かない——仕込みバグ15個の実測が示す、AIコードレビューの検収設計
「AIに敵対的レビューをさせています」。先日、ある中堅メーカーの内製チームから、ほぼこの言葉で進捗をいただきました。良い取り組みです。ただ、そのあと私たちが聞いた「どの観点を誰が決めましたか」という質問には、答えが返ってきませんでした。敵対的レビューはコマンド一つで呼べるようになりました。しかし、呼べることと効いていることは別です。ここでは、仕込みバグ15個を使った実測で敵対的レビューが最下位になった事実と、その原因、そして発注側・マネジメント側が何を検収すればよいかを、私たちの現場経験を交えてお伝えします。
- 01敵対的レビューのよくある質問【5問5答】
- 02「そこにしか観点がいかないんだな」——発注側が先に見抜いていたこと
- 03敵対的レビューとは、AIに「反証」を役割として与えること
- 04公式コマンドになった「敵対的レビュー」——何が変わり、何が変わっていないか
- 05仕込みバグ15個の実測——敵対的レビューが最下位になった
- 06差がついたのはモデルではなく「観点を誰が決めたか」
- 07「反証させる」設計が壊れる3つの箇所
- 08発注側・マネジメント側が決めるべき4つの検収項目
- 09コストの判断——すべての変更へ掛けると、別の問題が起きる
- 10AI-Path の見解——「Gemini の回答を Claude で採点する」を社内でやっている理由
- 11まず試すなら
- 12参考リンク
敵対的レビューのよくある質問【5問5答】
私たちが AI コードレビューのご相談をお受けする中で、特に多くいただく質問を先にまとめます。詳しい根拠はこの後の本論でお伝えします。
Q1. 敵対的レビューとは何ですか
成果物を作った本人とは別の役割に「間違っているはずだ」という前提で反証を試みさせ、品質を確かめる方法です。「レビューしてください」と頼むのではなく、「これが誤っている証拠を探せ」と役割を与えるところが違います。組織論で言うレッドチームや悪魔の代弁者を、AI 相手に移したものだと捉えると分かりやすいはずです。実装としては、別の文脈を持つサブエージェントや別モデルに検証役を担わせます。
Q2. Claude Code で敵対的レビューはどう実行しますか
Codex プラグインを入れると /codex:adversarial-review で呼び出せます。導入は /plugin marketplace add openai/codex-plugin-cc などの数行で済みます。プラグインを使わない場合は、「作成者ではなく独立した懐疑者として読め。目的は改善提案ではなく反証だ」という役割指示を書いたサブエージェントを自分で定義する形になります。
Q3. 敵対的レビューにすれば検出精度は上がりますか
上がるとは限りません。後述する仕込みバグ15個の検証では、敵対的レビューの検出が 6/15 で最下位でした。観点を明示した自由記述のレビューが 14/15 でした。方式の名前ではなく、どの観点を渡したかで結果が動きます。
Q4. コストはどのくらい増えますか
検証役を足す分だけ素直に増えます。私たちの体感では、同じ差分に対して2〜3倍のトークンを見ておくと計画が狂いません。すべての変更へ一律に掛けるのではなく、認証・権限・課金・データ移行といった「戻せない変更」に絞るのが現実的です。
Q5. 人間のレビューは不要になりますか
なりません。私たちは、使い勝手を判断する受け入れテスト(UAT)と、指摘を採用するかどうかの最終判断は人が持つ線を外していません。AI は反証の材料を増やす役割までです。自社に合う線引きは業務ごとに変わるため、無償の業務プロセス診断(BPR)でご一緒に整理しています。
「そこにしか観点がいかないんだな」——発注側が先に見抜いていたこと
この論点を、実は私たちより先に顧客が言葉にしていました。
ある大手建材メーカーで、図面チェックを AI で自動化するデモをご覧いただいたときのことです。同社の担当者は、精度そのものは評価してくださいました。そのうえで、こう続けられました。「ここまでできるのは分かるが、逆にそこにしか観点がいかないんだなと思った。ものづくりとしてこういう部分をチェックしなきゃ、という視点が出てきていない」。
寸法のチェックと金物の照合は確かにできている。けれども、ものづくりの人間なら当然見るはずの別の観点が、出力にまったく現れていない——という指摘でした。正直に申し上げると、この場で私たちはすぐに反論できませんでした。検出率という数字では良い成績が出ていたからです。
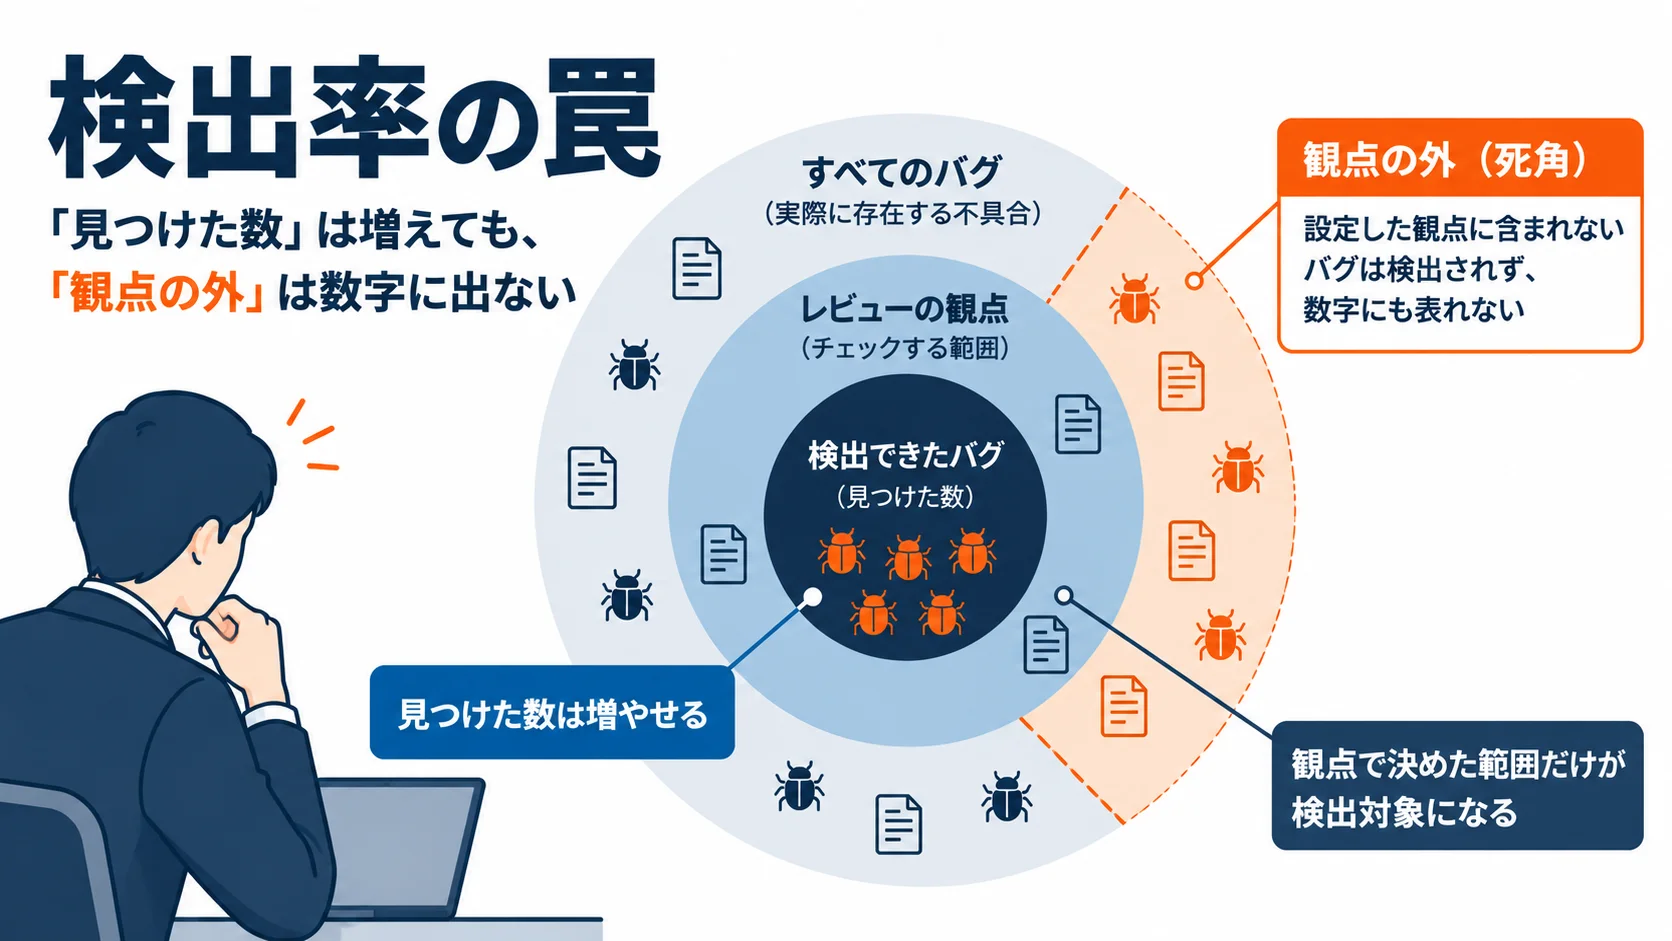
いま振り返ると、この指摘はコードレビューにそのまま当てはまります。AI に検証させるとき、私たちは「どれだけ見つけたか」を数えがちです。見ていない領域があること自体は、検出率には出てきません。見つけた数が増えるほど、見ていない領域は見えなくなっていきます。
敵対的レビューとは、AIに「反証」を役割として与えること
まず言葉を整理します。敵対的レビュー(敵対的検証とも呼ばれます)は、検証役に「反証しろ」という役割を明示的に与えるレビュー方式です。
ふつうに「このコードをレビューしてください」と頼むと、AI は良い点と改善案を並べた報告を返します。親切ですが、作った側の「たぶん大丈夫」という前提を引き継いだままの親切です。一方で「この実装が誤っている証拠を挙げろ。確信が持てないなら反証側に倒せ」と頼むと、返ってくるものの質が変わります。AI に感想を聞くのではなく、批判する役割を明示的に与える——違いはこの一点に尽きています。
効かせるための条件は3つです。作った会話の文脈を引き継がない独立性、感想ではなく反証を求める役割づけ、そして記憶ではなく一次情報に当たらせる接地。この3つが揃って初めて、検証役は作成者とは違うものを見るようになります。
ここは私たちの立場を書いておきます。敵対的レビューは、AI の能力を引き上げる技術ではありません。同じ能力の AI に、違う立場を取らせる技術です。だからこそ、立場の設計を間違えると何も起きません。概念そのものの整理は『敵対的検証』の解説でお伝えしています。定義から押さえたい場合は、そちらを先にご覧ください。
公式コマンドになった「敵対的レビュー」——何が変わり、何が変わっていないか
2026年に入って、この方式を取り巻く状況が一つ変わりました。OpenAI が Claude Code 向けのプラグインを公開し、敵対的レビューが標準コマンドになったことです。
Codex プラグインの導入記録が参考になります。これは、マーケットプレイスの追加とインストール、初期設定の3コマンドで終わる手軽さを示しています。以後は通常の変更へ /codex:review、リスクの高い変更へ /codex:adversarial-review を掛ける運用が推奨されています。Claude が書いたコードを Codex が疑う、という構図です。競合関係にある2社のモデルが、片方の開発環境の中でセカンドオピニオンとして組み合わされる。率直に言って、この座組みは数年前には想像しにくいものでした。
変わったのは導入の手間です。以前は検証役のサブエージェントを自分で定義し、役割指示を書き、独立性を担保する作り込みが要りました。いまはコマンドで呼べます。
変わっていないのは中身の責任です。コマンドが標準化されたことで、「入れたかどうか」は確認しやすくなりました。一方で「何を見るように指示されているか」は、コマンドの中に隠れます。ここが実務での落とし穴になります。私たちが冒頭の内製チームに「どの観点を誰が決めましたか」と尋ねたのは、まさにこの点が気になったからでした。
仕込みバグ15個の実測——敵対的レビューが最下位になった
この懸念は、体感の話で終わりませんでした。実際に測った方がいます。
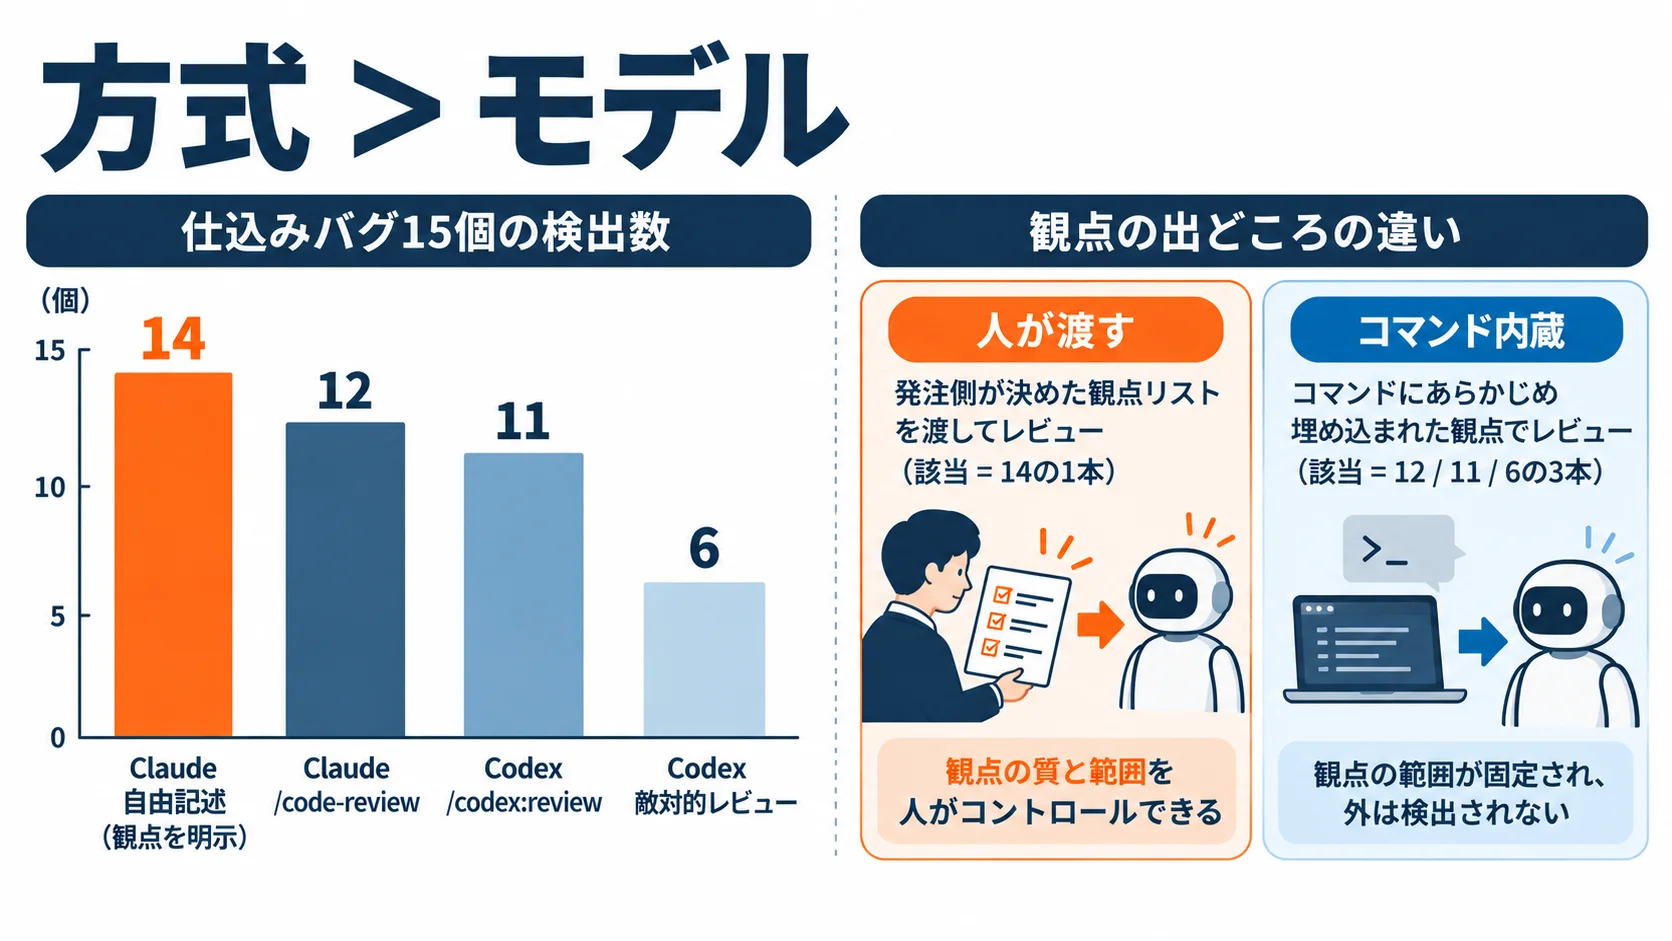
あるエンジニアによる比較検証を見てください。これは TypeScript で書いた URL 短縮サービスに意図的なバグを15個埋め込み、レビュー方式を変えて検出数を比べたものです。バグは正確性・並行性・セキュリティ・プライバシー・設計の5領域にまたがります。検出数は「2回試行のうち1回以上で検出できた数」で、検証者の集計方法に従います。結果は、方式の名前を信じている人には痛い内容でした。
| レビュー方式 | 検出数 |
|---|---|
| Claude 自由記述(観点を明示) | 14 |
Claude /code-review |
12 |
Codex /codex:review |
11 |
| Codex 敵対的レビュー | 6 |
敵対的レビューが最下位です。しかも同じ Codex で比べて、通常のレビュー(11)より敵対的レビュー(6)の方が低い。「より厳しく疑わせたのだから、より多く見つかるはずだ」という直感が、そのまま外れています。
誤解のないように申し上げると、これは題材1つ・2回試行という小規模な検証です。一般的な性能差として扱うのは乱暴だと私たちも考えています。検証者自身も、モデルの優劣ではなくレビュー方式の差が顕著だった、という書き方をしていました。それでも、「敵対的レビューを入れたから厳しくなった」という推論が成り立たない実例が1件でも存在する——この事実には、検収の設計を変える力があります。
差がついたのはモデルではなく「観点を誰が決めたか」
では何が効いたのか。検証の内訳を読むと、答えがはっきり書かれています。
いちばん成績が良かった「観点を明示した自由記述」は、連番が推測可能になっている問題や、レイヤー分離が欠けている問題といった設計・ドメイン寄りのバグを拾っていました。対して純正コマンドは、正確性のバグに強く寄っていました。コマンドの中にあらかじめ埋め込まれた観点の内側だけを、丁寧に見ていたわけです。
ここで先ほどの建材メーカーの担当者の言葉が戻ってきます。「そこにしか観点がいかないんだな」。寸法と金物はチェックできる。ものづくりとして見るべき別の観点は出てこない。検図 AI で起きていたことと、AI コードレビューで起きていることは、同じ構造でした。
私たちの現場経験では、この差は内製化の現場でいっそう大きく出ます。会社ごとに「落ちてはいけない場所」が違うからです。ある医薬・食品メーカーの需要予測では、現場に判断させないという設計思想そのものが要件でした。推奨発注を出すと作業者に思考が発生してしまうので、データが来たらボタンを押すだけにしたい——担当者はそう明言されました。この会社のコードをレビューするなら、「現場に判断を求める UI になっていないか」は外せない観点になります。汎用のコマンドがこれを見てくれることは、期待できません。
結論として、観点はツールから出てきません。業務を知っている人間が渡すものです。 そしてここが、発注側が自分で握れる数少ないレバーになります。
「反証させる」設計が壊れる3つの箇所
観点を渡したうえで、設計として崩れやすい箇所が3つあります。私たちが現場で実際に踏んだ順に挙げます。
独立性が、見かけだけになる
検証役を別エージェントにしたつもりでも、親の文脈を引き継いでいれば独立していません。作成者の「ここは問題ない」という判断ごと渡してしまい、反証の起点が汚れます。私たちは、検証役には差分と要件だけを渡し、実装中の会話は渡さない形に寄せました。地味な違いですが、出てくる指摘が変わります。
過剰検出で、現場が指摘を読まなくなる
反証を命じると、AI は無理にでも問題を作ります。偽陽性が増えると、現場は指摘欄を読み飛ばすようになります。これは AI の問題というより、人間の注意力の限界の問題です。ある成形機メーカーで AI 回答を100問まとめて評価していただいたとき、推進課のマネージャーはこう言われました。「間違った回答もいくつかあった。その回答で問題が解決するか微妙で、それを見て結局取説を見に行っちゃうシーンが目に浮かんだ」。信頼が一度切れると、仕組みは残っても使われなくなります。
指摘の粒度が粗く、直ったかどうかが追えない
反証をまとめて1件の報告にすると、何が残っているのか分からなくなります。私たちは社内で、イシューを管理しやすい単位に切ることを徹底しています。丸めて起票すると全部が自分の名前になり、順番に検証しないと「ここは直ったがここは直っていない」という漏れが起きるからです。敵対的レビューの出力も同じで、1指摘1イシューに割ってからでないと検収できません。
発注側・マネジメント側が決めるべき4つの検収項目
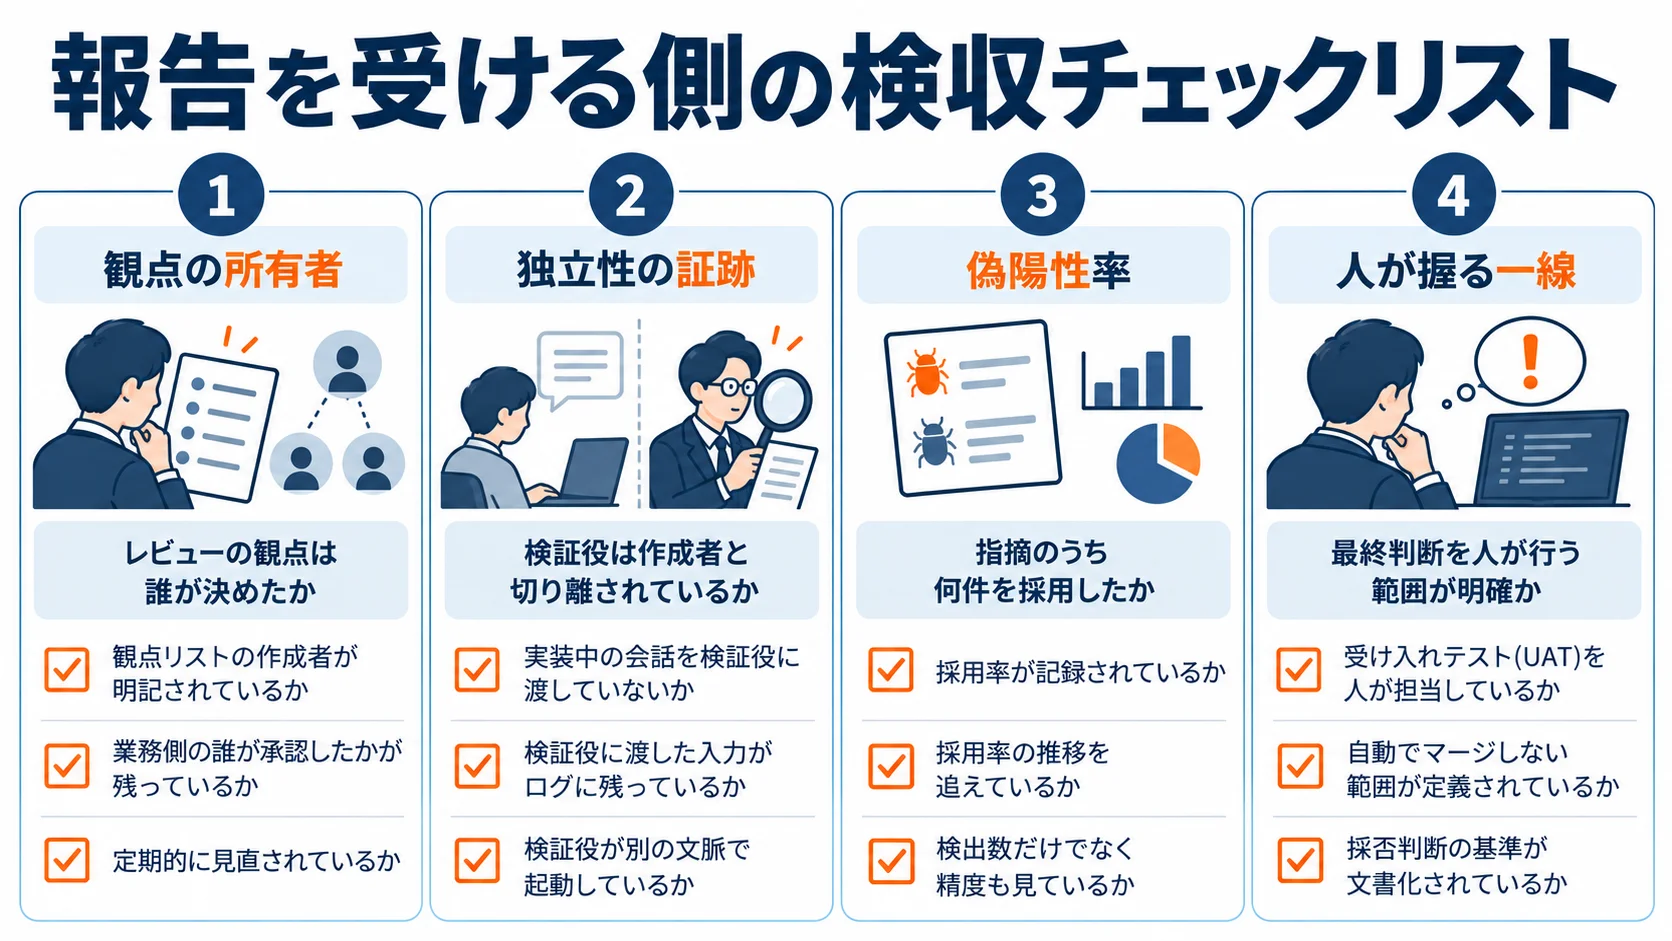
ここが、いまネット上でいちばん手薄な部分だと感じています。実装の手順を書いた解説は充実してきました。一方で、「導入した」という報告を受けた側が何を確かめるかは、ほとんど書かれていません。私たちが現場で使っている4項目を、そのまま挙げます。
- 観点リストの所有者を決める — どの観点で疑わせるかを文書にし、業務側の誰が承認したかを残します。コマンド任せにしない、という一点だけで結果が変わります。
- 独立性の証跡を見る — 検証役に何を渡したかをログで確認します。実装の会話を渡していれば、独立性は成立していません。
- 偽陽性率を測る — 指摘のうち何件を採用したかを記録します。採用率が落ちてきたら、観点か役割づけが壊れている合図です。
- 人が握る一線を書く — 使い勝手の受け入れ(UAT)と、指摘の採否判断は人に残します。私たちは単体テストとシナリオテストは自動化していますが、UAT は AI が苦手な領域なので、人が触ってダメ出しする工程を残しています。
1つ目の観点リストは、長い文書にする必要はありません。私たちが顧客と作るときは、A4 半分に5行だけ書きます。「誰の権限で何が見えてはいけないか」「金額の計算がずれたら誰が気づくか」「現場に判断を押し付けていないか」——この粒度で十分です。業務の言葉で書いてあることのほうが、網羅性よりも効きます。
4つ目について補足します。VibeCoding で起こりがちな「謎の項目が勝手に増える」事故は、どれだけ敵対的レビューを厚くしても止まりません。止まるのは人が触ったときです。ここは意見が分かれるところかもしれませんが、私たちは当面この線を動かさない方針でいます。
内製を始めたばかりのチームには、もう少し手前のガードレールも渡します。メインに直接マージせず、まず PR を上げること。PR を上げれば AI が中身を確認して妥当性を判断してくれます。そしてデータベースは直接いじらないこと。自分のブランチをどれだけ汚しても戻せますが、DB を触ると後戻りできません。敵対的レビューは、この順番を守れているチームで初めて効いてきます。
コストの判断——すべての変更へ掛けると、別の問題が起きる
費用の話も避けずに書きます。検証役を足せばトークンは増えます。同じ差分に2〜3倍を見ておくと計画が狂いにくい、というのが私たちの実務感覚です。観点別に複数のエージェントを並列で走らせ、2体以上が指摘した箇所だけ採用する構成なら、さらに上を見ておく必要があります。
ある大手建材メーカーの情報システム部長は、この点をかなり早い段階で気にされていました。「AI の利用料はやり方によっては上がる可能性もゼロではない」。複数システムを別々に作る方針についても「正直、一時の投資になってしまう」と警戒されていました。発注側がこう考えるのは、まったく健全です。
私たちは、変更の種類で掛け方を分けています。
| 変更の種類 | 推奨するレビュー | 理由 |
|---|---|---|
| 認証・権限・課金・データ移行 | 敵対的レビュー + 人の確認 | 事故が起きると戻せない |
| 外部に出る画面・API | 通常レビュー + 観点明示 | 影響範囲が読める |
| 社内向けの表示・文言 | 通常レビューのみ | 事故の損害が小さい |
| 実験・プロトタイプ | レビューなし | 捨てる前提のコード |
正直に言えば、この表は案件ごとに作り直しています。固定の基準を持ち込むと、どこかで過剰になるか不足するからです。線を引く作業そのものが、業務の棚卸しになっていきます。
AI-Path の見解——「Gemini の回答を Claude で採点する」を社内でやっている理由
私たちがこの話題を他人事として書けないのは、同じ構造を自社で日常的に使っているからです。
社内では、Gemini が出した回答を、もう少し賢い Claude に採点させるモードを持っています。正直に言って、Gemini はハルシネーションが一番多いという実感があります。それでも使うのは、速度と費用に見合う場面があるからです。コストは一時的に増えますが、より正しい回答を出すモードを足す方が、全体としては安くなります。これは敵対的レビューと同じ考え方です——作った主体に採点させない。
もう一つ、私たちが外していない原則があります。AI は信用するものではなく、こちらの考えをぶつけ、前提情報や意図を渡し続ける相手だということ。AI は相手を見て会話します。表向きの情報しか与えなければ、表向きの回答しか返ってきません。敵対的レビューで「観点を渡す」という話は、この原則の一部でしかありません。
測り方についても、現場で聞いた忘れられない一言があります。ある重工・製鋼メーカーのシステムグループマネージャーは、QC 発表の報告をこう振り返りました。「開発に AI を入れてコールを30%削減しました、と QC 発表で報告したが、全然評価が悪くて、あまり響かなかった。どうやってやっていいのかな、と思う」。削減率は出した。それでも社内には響かなかった。
私たちの現場経験では、AI レビューの効果は削減率より「見落としが本番に出た件数」で語った方が通ります。前者は反論されますが、後者は反論されません。敵対的レビューを入れる目的は、レビュー時間の短縮ではなく、戻せない事故を減らすことだからです。目的を取り違えると、せっかく入れた仕組みが社内で評価されません。
まず試すなら
明日から試せる順に3つ挙げます。
- 観点リストを1枚だけ作る — 自社で「落ちてはいけない場所」を5つ書き出し、検証役への指示に貼ります。コマンド任せをやめるだけで、拾える領域が変わります。所要時間は30分ほどです。
- 採用率を2週間だけ記録する — AI の指摘を何件受け入れたかを数えます。採用率が2割を切っていれば、観点か役割づけが壊れています。ここは測らないと気づけません。
- 人が握る一線を文書にする — 受け入れテストと採否判断は人が持つ、と明記します。1行で構いません。これが無いと、事故が起きたときに誰も説明できなくなります。
そのうえで、どの業務にこの仕組みを掛けるべきかは、コードを見るだけでは決まりません。業務のどこが止まると困るのか、誰が判断しているのかを棚卸しする作業が先に来ます。AI-Path では、無償の業務プロセス診断(BPR) を実施しています。現場のヒアリングから業務フロー・改善案・投資対効果のたたき台までを一気に可視化し、「どの業務に AI が効くか」「どこに検収の壁を置くか」をご一緒に見極めます。レビューの仕組みづくりだけでなく、その前段から相談したい場合は、お気軽にお声がけください。
並列実行でレビューが壁になる構造はエージェントマネージャーという働き方でお伝えしています。PR 提出前にセルフレビューを済ませる型はレビューが開発の壁になる時代にまとめました。
参考リンク
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
ハーネスエンジニアリングとは——AIが「自分のPCの中」で止まる会社と、全社で動く会社の差
プロンプト、コンテキストの次に来た「ハーネスエンジニアリング」。提唱者は「難しいのはハーネスだ」と言い切りました。AIエージェントが個人利用で止まる会社と全社で動く会社の差はどこにあるのか。自社で全社ハーネスを運用しているAI-Pathの実例から、設計の型と失敗パターンをお伝えします。
「理解負債」というAI時代の新しい借金——コードは速く書けるのに、開発が遅くなる会社の共通点
AIでコードは3倍速く書けるようになったのに、仕様変更とバグ修正は遅くなった。原因は「理解負債」——コードが汚いのではなく、誰も中身を説明できない状態です。認知負債・意図負債との違いと、私たちが社内で決めた4つの線引きをお伝えします。

Claude Codeのエフォートと上限——Opus 5.5で既定がmediumになった今の使い分け
Opus 5.5でClaude Codeのエフォート既定値がhighからmediumに下がり、9月には週の利用上限の見直しや5時間上限の停止処理も変わりました。low〜maxで何が変わるのか、作業別の使い分け、上限を本当に食っているものの見つけ方を、公式ドキュメントと私たちの運用からお伝えします。