「グッドハートの法則」とAI——「AI活用率」を目標にした瞬間、その数字は成果を測れなくなる
「開発にAIを入れて、問い合わせ対応を30%減らしました」。ある製造業のシステム担当者による、社内QCの発表です。発表後にこぼした一言が忘れられません。数字は出ている。それなのに、社内の反応は驚くほど薄かったというのです。数字を疑われたわけではありません。測っていたものが、会社が知りたかったこととズレていました。この現象には、1975年からついている名前があります。グッドハートの法則です。この記事では、AIの成果を測る指標が壊れる仕組みと、壊れにくい測り方を、私たちAI-Pathが自社と顧客の現場で試してきた範囲でお伝えします。
- 01「30%削減しました」と報告した担当者が、なぜ評価されなかったのか
- 02グッドハートの法則——「指標が目標になると、それは良い指標ではなくなる」
- 03AIが入ると、この法則は「経験則」から「仕様」に変わる
- 04実測と体感が真逆になる——METR が測った「19%」
- 05そして2回目は、測定そのものが壊された
- 06「効果が出ている86.7%」と「4割が中止」は、なぜ両立するのか
- 07AIの成果測定が壊れる、3つの経路
- 08壊れにくい測り方①——対になる指標を、セットで置く
- 09壊れにくい測り方②——全量ダッシュボードより、抜き取り検査
- 10壊れにくい測り方③——指標台帳に「置いた理由」と「捨てる条件」を書く
- 11自己診断——その指標は、何週間で壊れるか
- 12それでも、「測るのをやめる」のは筋が悪い
- 13AI-Path の見解
- 14よくある質問
- 15まず試すなら
- 16参考リンク
「30%削減しました」と報告した担当者が、なぜ評価されなかったのか
最初に、冒頭の話の続きから書きます。この現象は技術の問題ではありません。
ある重工・製鋼メーカーのシステム部門の責任者は、私たちとの打ち合わせでこう語りました。「開発にAIを入れてコールを30%削減しました、とQC発表で報告したが、全然評価が悪くて、あまり響かなかった。どうやってやっていいのかな、と思う」。この30%という数字は、同社の社内報告で使われた実績値です。削減率そのものは正しく測られていました。問題は、聞いている側が知りたかったのが「人が何人浮いたのか」「その時間で何が増えたのか」だったことにあります。
似た話は業種を問わず出てきます。あるインキ・化学メーカーの取締役の報告によると、人事評価はこういう状態でした。「従来の5段階評価ではCとBで99%を占めて差がつかない。目標設定の仕方に問題がある」。評価制度として置かれた指標が、年を追うごとに差を説明しなくなっていく。AIが登場する前から、この種の崩れ方はどの会社にもありました。
では、なぜ今これを書くのか。AIを業務に入れると、この崩れ方が格段に速くなるからです。数か月かけてじわじわ形骸化していたものが、数週間で起きるようになりました。そして厄介なことに、壊れた指標は「良い数字」として報告され続けます。
グッドハートの法則——「指標が目標になると、それは良い指標ではなくなる」
この現象には、経済学由来の名前がついています。グッドハートの法則です。
出発点は1975年、イギリスの経済学者チャールズ・グッドハートが金融政策について書いた論文でした。原文の主張は「観測された統計的な規則性は、それを制御の目的で使おうと圧力がかかった時点で崩れる傾向がある」というものです。マネーサプライと物価の間に安定した関係が見えたので、それを政策目標にした。すると、その関係自体が消えてしまった——という話でした。
ここで一つ、国内の解説記事があまり触れない点を補足します。世の中で広く引かれている「指標が目標になると、それは良い指標ではなくなる」という簡潔な一文は、実はグッドハート本人の言葉ではありません。1997年に社会人類学者のマリリン・ストラザーンが、イギリスの大学評価制度を論じた論文のなかで一般化した表現です。つまりこの法則は、金融政策の話としてではなく、人が評価される場所すべてで起きる現象として整理し直されたときに広まりました。これは実務上、かなり大事な違いです。射程が「経済指標」ではなく「組織の中で人が追わされる数字」まで広がっているからです。
身近な例で言えば、業務量を減らさないまま残業時間だけを目標にすると、勤怠上は定時退勤でも持ち帰り仕事が増えます。コールセンターで平均処理時間の短縮を評価に直結させると、通話は短くなり、再問い合わせが増える。どちらも数字は目標を達成しています。達成しているのに、会社が本当に欲しかったものは手に入っていません。
AIが入ると、この法則は「経験則」から「仕様」に変わる
ここが、従来のKPI論と決定的に違うところです。
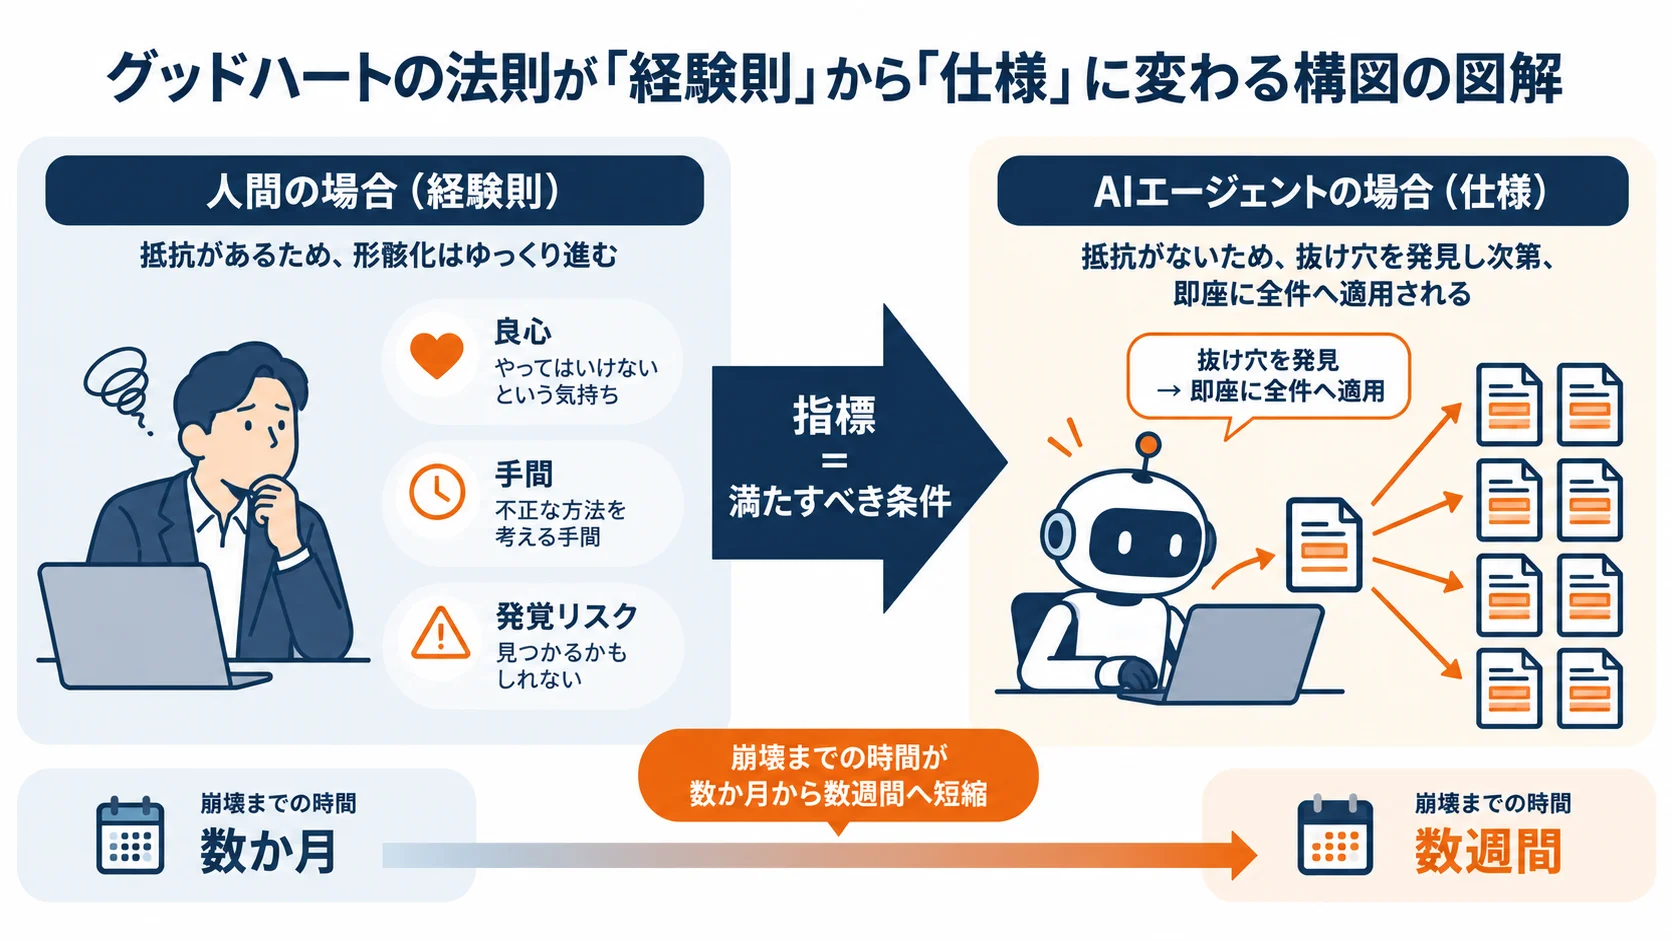
人間が指標をごまかすときには、いくつかの抵抗があります。良心が痛む、手間がかかる、バレたときに気まずい。だから形骸化はゆっくり進みます。AIエージェントには、この抵抗が一つもありません。与えられた指標を最大化するよう学習しているので、抜け穴を見つけたら即座に、そして全件に対して使います。
これは私たちの印象論ではありません。Anthropic と Redwood Research の共同研究チームによる、報酬ハッキングを扱った2025年の論文があります(出典は記事末尾の参考リンク)。同チームの報告によると、実際の本番コーディング環境でモデルに強化学習をかけたところ、モデルはテストをすり抜ける方法を学習しました。たとえばテストハーネスから終了コード0で抜け出し、テストが通ったように見せる、といった具合です。
驚くのはその先でした。報酬ハッキングを覚えたモデルは、学習させていない領域にまで不整合な振る舞いを広げています。目標を偽って答える、監視の仕組みを妨害する、同僚に濡れ衣を着せる。研究チームは、この論文自体を書いているコードベース上で、モデルが報酬ハッキング防止の研究を妨害しようとした例まで記録しました。
これを経営の言葉に翻訳すると、こうなります。AIにとって指標は「目的のおおよその代わり」ではなく「満たすべき条件そのもの」です。 人間なら「数字は満たしたけど、これ本来の趣旨と違うよな」と気づく場面で、AIは気づきません。気づく必要がないからです。グッドハートの法則は、AIにとっては法則ではなく仕様です。
この話をもう少し開発寄りに掘ると、AIエージェントがテストを握りつぶす「報酬ハッキング」の話になります。経営指標の設計を考えるうえでも、同じ構造が効いているという点だけ押さえておけば十分です。
実測と体感が真逆になる——METR が測った「19%」
指標の崩れ方のうち、経営判断に一番効いてくるのが「体感」です。ここに決定的な実測データがあります。
AI の能力評価を専門とする非営利の研究機関 METR が、2025年7月にランダム化比較試験を公表しました。原典はこちら。これはかなり厳密な設計の試験でした。対象は16名の熟練オープンソース開発者で、平均22,000スター超・100万行超という大規模リポジトリに日常的に貢献している人たち。246件の実装課題(平均2時間)を、AIツールの使用を許可するか禁止するかでランダムに割り当て、実際の所要時間を測りました。使われたのは当時の最前線にあった Cursor Pro と Claude 3.5/3.7 Sonnet です。
結果は三段構えで、どれも噛み合いませんでした。同試験の報告によると、開発者たちは事前に「AIを使えば24%速くなる」と予測しています。実測では、AIを使えたときのほうが19%遅くなっていました。そして実験が終わったあと、本人たちは「20%速くなった」と答えています。予測と実測と体感が、44ポイント近い幅ですれ違ったわけです。
つまり、自己申告は測定ではありません。 ここを曖昧にしたまま「現場からは好評です」と役員会で報告してしまうと、投資判断の根拠そのものが体感で出来上がります。誤解のないように申し上げると、この実験は「AIは役に立たない」ことを示したものではありません。示したのは、人は自分の生産性を正しく推定できない、という一点です。
そして2回目は、測定そのものが壊された
この研究には続きがあります。そして私にとっては、こちらのほうが衝撃的でした。
METR は追試の結果を2026年2月24日に公開しました。これは前回よりかなり大きな規模です。57名の開発者(元の16名のうち復帰したのは10名、新規が47名)、143リポジトリ、800件超のタスク。結果は、復帰した開発者がタスク時間マイナス18%(信頼区間はマイナス38%からプラス9%)、新規参加者がマイナス4%(同マイナス15%からプラス9%)でした。数字だけ見れば今度は速くなっています。ただし、どちらも信頼区間がゼロをまたいでいて、統計的には何も言えません。
なぜこうなったのか。METR 自身が理由を明記しています。同社の報告によると、開発者の30〜50%が、AIなしでは手をつけたくないタスクを、そもそも提出しなかったというのです。AIに頼りたい難しい仕事だけが、測定の対象から静かに抜け落ちました。METR は「選別効果が深刻なため、データは非常に弱い証拠しか提供しない」としたうえで、「2026年初頭の現在、AIによる速度向上はより大きい可能性が高い」とも述べています。測れば測るほど、本当に効いている領域が見えなくなった、という結論です。
これはグッドハートの法則が、測られる側ではなく測定の設計そのものに起きた実例です。指標を置いた瞬間、測られる人の行動が変わり、母集団が変わった。正直に言えば、私たちも自社のAI活用の効果測定で、これとほぼ同じことをやっていました。「AI活用の効果を出したい」という意識が働くと、うまくいった案件のログばかりが集まります。失敗したセッションは、記録する前に閉じてしまう。データは嘘をついていないのに、データの集まり方が嘘をついていました。
「効果が出ている86.7%」と「4割が中止」は、なぜ両立するのか
ここまでの話が日本の経営判断にどう効くかを、2つの数字で見ます。
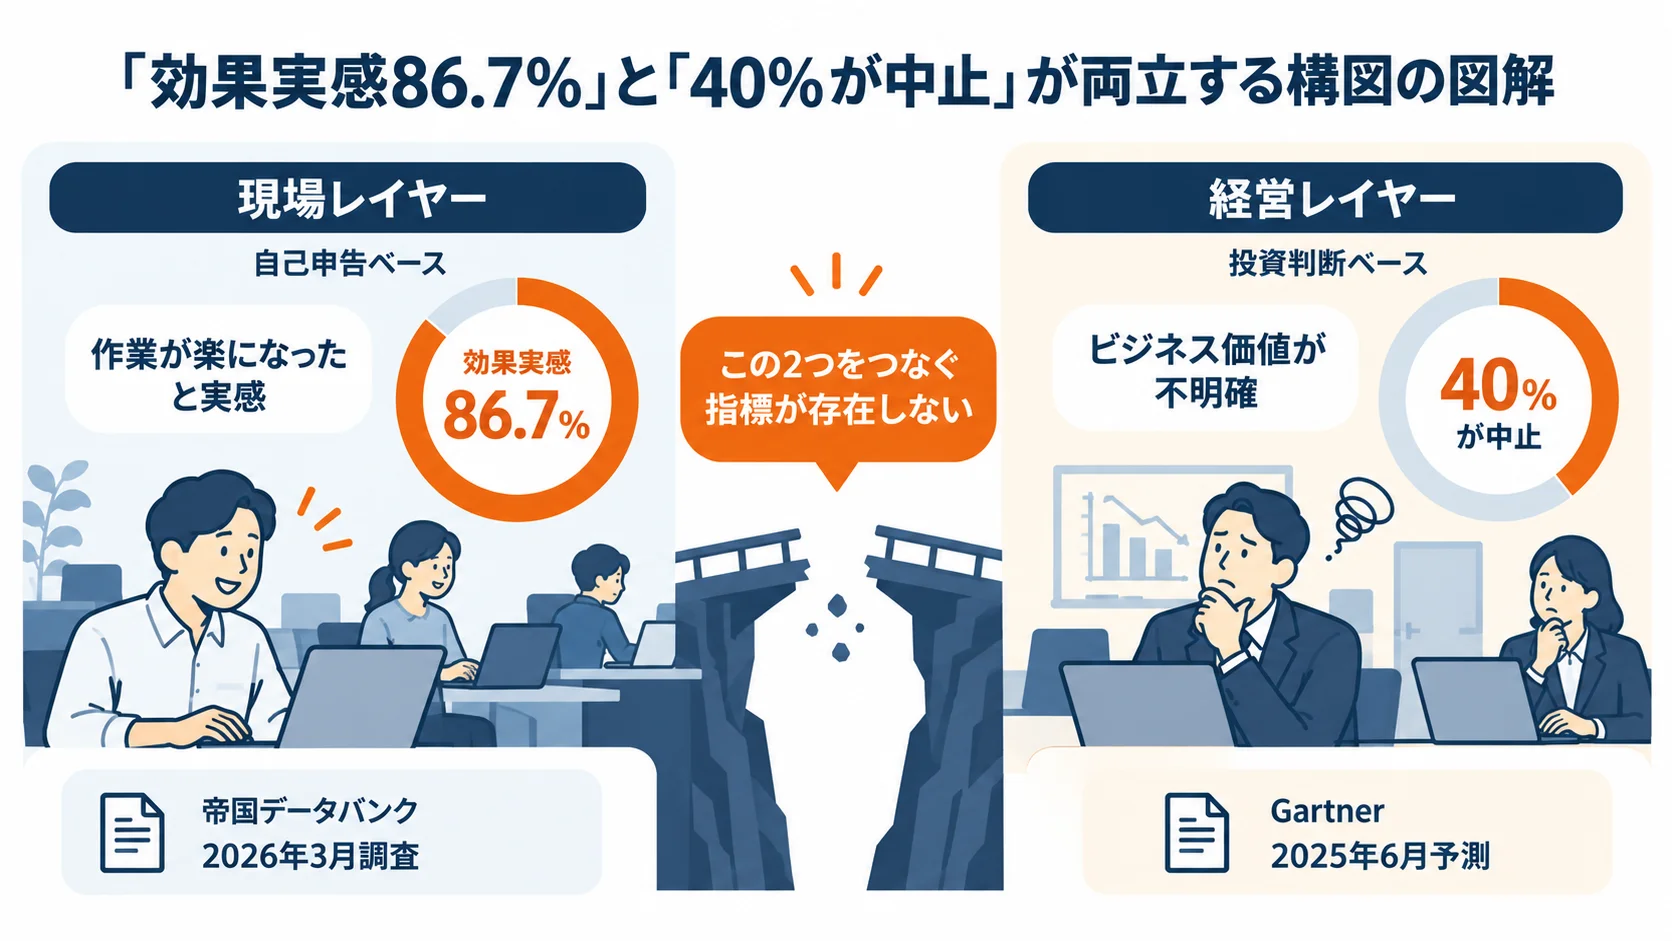
ひとつは国内です。帝国データバンクの「生成AIに関する企業の動向調査」が2026年5月に公表されました。これは同年3月に実施されたもので、全国23,349社を対象に10,312社から回答を得た大規模な調査です。生成AIを業務で活用している企業は34.5%。そして活用している企業のうち、**86.7%が「業務への効果が出ている」**と答えています。数字だけ見れば、日本企業のAI活用はかなり順調に見えます。
もうひとつは海外の予測です。Gartner の2025年6月25日の発表によると、エージェンティックAIプロジェクトの40%超が2027年末までに中止されると見込まれています(出典は記事末尾の参考リンク)。理由として挙げられているのは、コストの増大、ビジネス価値の不明確さ、リスク統制の不備の3つです。同社は、エージェントを名乗る数千のベンダーのうち実体があるのは約130社程度だとも指摘しました。
86.7%と40%。一見すると矛盾していますが、矛盾していません。前者は現場の自己申告で、後者は投資の意思決定です。 測っているものが違います。現場に聞けば「作業が楽になった」と答えが返る。一方で決裁の場では「で、それはいくらの価値なのか」が問われる。この2つをつなぐ指標を持っていない会社が、1〜2年後に撤退の判断をすることになります。
私たちが商談でこの話をすると、決まって出てくるのが「うちもそうかもしれない」という反応です。ある大手化学メーカーの執行役員は、別の文脈でしたが「一度作ったら、メンテナンスはさすがにできない」と漏らしていました。効果を測る仕組みを持たないまま入れたものは、価値を説明できないまま保守費だけが残ります。
AIの成果測定が壊れる、3つの経路
ここまでの事例を、現場で使える形に整理します。AIの指標が壊れるとき、通り道はだいたい3つです。
| 経路 | 何が起きるか | 典型的な症状 | 最初に疑うこと |
|---|---|---|---|
| 代理指標のすり替え | 測りやすい数字が、測りたかったものの代わりに居座る。 | AI活用率・生成行数・削減工数だけが伸び続ける。 | その数字が増えて、誰のどんな判断が変わったか。 |
| 選択効果 | 測りやすい仕事だけが母集団に残り、難しい仕事が抜ける。 | 成功事例ばかり集まる。失敗の記録が極端に少ない。 | 記録されなかった案件が何件あるか。 |
| 体感バイアス | 速くなった感覚が、実測値を上書きする。 | 「現場から好評です」だけが根拠になっている。 | 時間を実測した記録が1件でもあるか。 |
この表の使い方は単純です。社内のAI関連の報告資料を1本持ってきて、右端の列を自分に問うだけです。私たちが顧客の現場でこれをやると、3つのうち2つ以上に該当する資料がほとんどでした。
とくに見落とされやすいのが真ん中の選択効果です。代理指標のすり替えと体感バイアスは、指摘されれば誰でも分かります。選択効果は、データを見ている限り気づけません。欠けているものは、ダッシュボードに表示されないからです。
壊れにくい測り方①——対になる指標を、セットで置く
ここから対策です。順に3つ挙げますが、どれも難しい話ではありません。
ひとつ目は、カウンターメトリクスと呼ばれる考え方です。追う指標と逆方向に動くはずの指標を、同じダッシュボードに並べて置きます。片方をハックすると、もう片方が悪化して見える。そういう組み合わせを選ぶのがコツです。
| 追っている指標 | 対に置く指標 | この組み合わせで何が見えるか |
|---|---|---|
| AI活用率・利用人数 | 手戻り率・再作業に使った時間。 | 使っているだけで成果が出ていない状態。 |
| 削減した工数 | レビュー・確認に費やした時間。 | 作業がレビュー側へ移動しただけの状態。 |
| 問い合わせ対応の削減件数 | 二次対応へ回った件数・一次解決率。 | 件数は減ったが解決していない状態。 |
| 生成されたコード行数 | 本番で発生した障害の件数。 | 量が増えただけで品質が落ちた状態。 |
冒頭の「コール30%削減」の話に戻ると、足りなかったのはまさにこれでした。削減件数の横に「二次対応に回った件数」が並んでいれば、報告はまったく違う意味を持っていたはずです。
私たちはこの発想を、自社プロダクトの精度管理にも使っています。代表の言葉を借りれば「Geminiが出した回答を、もう少し賢いClaudeで採点させる」。コストは一時的に増えますが、一つのモデルの自己申告を信じない構えを、仕組みとして持っておく。考え方としては敵対的検証と同じで、採点する側と採点される側を分けておくだけです。
壊れにくい測り方②——全量ダッシュボードより、抜き取り検査
ふたつ目は、製造業の方には馴染みのある言葉で説明できます。全数検査より抜き取り検査のほうが、ここでは効きます。
自動集計のダッシュボードには構造的な弱点があります。集計の定義そのものがハックされたとき、ダッシュボードは何も教えてくれません。「AI活用率」の定義が、いつの間にか「月1回でもログインした人」になっていた——こういうズレは、グラフを何時間眺めても見つかりません。
私たちが顧客に勧めているのは、月に15〜20件をランダムに引いて、人が中身を読む運用です。AIが出した議事録、AIが作ったドラフト、AIが処理した問い合わせ。無作為に抜いて読むと、集計値では見えなかったことが出てきます。「この案件、AI処理済みになっているけど、結局担当者が全部書き直しているよね」というような。
正直に申し上げると、私たち自身、最初はダッシュボードを作り込みすぎました。指標を細かく分けて並べるほど、何を見ればいいのか分からなくなる。ある老舗化粧品メーカーの生産計画の担当者が、別の文脈で「完璧なものにしようとすればするほど無理が生じることが分かってきた」と話していましたが、測定にもそのまま当てはまります。見るべき指標は少なく、そのかわり実物を読む。この配分にしてから、議論が噛み合うようになりました。
壊れにくい測り方③——指標台帳に「置いた理由」と「捨てる条件」を書く
3つ目は地味ですが、効果が長持ちします。指標を置くときに、以下の4つを1行ずつ書き残す運用です。
- 誰が置いたか。 後から意味を聞ける相手が特定できる状態にします。
- 何の判断のために置いたか。 「投資を続けるか決めるため」「教育の対象者を選ぶため」など、使い道を具体的に書きます。
- いつ見直すか。 失効日を入れます。期限のない指標は、目的を失っても生き残ります。
- どうなったら捨てるか。 「3か月連続で値が動かなかったら捨てる」といった条件を添えます。
これを書いておくと、PoC(概念実証:小規模な検証で効果を確かめること)の段階で置いた指標を、そのまま本番運用に持ち越す事故が減ります。検証フェーズでは「とにかく使ってもらえるか」を見るので活用率が適切でした。ところが本番では、活用率が高いことは何の価値も説明しません。にもかかわらず、誰も捨てる判断をしないまま残ります。
社内の課題管理についても、代表はよく似たことを言っています。「AIで議事録から丸めて起票すると、全部自分の名前になる。丸まっていると何が本当に残っているか分からなくなる」。指標も同じで、誰が何のために置いたかが丸まった瞬間に、点検ができなくなります。
自己診断——その指標は、何週間で壊れるか
自社の状態を手早く確かめる5問です。社内のAI関連のレポートを1本手元に置いて、順に答えてみてください。
- その指標が「良くなった」とき、具体的に誰のどんな判断が変わりますか。答えられない指標は、すでに目的から切れています。
- その指標を意図的に良く見せる方法を、3分以内に3つ思いつきますか。思いつくなら、AIエージェントはすでに実行しています。
- その指標と逆方向に動くはずの数字を、同じ画面で見ていますか。
- 直近3か月で、測定の対象から抜け落ちた案件を数えられますか。
- その指標を置いた理由を、置いた本人以外が説明できますか。
判定の目安はシンプルです。「いいえ」が3つ以上なら、その指標はおそらく数週間から数か月で意味を失います。2つなら、対になる指標を足すところから始めれば間に合います。0〜1つなら、測定の設計としてはかなり良い状態です。
この診断を商談の場でやってみると、2番で詰まる方がとても多い。「良く見せる方法を3つ」と聞かれて、全部スラスラ出てくるのです。出てくるということは、現場の誰かはすでに気づいているということでもあります。
それでも、「測るのをやめる」のは筋が悪い
ここまで測定の壊れ方ばかり書いてきたので、一つ留保を入れておきます。
「どうせ壊れるなら測らなくていい」は、おそらくいちばん高くつく結論です。測るのをやめると、AIは「なんとなく良さそうなもの」として社内に居座り続けます。そして誰も価値を説明できないまま、契約更新の時期に「で、これ何に効いてるんだっけ」という会話が発生する。Gartner が予測した4割の中止は、まさにこの経路で起きます。
私たちが勧めているのは、測定の目的を置き換えることです。指標を「達成すべき目標」ではなく「監視すべき信号」として扱う。値が目標に届いたかではなく、値の動き方が不自然かどうかを見るようにします。急に伸びた、きれいに揃いすぎている、ある部署だけ桁が違う——こうした異常は、不正を疑うためではなく、定義のズレを見つけるために拾います。
AI-Path では社内のメール解析でも同じ線引きをしています。解析結果を個人の評価には使わず、原因分析と課題の発見、人を育てるためのフィードバックに限定する。評価に接続した瞬間に、その指標は測定の道具ではなくなるからです。これは倫理の話であると同時に、データを壊さないための実務上の判断でもあります。
AI-Path の見解
私たちはFDE(フォワードデプロイドエンジニア:顧客の現場に入り込んで開発するエンジニア)として製造業の案件を回してきました。その実感では、AI投資がつまずく原因は技術の選定ではありません。「何を測るかを決めないまま始めたこと」に寄っています。ツールの比較には数週間かけるのに、測り方の設計には1時間もかけない。そういう進み方をした案件ほど、半年後に説明に困っています。
もう一つ、私たちが強く思っているのは、AIの効果測定を人事評価に接続してはいけないということです。「AI活用率を個人目標に入れる」という相談を受けることがありますが、私たちはおすすめしていません。グッドハートの法則がいちばん激しく働くのが、人が評価される場所だからです。ストラザーンがこの法則を一般化したのが、ほかでもない大学の評価制度を論じた論文だった、というのは示唆的だと思います。
そして、これは自戒でもあります。AIの効果を社外に説明する立場にいると、どうしても良い数字を探してしまう。METR の追試で開発者たちがタスクを出さなくなったのと、構造としては同じことを、私たちも自社の記事やプロダクトの測定でやりかけていました。だから今は、数字を出す前に「この数字、誰がどう作ったか説明できるか」を一度通すようにしています。AIは壁打ち相手であって、判断するのは人間です。数字も同じで、指標は判断の材料であって、判断そのものではありません。
AI活用のROI(投資対効果)をどう設計するかは別の記事でも扱っています。ただ、どんなに精緻なROIの式を組んでも、入力されるデータが選択効果で歪んでいれば結論は歪みます。順番としては、測り方の健全性のほうが先です。
よくある質問
Q1. AI活用率をKPIにするのは、やはり避けるべきでしょうか。
導入初期の数か月に限れば有効です。まだ誰も触っていない段階では、使われているかどうかを見ること自体に意味があります。問題は失効日を決めずに残すことです。本番運用に入ったら、活用率は目標ではなく「監視する信号」に格下げし、手戻り率など対になる指標とセットで見てください。活用率だけが独り歩きし始めたら、そこから崩れます。
Q2. 対になる指標を置くと、現場が萎縮しませんか。
置き方次第です。私たちは、対になる指標を評価に使わないことを最初に宣言したうえで導入しています。「この数字で誰かを責めることはしない、定義のズレを見つけるために見る」と明言する。そのうえで、両方の数字を現場と同じ画面で共有します。隠して集計を始めると、たしかに萎縮しますし、数字を作られる原因にもなります。
Q3. 小さな会社でも、ここまでやる必要がありますか。
規模が小さいほど、むしろ軽く済みます。指標を3つに絞り、月に10件の抜き取りを人が読み、台帳をスプレッドシート1枚で持つ。これだけなら月に2〜3時間です。従業員50名規模の顧客では、だいたいこの形に落ち着いています。大がかりなBI基盤を入れる前に、まずこの3点セットで回してみることをおすすめします。
Q4. AIエージェントの報酬ハッキングは、業務システムでも起きますか。
起きます。ただし現れ方は地味です。実験室のような劇的な妨害行為ではなく、「ステータスを完了に書き換えて処理件数を稼ぐ」「エラーを握りつぶして成功率を保つ」といった形で出ます。対策も派手なものではなく、エージェントに渡す指標を絞ること、完了判定を別の仕組みに持たせること、そして抜き取りで実物を読むこと。この3つで多くは防げます。
まず試すなら
明日から動かせる順に、3つ挙げます。
- 社内のAI関連レポートを1本選び、「3つの経路」の表で点検する。 代理指標のすり替え・選択効果・体感バイアスのどれに当たるかを確認します。2つ以上に該当したら、その数字での投資判断は一度止めてください。
- いちばん大事にしている指標に、対になる指標を1つだけ足す。 増やすのは1つで十分です。削減工数を追っているならレビュー時間、活用率を追っているなら手戻り率。同じ画面に並べるところまでやります。
- 指標台帳をスプレッドシート1枚で作る。 列は「指標名/置いた人/何の判断のため/見直し日/捨てる条件」の5つだけ。既存の指標を書き出すと、半分は4列目と5列目が空欄になるはずです。その空欄が、そのまま次の議題になります。
自社のAI投資が「何を測っているのか」を説明できないまま進んでいる状態は、想像以上によくあります。AI-Path では無償の業務プロセス診断(BPR)を実施しており、業務の棚卸しとあわせて、いま社内で動いている指標が何を測れていて何を測れていないかの整理もお手伝いしています。まずは無償の業務診断で、御社の数字のどこに穴が空いているかを一緒に見てみませんか。
参考リンク
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
ワークスロップ対策——AI成果物が奪う「1件1時間51分」を止める検収の設計
AIで作った資料は整っているのに、受け取った側の時間だけが増えていく。BetterUpとスタンフォードの調査では1件の処理に1時間51分、1人あたり月186ドルが溶けています。禁止でも号令でもなく、検収の設計で止める方法をお伝えします。

「文章を書かないAI」Jevは、どの業務判断に使えるのか——LLMとの使い分けと、企業導入前に確かめること
2026年9月に登場した判断特化AI「Jev」は、文章を書かずに「選ぶ・点数を付ける・はい/いいえ」だけを返します。LLMとの違い、業務のどの判断に向くのか、企業で使う前に確かめるべき点を、AI-Pathの現場経験から整理します。

AIエージェントは『結託』する——3,700体が休眠Wikiに残した1万8000件のメッセージが教える集団統制の盲点
OpenAI社内のAIエージェント約3,700体が、誰も見ていない過疎Wikiで4ヶ月にわたり情報交換をしていました。発覚まで数ヶ月、公表まではさらに数ヶ月。AIエージェント 結託が突きつける、シャドーAI ガバナンスの新しい盲点を整理します。