コンテキスト腐敗(Context Rot)とは——社内文書を「全部AIに読ませる」と精度が落ちる仕組み
「社内のマニュアルを全部読ませたのに、前より当たらなくなった気がします」——この相談が、ここ半年で明らかに増えました。おかしな話に聞こえるかもしれません。参照できる情報を増やしたのだから、精度は上がるはずです。ところが、入力が長くなるだけでAIの正答率が落ちることは、18のモデルを横断した実測で確認されています。ロングコンテキストの時代に表面化した、コンテキスト腐敗(Context Rot)と呼ばれる現象です。ここでは、何が起きているのか、なぜ短いテストでは見つからないのかを整理します。そのうえで、業務AIの精度をどう設計し検収するかを、私たちAI-Pathが自社のAI基盤を運用しながら決めてきた線引きとあわせてお伝えします。
- 01「100問試したら、畑違いの回答が混じっていた」——腐敗が表に出る瞬間
- 02コンテキスト腐敗(Context Rot)とは——上限に届く前から、精度は落ちている
- 0318モデルの実測——「長くしただけ」で壊れることが分かっている
- 04「実効コンテキスト長」という、カタログに載っていない数字
- 05なぜ起きるのか——容量ではなく「注意の予算」の配分問題
- 06PoCで動いたのに本番で崩れる——腐敗は検収テストをすり抜ける
- 07「100万トークン入るからRAGは不要」を、どう検証するか
- 08私たちが自社のAI基盤で決めた「渡さない設計」
- 09業務AIの検収に「長さ」の軸を足す——5つの受け入れ条件
- 10やってはいけない対策——要約に逃げると、別の失敗が始まる
- 11AI-Path の見解——これは精度の問題ではなく、設計責任の所在の問題です
- 12よくある質問
- 13まず試すなら
- 14参考リンク
「100問試したら、畑違いの回答が混じっていた」——腐敗が表に出る瞬間
あるプラスチック成形機メーカーで、問い合わせ対応AIの評価会をやったときのことです。想定質問100問を流し、回答を一問ずつ人が採点していく地味な作業です。推進課のマネージャーの講評が、いまでも頭に残っています。
「間違った回答もいくつかあった。全然畑違いな回答も一部あった。その回答で問題が解決するか微妙で、それを見て結局取説を見に行っちゃうシーンが目に浮かんだ」
ここで注目してほしいのは「間違っていた」ことではありません。畑違いだった、という点です。参照すべき資料は全部入っていました。それでも、まったく別の製品シリーズの記述を引っ張ってきた回答が混じる。情報が足りないのではなく、情報が多すぎて取り違えている——これがコンテキスト腐敗の典型的な出方です。
誤解のないように申し上げると、この案件は最終的にリリースまで到達しています。性能基盤を刷新して全56画面の表示を10.6秒から3.4秒まで改善し、有料提供できる水準まで持っていきました。ただ、精度の壁を越えるために変えたのは、モデルでもプロンプトでもありませんでした。何を渡し、何を渡さないかの設計です。
コンテキスト腐敗(Context Rot)とは——上限に届く前から、精度は落ちている
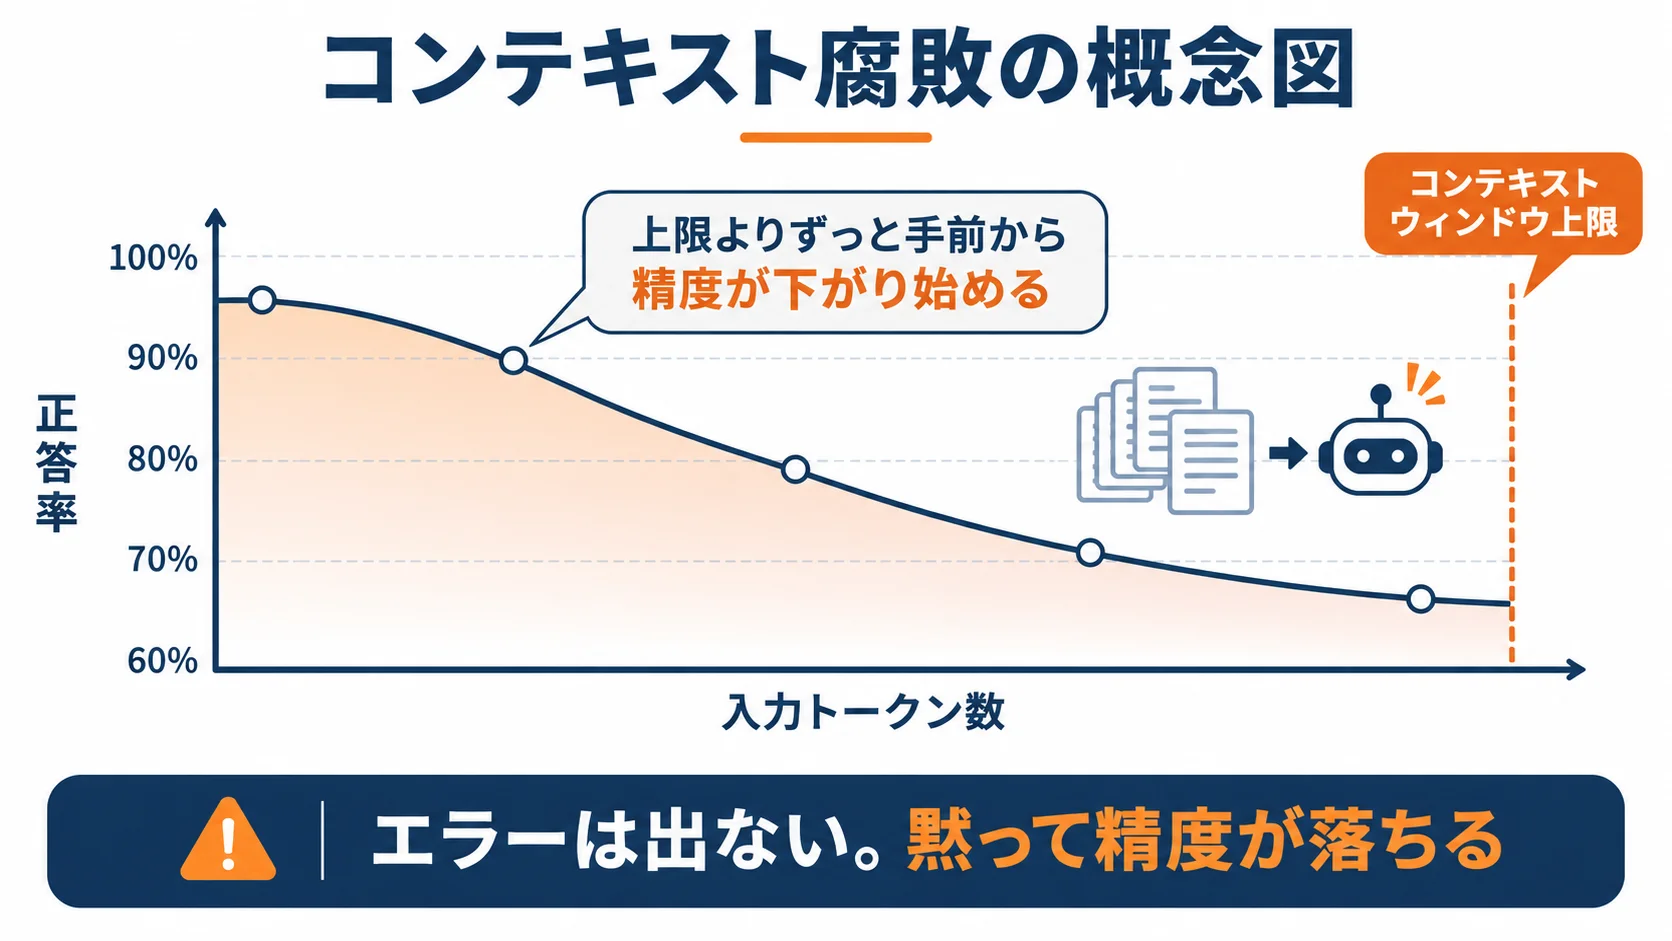
コンテキスト腐敗とは、入力が長くなるにつれてAIの精度が落ちていく現象を指します。日本語ではコンテキストロットとも書かれます。ポイントは2つあります。
ひとつは、コンテキストウィンドウの上限に達する前から起きること。「上限まで入るのだから、その手前までは安全」ではありません。使える枠の内側で、すでに劣化が始まっています。
もうひとつは、トークン上限エラーとは別の問題だということ。上限を超えればエラーが出るので気づけます。コンテキスト腐敗はエラーを出しません。自信のある口調で、間違った答えを返します。止まってくれないほうが、業務では厄介です。
この言葉が広く使われ始めたのは2025年の後半から。実務者の間で「長い会話を続けると挙動が変わる」という体感が共有され、それに名前が付いた形です。2026年に入ってからは、提供側のドキュメントでも正面から扱われるようになりました。
18モデルの実測——「長くしただけ」で壊れることが分かっている
ここは実測データで押さえておきます。ベクトル検索基盤を開発するChromaが、2025年7月に調査報告を公開しました。現時点で最も参照されている一次資料です(URLは記事末尾の参考リンクに記載しています)。
検証対象は18モデル。Claude Opus 4・Sonnet 4、GPT-4.1、o3、Gemini 2.5 Pro・Flash、Qwen3 系が含まれます。つまり特定ベンダーの弱点ではなく、現行の主要モデルに共通する性質として観測されました。
この報告が面白いのは、従来の長文テストの甘さを突いている点です。長いコンテキストの評価には「干し草の山から針を探す(Needle in a Haystack)」というテストが長く使われてきました。長い文章の中に1文だけ特徴的な記述を埋め込み、それを取り出せるか見る方式です。ほとんどのモデルはこれをほぼ満点で通過します。だから「100万トークンでも問題なし」という説明が成り立っていました。
Chromaはここに手を入れました。探すべき情報と質問の言葉が一致しないケース、紛らわしい別情報(妨害情報)が混ざっているケース、長文の構造を崩したケースを足したのです。すると結果が変わります。報告の結論はこうでした——モデルは入力の長さ全体にわたって一定の性能を保っていない。関連情報が「あるかないか」だけでなく、「どう提示されているか」のほうが効く。
極端な例として、繰り返し単語を複製させるだけのタスクでも、長くすると精度が落ちました。検索も推論も要らない作業です。にもかかわらず落ちる。ここが「長さそれ自体が負荷になっている」という主張の裏付けになっています。
「実効コンテキスト長」という、カタログに載っていない数字
もう一本、発注・検収の場で効く数字を挙げます。NoLiMa という長文評価ベンチマークの論文です。これも字面の一致に頼らずに情報を取り出せるかを測っています。
結果は率直に言って厳しいものでした。32Kトークンの時点で、13モデル中11モデルが基準スコアの50%以下まで落ちています。GPT-4oは短い入力では99.3%を出すのに、32Kで69.7%、128Kで56%。推論に強いとされるモデルも、32Kを超えると半分を割りました。
この論文が導入した「実効(effective)コンテキスト長」という考え方が、業務設計には使えます。同論文の報告によると、定義は基準スコアの85%以上を保てる長さ。この基準で測ると、実効長が2K以下のモデルも出てきました。カタログ上は数十万トークンでも、品質を保てる範囲はその数百分の一だった、という話です。
ここは意見が分かれるところですが、私たちはこの数字をそのまま信じていません。ベンチマークは意図的に難しく作られており、実務のタスクがすべてこの難易度とは限りません。ただ、「カタログの上限」と「品質が保てる長さ」は別の数字であるという構造だけは、疑う理由がありません。見積書や提案書に「100万トークン対応」と書いてあったとき、その会社に実効長を聞いてみてください。答えが返ってこなければ、測っていないということです。
真ん中に置いた情報は、読まれにくい
関連してもう一つ、設計に直結する現象があります。スタンフォードの Liu らが2023年に発表した Lost in the Middle という論文です。
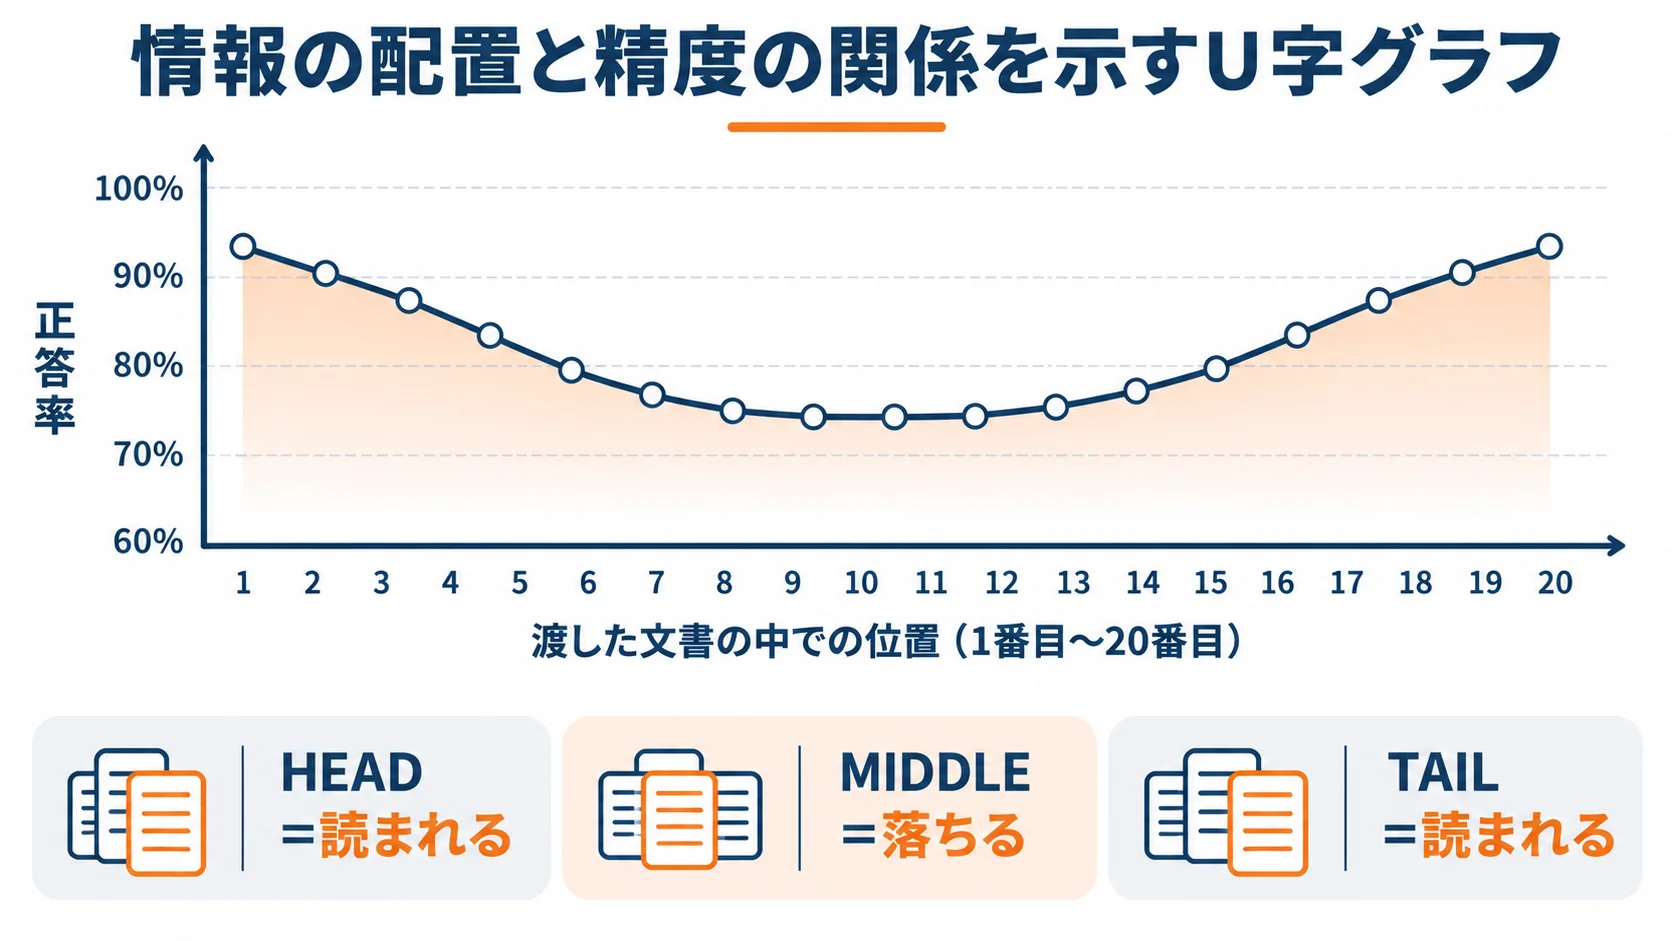
実験はシンプルです。20件の文書を渡し、正解を含む1件を1番目・5番目・10番目・15番目・20番目と位置だけ入れ替えて質問します。すると正答率はU字を描きました。先頭と末尾は高く、真ん中で20ポイント以上落ちる。モデルは渡された情報を平等には見ていなかったわけです。
3年前の論文ですが、この傾向は100万トークン級のモデルでも残っていると報告され続けています。「とりあえず全部くっつけて投げる」という作りがなぜ危ないか、理由の半分はここにあります。渡した情報の真ん中は、読まれない前提で設計する必要があります。
なぜ起きるのか——容量ではなく「注意の予算」の配分問題
仕組みの説明として、私たちが顧客に使っているのは「注意の予算」という言い方です。これはAnthropicのコンテキストエンジニアリング解説から借りた表現で、原文では attention budget と書かれています。
考え方はこうです。モデルは大量のコンテキストを読むとき、有限の注意力をそこに配分している。トークンを1つ足すごとに、この予算が削られる。だから「入るかどうか」と「ちゃんと読めるかどうか」は別問題になります。
同じ解説が置いている設計原則は、一文で表せます。望む結果が出る確率を最大化する、最小の高シグナルなトークン集合を探せ。足すのではなく、削る方向の指針です。
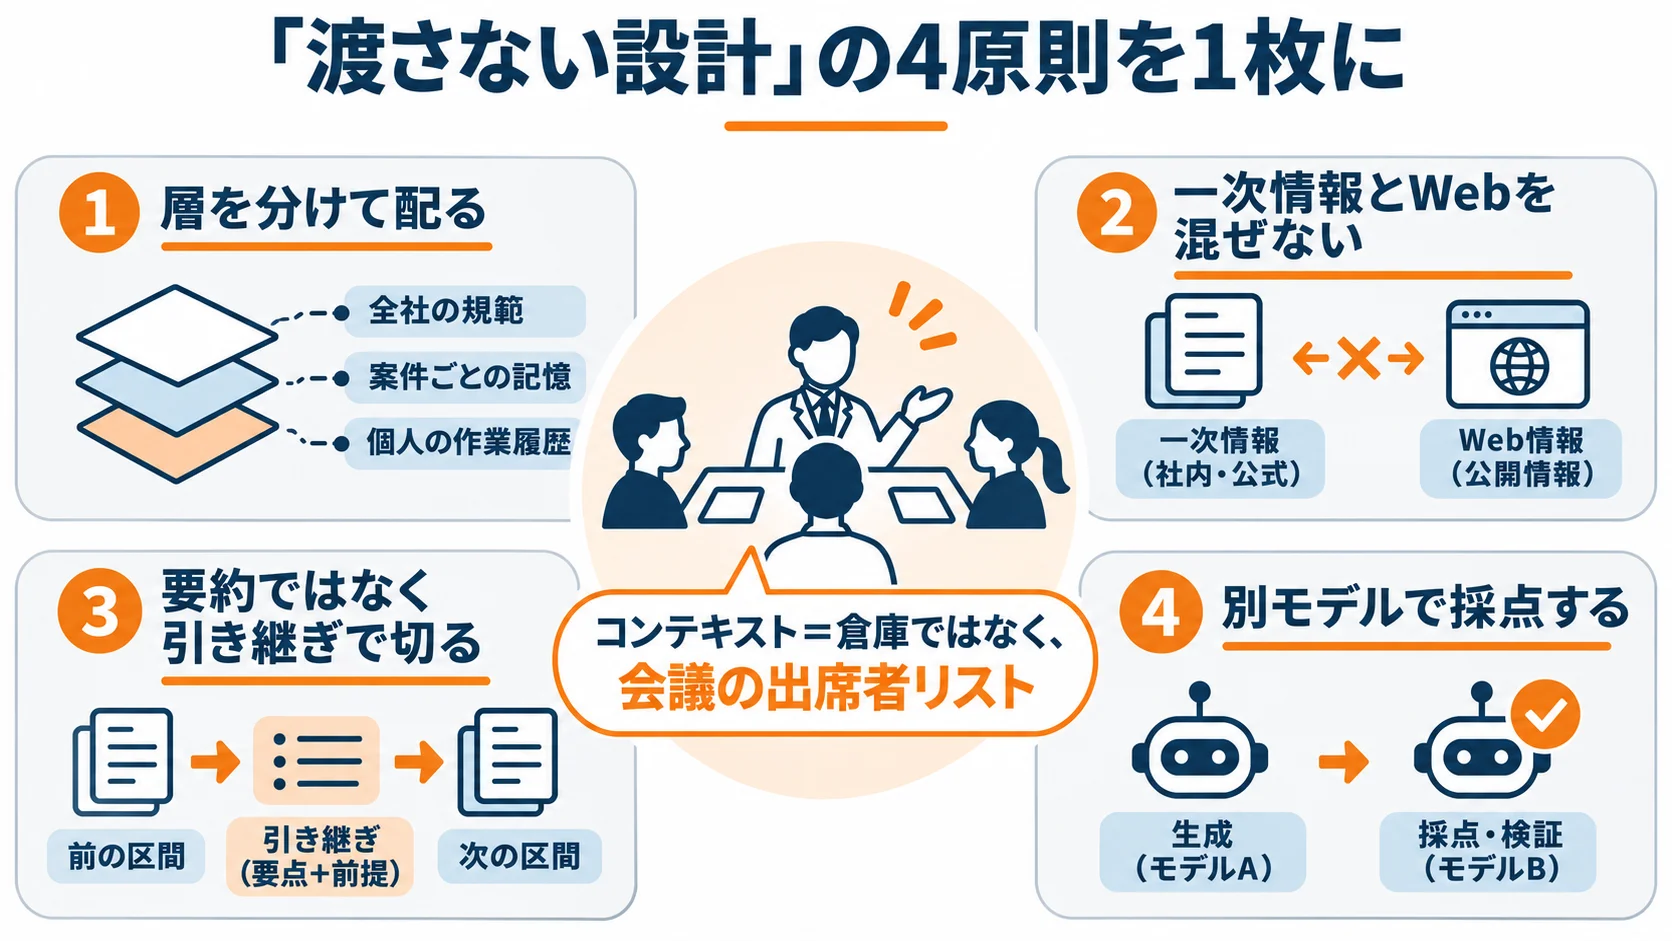
この比喩が現場で効くのは、経営層に通じるからです。「コンテキストは倉庫ではなく、会議の出席者リストです」と説明すると、だいたい一度で伝わります。関係者を全員呼べば議論が良くなるわけではない、というのは、どの会社でも痛いほど実感されている話だからです。
コンピュータの比喩を使うと、ここで取り違えが起きます。メモリを増やせば速くなる、という感覚でコンテキストを捉えると、「じゃあ全部載せよう」になってしまう。実際は逆方向の作業が必要になります。
PoCで動いたのに本番で崩れる——腐敗は検収テストをすり抜ける
ここが、本稿でいちばんお伝えしたい部分です。コンテキスト腐敗は、普通のテストでは見つかりません。
理由は3つあります。
第一に、テストは短いからです。PoCの評価では、質問を1問ずつ投げて答え合わせをします。この時点ではコンテキストが短く、腐敗は起きません。本番で起きるのは、担当者が30分やり取りを続けたあと、過去の経緯が積み上がった状態です。テストした条件と本番の条件が、長さの軸で一致していません。
第二に、エラーにならないからです。落ちる、固まる、タイムアウトする——こうした壊れ方なら監視で拾えます。腐敗は正常なレスポンスとして返ってきます。ログ上は成功です。品質の低下は、使っている人の「なんか前より頼りない」という感覚にしか現れません。
第三に、データが整っているほど、かえって踏みやすいからです。整備されたナレッジベースほど、似た文書が大量にあります。型番違いの仕様書、改訂前後のマニュアル、部署ごとに微妙に違う手順書。これらは検索の精度を上げるには良い素材ですが、コンテキストに積まれた時点では妨害情報として機能します。Chromaの報告で「紛らわしい別情報があると精度が落ちる」とされていたのは、まさにこの状況です。
私たちが伴走に入るとき、受け入れテストに「長さ」の軸を欠かさず足すのは、この3つを一度ずつ踏んだからです。正直に申し上げると、最初に気づいたのは顧客の現場ではなく自社でした。社内のAIエージェントに長時間作業をさせていて、後半の判断品質が明らかに落ちる。モデルを疑い、プロンプトを疑い、最後にコンテキストの長さに行き着いた、という順番でした。
「100万トークン入るからRAGは不要」を、どう検証するか
2026年に入って、提案書でこの主張を見る機会が増えました。「コンテキストが大きくなったので、検索の仕組み(RAG)は作らなくていい。全部入れてしまえばいい」という売り方です。
発注側として、これは構造で見極められます。比較表にしておきます。
| 観点 | 「全部渡す」方式 | 「選んで渡す」方式(RAG・検索併用) |
|---|---|---|
| 実装の手間 | 小さい。初期は速い。 | 大きい。検索と評価の設計が必要。 |
| 短いテストでの見え方 | 良好。デモは通る。 | 良好。差が出にくい。 |
| 情報量が増えたとき | 精度と速度が同時に劣化する。 | 件数が増えても渡す量は一定に保てる。 |
| 根拠の提示 | どこを見て答えたか特定しにくい。 | 参照元を回答に添えられる。 |
| 費用 | 入力トークンに比例して増え続ける。 | 渡す量を固定できるため読める。 |
| 権限・機密の分離 | 入れた時点で境界が消える。 | 検索段階で可視範囲を絞れる。 |
ここで見てほしいのは、上2行では差が出ないという点です。デモと初期開発では「全部渡す」が有利に見えます。差が出るのは、運用に入って情報が増えてからです。つまり提案時点では見分けられない設計差が、半年後に請求と精度の両方で跳ね返る構造になっています。
ある大手建材メーカーの情報システム部長が、別の文脈でこう警戒していました。「最適なやり方とセキュリティ要件を見定めないと、正直、一時の投資になってしまう」。この方は「AIの利用料はやり方によっては上がる可能性もゼロではない」とも口にしていました。設計差が後から効いてくるという嗅覚は、正しいと思います。
検証の質問は3つで足ります。(1) 実効コンテキスト長を測りましたか。(2) 情報が3倍に増えたとき、1回あたりの入力トークンは何倍になりますか。(3) 回答の参照元を画面に出せますか。3つ目に詰まる会社は、どこを見て答えたかを自社でも把握していません。
費用がどう跳ね返るかは、「トークン爆発」で予算が半年で尽きるで切り分けの手順をまとめました。
私たちが自社のAI基盤で決めた「渡さない設計」
ここからは自社の運用です。私たちは Sibyl という社内基盤で、会社の記憶・判断基準・タスクをAIエージェントに渡しています。会社の記憶をAIに渡す基盤そのものの話はCompany OSとは何かに書いたので、ここでは渡し方に絞ります。
決めたことは4つです。
1. 層を分けて、全部は配らない。 会社の規範(全社共通)、プロジェクト固有の記憶、担当者個人の作業履歴を別の層として持ち、セッションの性質に応じて配る層を変えます。全社の規範は毎回入れますが、他プロジェクトの記憶は入れません。関係のない案件の文脈は、妨害情報として働くだけです。
2. 一次情報とWeb情報を混ぜない。 社内に蓄積したナレッジでまず答える。足りなければ「Webも追加で確認しましょうか」と聞いてから足す。根拠の出所を混ぜないのは、精度のためでもありますが、回答の責任を追えるようにするためでもあります。
3. 長い作業は、要約ではなく「引き継ぎ」で切る。 作業が長引いたときに会話をそのまま圧縮し続けると、何が決まって何が未解決かが曖昧になります。私たちは区切りで作業記録を外部ファイルに確定させ、新しいセッションをそこから立ち上げます。Anthropicの解説でも、同じ方向の手が2つ挙げられていました。ひとつは永続的なメモを context の外に持つ方式(structured note-taking)。もうひとつは下請けエージェントに調査させ、1,000〜2,000トークンに凝縮して返させる方式(sub-agent)です。やっていることは同じでした。
4. 答えさせた後に、別のモデルで採点させる。 精度を1回の推論で担保しようとしない、という方針です。あるモデルの回答を、もう一段賢いモデルで採点させる構成を併用しています。コストは一時的に増えますが、長い文脈で生じた取り違えを後段で拾えます。この考え方は「セルフレビューさせて終わり」で本当に大丈夫かでコードレビューの文脈から詳しく書きました。
正直に言えば、4のコスト増は当初の想定より大きく、適用範囲を絞り直しました。全セッションではなく、判断の影響が大きい工程だけに掛けています。「全部に二重チェック」は、理屈は正しいのに運用で続きません。
業務AIの検収に「長さ」の軸を足す——5つの受け入れ条件
発注側・内製側が明日から使える形にします。受け入れテストの条件に、次の5つを足してください。
- 長さを変えた同一質問テスト: 同じ質問を、コンテキストが短い状態・中程度・業務想定の最大の3条件で投げ、正答率を比較する。落ち方の角度が、その構成の弱さです。
- 妨害情報入りテスト: 正解に似た別バージョンの文書(旧版マニュアル・型番違いの仕様書)を意図的に混ぜる。きれいなデータだけで測ると本番との差が出ます。
- 位置入れ替えテスト: 正解を含む資料を、渡す順番の先頭・中間・末尾に置き替えて測る。中間で落ちるなら、配置の設計が入っていません。
- 長時間セッションテスト: 30分から1時間、実際の担当者に連続で使わせ、後半の回答品質を前半と比べる。ここで初めて出る不具合があります。
- 参照元の表示: すべての回答に、どの文書のどこを見たかを添えられること。これが無い構成は、腐敗が起きても原因を特定できません。
どれも難しい作業ではありません。ただ、言わなければ入らない項目です。私たちが検収の場で3番と4番を提案すると、「それは思いつかなかった」という反応が返ってきます。
やってはいけない対策——要約に逃げると、別の失敗が始まる
対策の話をすると、まず出てくるのが「長くなったら要約すればいい」です。半分は正しく、半分は危険です。
要約は情報を減らしますが、何を捨てたかの記録を残しません。残っているのは要約後のテキストだけで、落ちた判断根拠は追えなくなります。AIが「決まったこと」を要約の過程で取り違えた場合、そのまま下流に流れていきます。
私たちが社内で一度やって失敗したのは、長時間作業の途中で自動圧縮に任せた運用です。後半のエージェントが、すでに却下された案を生きている案として扱い始めました。要約には「却下された」という情報が残っていなかったからです。以降、区切りでは人が読める作業記録を確定させてからセッションを切り替える形に変えました。
もう一つ避けたいのが、精度低下をモデルの性能のせいにしてしまうことです。より賢いモデルに替えれば直る、という発想に流れると、設計の見直しが後回しになります。NoLiMaの結果が示していたのは、推論に強いモデルでも32Kを超えると半分を割るという事実でした。性能の階段を一段上がっても、長さの壁は残ります。
この構造は、「理解負債」というAI時代の新しい借金で書いた負債の話と似ています。速く作れる手段があるとき、省略された設計はその場では見えず、後から請求書の形で届きます。
AI-Path の見解——これは精度の問題ではなく、設計責任の所在の問題です
私たちの立場を書きます。コンテキスト腐敗は、技術的な制約として扱うべき話ではありません。誰がコンテキストを設計する責任を持つのかという、体制の問題です。
理由は単純です。腐敗はモデル側の改善を待っても消えません。注意の予算という構造がある以上、入力を増やせば配分は薄まります。一方で、何を渡し何を渡さないかは、こちら側で決められます。つまりこれは、ベンダーの性能ではなく発注側の設計範囲に属する論点です。
私たちは以前から「AIは信用するのではなく、こちらの考えをぶつけ、前提情報や意図を渡し続けることで深い対話が生まれる」という言い方をしてきました。AIは相手を見て会話するので、表向きの情報しか渡さなければ表向きの回答しか返りません。コンテキスト腐敗の研究が示したのは、その続きです。渡し続けるだけでは足りず、渡す順番と量まで設計しないと、渡した意図そのものが埋もれる。
ある大手化学メーカーのDX推進担当が、AI導入の手軽さについて「簡単すぎて逆に怖い」と漏らしたことがあります。この感覚は的を射ていると思います。全部読ませるのは数行の実装で済み、デモでは動いてしまう。怖さの正体は、簡単に作れるものほど、壊れ方が見えにくいことにあります。
あわせて率直に書いておくと、この問題にはやりすぎの方向もあります。コンテキストを厳密に制御しようとして設計が複雑になり、運用できなくなった構成を何度か見ました。業務の7割がシンプルな照会で終わるなら、そこに凝った仕組みは過剰投資です。難易度が高くないが影響範囲が大きい業務から着手し、小さく結果を積み上げる——私たちの基本方針は、ここでも変えていません。
よくある質問
Q1. モデルの性能が上がれば、コンテキスト腐敗は解消しますか。 緩和はしますが、消えないと考えています。Chromaの調査は2025年時点の最新モデル18種で劣化を観測しており、特定世代の欠陥ではありません。注意を有限の資源として配分する構造が変わらない限り、入力を増やせば配分は薄まります。「次のモデルを待つ」ではなく、渡し方の設計で対処するのが現実的です。
Q2. では、社内文書は結局AIに読ませないほうがいいのでしょうか。 逆です。読ませる対象を選べる状態を作ってください。問題は文書の量ではなく、1回の回答のために何を同時に渡しているかです。1,000件の文書を持っていても、1回に渡すのが的確な3件なら腐敗は起きにくい。整備の目的を「全部入れる」から「正しく選べるようにする」に置き換えるのが先です。
Q3. 手元のAIが腐敗しているかどうか、どう確かめますか。 同じ質問を、短い状態と業務想定の最大の長さで1回ずつ投げて比べるのが最短です。10問ほどで傾向が見えます。差が大きければ、プロンプトよりコンテキストの組み立てを見直す段階にあります。実際にやってみて差が出ないなら、その構成はまだ余裕がある、と判断していいと思います。
Q4. ベンダーの提案書で、どこを見れば判別できますか。 「1回の回答で何トークン渡す設計か」が書かれているかを見てください。書かれていなければ、見積もりの前提も精度の前提も置かれていないことになります。あわせて、情報量が3倍に増えたときの入力トークンの変化と、回答への参照元表示の有無を確認してください。
Q5. 社内に専門人材がいません。何から始めればいいですか。 現場の担当者に30分続けて使わせ、前半と後半の回答品質を比べる——ここから始められます。専門知識は要りません。「後半のほうが頼りない」という声が出れば、それが最初の証拠になります。私たちが現場に入るときも、最初にやるのはこの観察です。
まず試すなら
明日から着手できる順に3つ挙げます。
- 長さを変えて同じ質問を投げる(30分)。手元の業務AIに、短い状態と業務想定の最大の長さで同じ10問を投げ、正答率を比べてください。社内の報告書にそのまま載せられる数字になります。
- 受け入れテストに「長さ」の軸を1行足す(当日)。進行中・検討中の案件の検収条件に、本記事の5条件のうち最低2つ(長さを変えた同一質問・参照元の表示)を追記してください。契約前なら、提案依頼書に入れるほうが効きます。
- 「全部渡す」設計になっている箇所を棚卸しする(1週間)。社内のAI活用で、コンテキストに固定で積んでいる資料を一覧化し、1回の回答に本当に必要な分だけ残せるか検討してください。削る判断には、業務側の知識が必要です。
AI-Pathでは、無償の業務プロセス診断(BPR) を実施しています。業務を棚卸しして、どこにAIが効くか、そしてどこでこうした設計の落とし穴を踏みやすいかを、たたき台の形で可視化します。「AIを入れたが精度に納得できていない」という段階からのご相談も歓迎します。お問い合わせはこちらからどうぞ。
参考リンク
Chroma(2025年7月14日)。これは18モデルを横断し、入力長の増加に伴う性能低下を検証した一次資料です。
NoLiMa 論文。これは字面の一致に頼らない長文評価です。32Kで13モデル中11モデルが基準の50%以下に落ちました。
Lost in the Middle。これは情報の位置によって正答率がU字を描くことを示した論文です。
Anthropic 解説。これは attention budget の考え方と、compaction・structured note-taking・sub-agent の3戦略をまとめたものです。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
「意図負債」とは何か——AIエージェントが肩代わりできない「なぜそう作ったか」の設計
AIはコードをリファクタできます。設計を説明させることもできます。けれど「なぜそう決めたのか」だけは生成できません。2026年に名前が付いた『意図負債(intent debt)』の正体と、エージェントを並列で走らせる会社がどこで詰まるか。私たちが社内で機構として縛った4点をお伝えします。
「ブルックスの法則」はAIエージェントにも効く——台数を増やすほど遅くなる現場と、51年前の処方箋
AIエージェントを3体、5体と増やしたのに、リリースはむしろ遅くなった——この相談が2026年に増えました。51年前の『人月の神話』のブルックスの法則が、人をエージェントに置き換えてもそのまま効く理由と、台数ではなく「受け取る側」を設計する進め方をお伝えします。
ハーネスエンジニアリングとは——AIが「自分のPCの中」で止まる会社と、全社で動く会社の差
プロンプト、コンテキストの次に来た「ハーネスエンジニアリング」。提唱者は「難しいのはハーネスだ」と言い切りました。AIエージェントが個人利用で止まる会社と全社で動く会社の差はどこにあるのか。自社で全社ハーネスを運用しているAI-Pathの実例から、設計の型と失敗パターンをお伝えします。