「ブルックスの法則」はAIエージェントにも効く——台数を増やすほど遅くなる現場と、51年前の処方箋
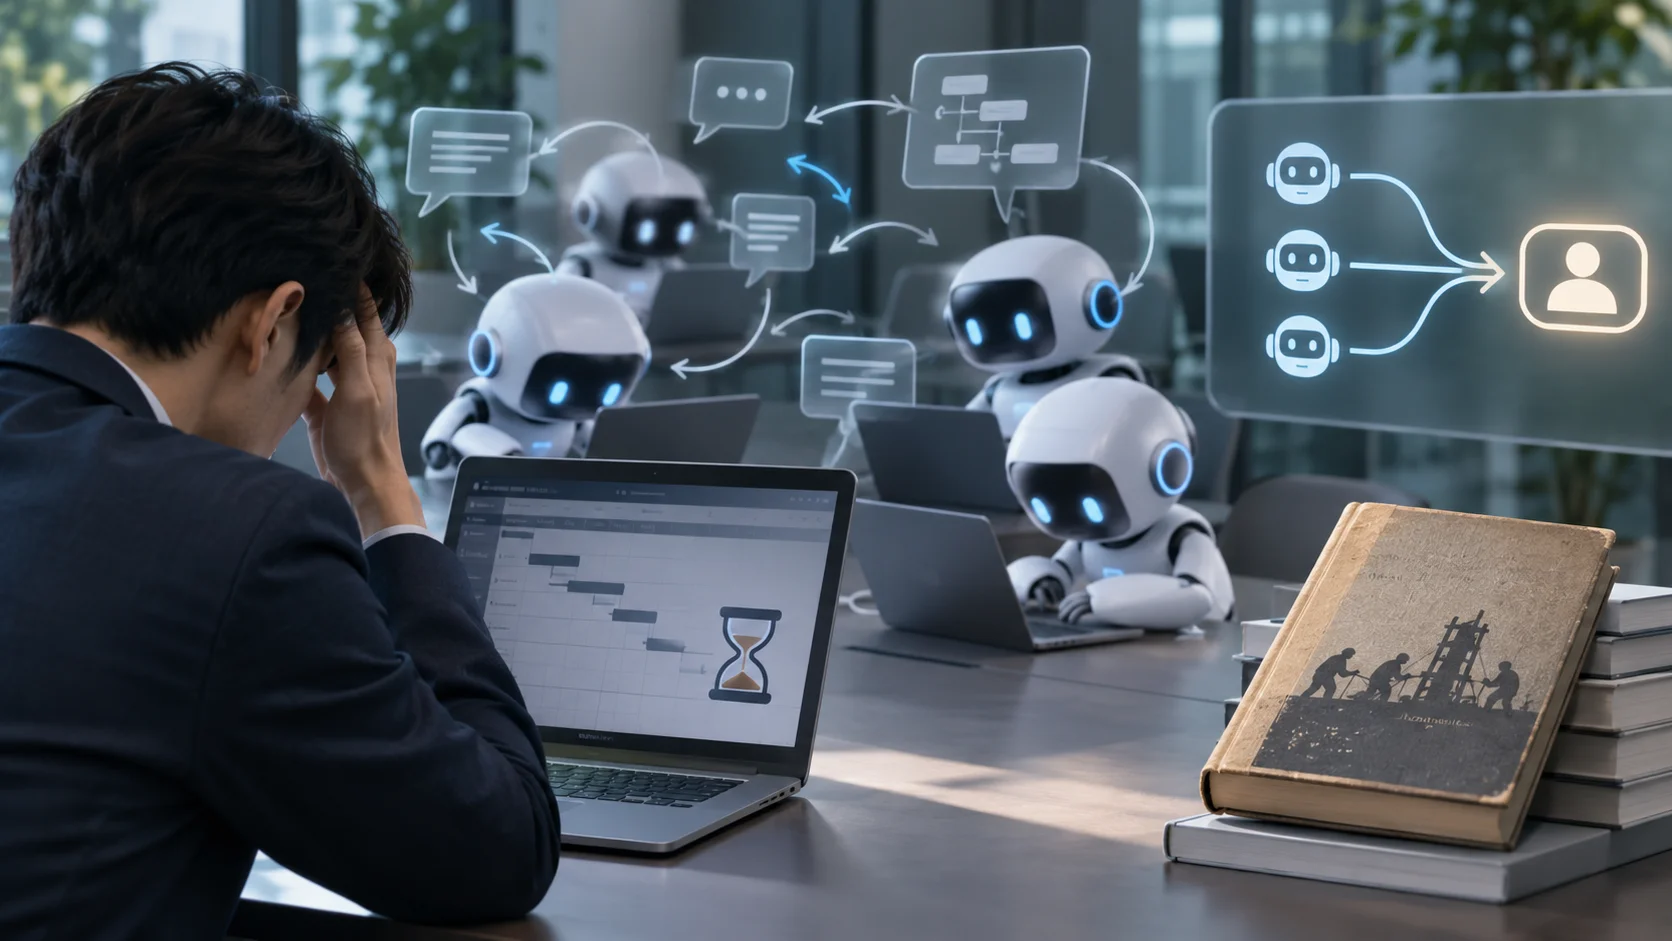
「エージェントを3体に増やしたんですが、前より遅くなった気がします」。先日、ある中堅メーカーの情報システム部門の方から、半ば笑い話のようにこう相談されました。AIエージェントを並列で走らせる運用は2026年の開発現場でほぼ常識になりました。ところが台数を増やした会社から、揃ってこの声が上がっています。原因は性能ではありません。51年前に書かれた一冊が、すでに答えを書いていました。ここでは「ブルックスの法則」がAIエージェント時代にそのまま効く理由と、台数ではなく受け取る側を設計する進め方を、私たちAI-Pathの並列運用の実際を交えてお伝えします。
「3体に増やしたら、前より遅くなりました」
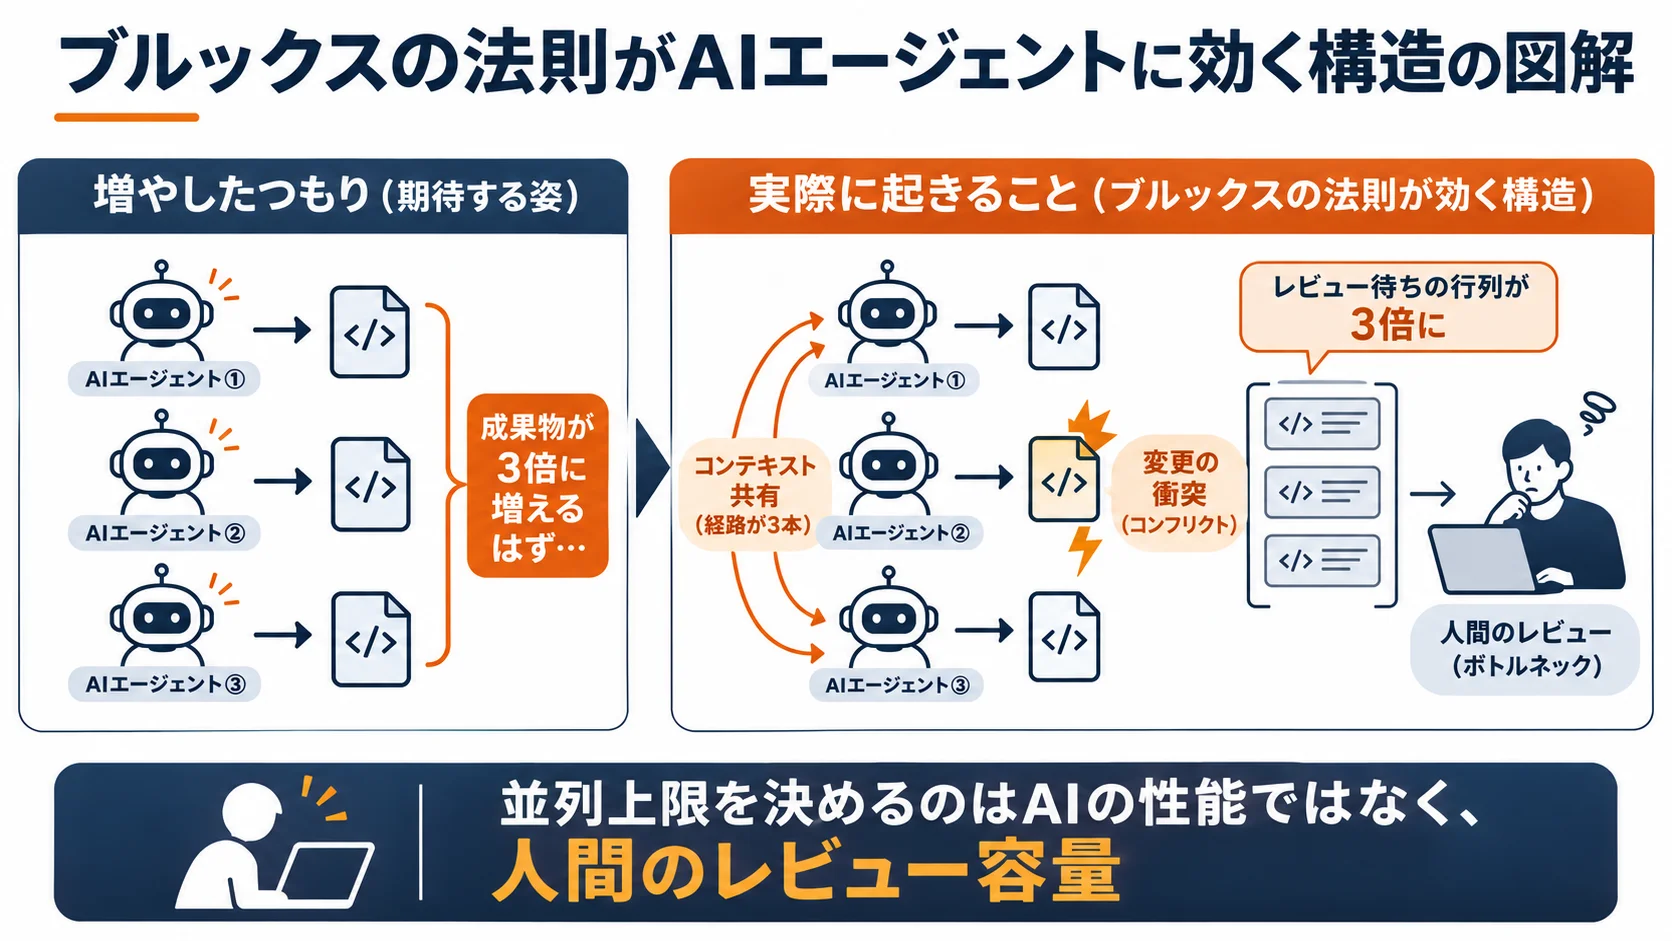
冒頭の相談をもう少し具体的に書きます。その会社では、git worktree を使ってAIエージェントのセッションを3つ立て、それぞれに別の機能を実装させる運用を始めていました。狙いは単純です。1体で1機能なら、3体で3機能。計算上は三倍になるはず。
実際に起きたのは、別のことでした。3体はたしかに動き、朝にはそれぞれプルリクエストが上がっている。ところがレビューするのはひとりのままです。1本あたり40分かかるレビューが3本たまり、午前がまるごと消える。しかもレビュー中に2体目が「関連する既存コードも直しました」と勝手に範囲を広げていて、1体目の変更と衝突している。結局その日にマージできたのは1本だけでした。
「動くものは3倍できているのに、世に出る量は変わらないんです」。この一言が、問題の全部を言い当てています。増えたのは生産ではなく、待ち行列でした。
似た話は規模の大きい会社でも聞きます。ある重工・製鋼メーカーのシステムグループマネージャーからは、こんな話を聞きました。開発にAIを入れてコールを30%削減したという社内の報告をQC発表で出したが、評価が悪くてあまり響かなかった、と。個人の手元では明らかに速くなっている。なのに組織の成果として誰も認めてくれない。並列化の話と地続きの、同じ構造の不満です。
51年前の本が、この答えを先に書いていた
この現象には名前があります。ブルックスの法則です。
フレデリック・ブルックスが1975年に出した『人月の神話』に登場する一文です。内容は「遅れているソフトウェアプロジェクトに人員を追加すると、さらに遅れる」。IBM の System/360 という巨大OSの開発を率いた経験から書かれました。Wikipedia に単独の項目があるほど、ソフトウェア業界では古くから知られた経験則。2026年は出版から51年目にあたります。
なぜ人を足すと遅れるのか。理由は2つあります。ひとつは、新しく入った人が立ち上がるまでに時間がかかること。もうひとつが本質で、人数が増えるとコミュニケーション経路が指数的に増えることです。2名なら経路は1本。4名なら6本。10名なら45本になります。情報を伝え、すり合わせ、齟齬を直す手間だけが先に増えていく。
マーティン・ファウラーも2026年にこの本を読み直しています。そこでも、法則の肝はまさにこの通信経路の複雑さにあると整理されていました。経路を注意深く設計しないかぎり、作業はすぐに崩れていく——と。
さて、ここで冒頭の話に戻ります。worktree を3つ立てて3体のエージェントを走らせたとき、増えたのは何でしょうか。手は3本になりました。同時に、すり合わせるべき経路も3本になっています。しかもその経路の終点は、全部ひとりの人間です。
正直に言えば、私たちも最初はこの構造を軽く見ていました。相手が人間ではなくAIなら、コミュニケーションコストは減るはずだ、と。減ったのは「気を遣う手間」だけでした。
「速くなった気がする」は、実測と19%ずれている
もうひとつ、認めづらいデータがあります。出典はMETR のランダム化比較試験です。
これは熟練したオープンソース開発者16名に、自分がよく知るリポジトリの実際の課題246件を解かせた実験でした。AIツールを使う場合と使わない場合で、所要時間を比べています。
同調査によると、結果は3つの数字で並べると残酷です。
- 作業前、開発者自身は「AIで24%速くなる」と見込んでいた。
- 作業後、「20%速くなった」と感じていた。
- 実測は「19%遅かった」。
体感と実測が約40ポイントずれています。ここで大事なのは、被験者が初心者ではないこと。自分のコードベースを熟知した熟練者であり、つまり人間側のコンテキストがいちばん濃く、AI側がいちばん不利な条件での測定です。だからこの19%を「AIは役に立たない」と読むのは間違いだと思います。読むべきはこちらです——人は、AI併用時の自分の速度を正しく見積もれない。
これが並列化の判断を歪めます。「3体にしたら3倍速い気がする」という感覚は、METR が測った体感の過大評価とまったく同じ性質のものです。感覚を根拠に台数を増やすと、増やした分だけ待ち行列が伸びているのに、増やした本人だけがそれに気づけない。先ほどの情報システム部門の方が「遅くなった気がします」と言えたのは、むしろ健全な感覚でした。
AIエージェントの「コミュニケーションコスト」はどこに出るか
人間同士なら、コミュニケーションコストは会議と雑談とSlackに出ます。相手がAIエージェントなら、どこに出るのか。私たちが運用の中で見てきたのは、次の4箇所です。
| 出る場所 | 具体的に起きること |
|---|---|
| レビュー待ち行列 | 台数ぶんのプルリクエストが同時に届き、ひとりのレビュー容量で律速される。 |
| コンテキストの再供給 | 各エージェントに「なぜそう作るか」を個別に渡し直す手間が台数ぶん増える。 |
| 重複と抜け | 2体が同じ調査を別々にやる、あるいは両方が「相手がやるはず」で抜ける。 |
| トークンと待ち時間 | 1体の遅いエージェントの完了を全体が待つ。費用も台数に比例して増える。 |
4つ目は数字でも裏が取れます。Anthropic の報告によると、通常のチャット利用に比べて、トークン消費は単体エージェントで約4倍。マルチエージェントでは約15倍に膨らみます。同じ記事のなかに、マルチエージェント構成が単体構成を内部評価で90.2%上回ったという結果も載っています。
この2つの数字を並べると、話が立体的になります。並列化は効くのです。効くけれど、15倍の燃料を使う。両方が同時に本当だ、というのが読み取るべきところだと思います。
つまり並列化は「無料で手が増える」話ではありません。手が増えるかわりに、調整と費用と検証が増えます。ブルックスが書いた構造が、単位をエージェントに置き換えてほぼそのまま再現されている——これは私たちにとっても発見でした。
誤解のないように言えば、だから並列化をやめろという話ではありません。私たち自身、並列で走らせることをやめる気はまったくないのです。ただ「何が増えるのか」を先に知っておかないと、増やす判断を間違えます。
DORAが測った「増やすほど不安定になる」構造
もう少し組織の目線に上げます。
Google Cloud の DORA チームが『ROI of AI-assisted Software Development』(2026.1版)を出しています。AI開発の生産性と投資回収を実務的に扱った、数少ないレポートです。約5,000人規模の調査をベースにした前年版からの続きで、読みどころは景気のいい話ではない部分にあります。
ひとつ。AIの採用度が上がるとスループット(リードタイムとデプロイ頻度)は向上する。同時に不安定性(変更失敗率・デプロイのやり直し率)も上がる。速く出せるようになるが、壊れる率も上がる。この2つは同時に起きます。
ふたつ。同レポートの調査によると、導入初期に生産性がいったん落ちる「Jカーブ」があり、試算モデルでは15%の低下が3か月続く前提が置かれています。原因として挙げられているのが、学習コストと「verification tax(検証税)」。AIが出したものが正しいか確かめる作業に、恒常的な税金がかかるという見立てです。これほど的を射た命名はなかなかありません。
みっつ、そしてこれが日本の中堅企業にとっていちばん重い数字です。同レポートの調査によると、生産性の向上幅は、ゼロから作るグリーンフィールドでは35〜40%。一方、既存システムに手を入れるブラウンフィールドでは10%以下でした。
ここは正直に受け止めるべきところだと思います。世の中に出回る「AIで開発が4割速くなる」という話は、だいたい新規開発の数字です。20年分のアドオンが積み上がった基幹システムを抱える会社が同じ比率を期待すると、まず外れます。ある大手化学メーカーの企画部門の責任者は、進行中の基幹刷新について、自分で見ていても出来が良くないと感じる、でももう後戻りできない——と漏らしていました。この種の現場にエージェントを5体投入しても、10%の壁は動きません。動かすべきは別の場所です。
そしてレポートは、リターンの源泉はAIコーディングツールそのものではなく、プラットフォームの品質・ワークフローの明確さ・チームの整合にあると結論づけています。ツールを買う話ではなく、受け取る側の設計の話だ、ということです。
私たちの並列上限は「10体」で、その理由は人間側にある
ここから自社の話をします。
私たちAI-Pathは、おそらく世の中の平均よりかなり踏み込んで並列運用をしています。寝ている間もAIに指示を出し続け、1週間で4〜5個のプロダクトを作る。デスクトップに議事録・需要予測・スライド生成・マーケティングのツールを並行で走らせる。社内ではこの働き方を「エージェントマネージャー」と呼んでいます。
その私たちが、社内ルールとして並列度の上限を明示的に数値で決めています。ひとつのハーネス(エージェントを動かす仕組み)につき最大10体。自律ループは1セッション50回まで、連続実行は4時間まで。
なぜ上限を切るのか。AIの性能が足りないからではありません。10体を超えると、人間の側が受け取れなくなるからです。台数を決める変数はモデルの賢さではなく、レビューと判断の容量。だから上限は人間側の実測から決めています。
ここは意見が分かれるところだと思います。「もっと増やせる」という人もいるでしょうし、実際タスクの質によっては増やせます。ただ私たちの経験では、上限を決めずに走らせた期間がいちばん成果が出ませんでした。走っている本数は過去最多なのに、マージされて顧客に届いたものが少ない。METR が測った錯覚と同じことを、組織の規模でやっていたわけです。
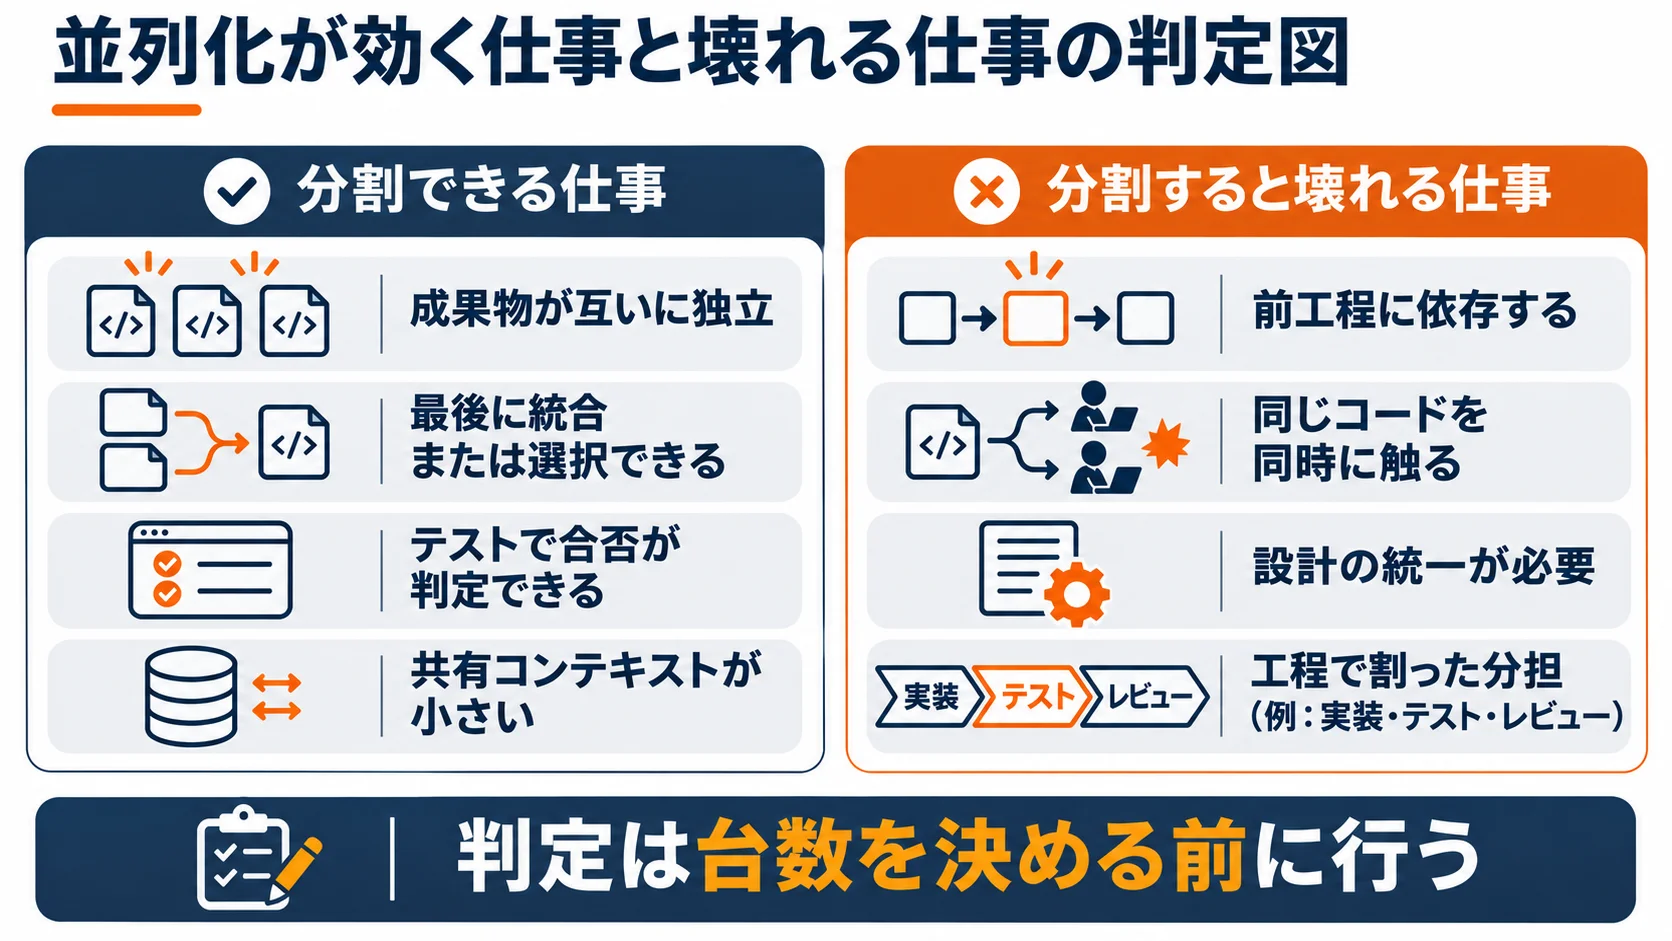
もうひとつ、並列を人にも適用している例を挙げます。短期決戦の案件では、デザイナー3名にトップページだけを先に並行で作らせ、どのテイストが一番いいかを顧客に見てもらう進め方をします。これは「分割しても壊れない仕事」の典型です。成果物が互いに依存しておらず、最後に1つ選べば終わる。並列が効くのはこういう形をした仕事だけです。
ブルックスが本当に言いたかったのは「概念的整合性」だった
ここまではレビュー容量の話です。ただ、ファウラーの読み直しでいちばん重要だと指摘されているのは、ブルックスの法則ではありません。**概念的整合性(conceptual integrity)**です。
ブルックスの主張はこうです。良いけれども互いに独立で非統制なアイデアを多く含んだシステムより、いくつかの変わった機能を省いたシステムのほうが良い。設計の思想が1本通っていることのほうが、機能の網羅性より価値がある、と。ファウラー自身、この考えが自分のキャリアの philosophy を形作ったと書いています。
51年前の指摘が、2026年にいちばん刺さるのはここだと私は思っています。
AIエージェントを並列で走らせると、機能は増えます。問題は、3体がそれぞれ微妙に違う設計思想でコードを書いてくることです。1体目はエラーを例外で投げ、2体目は戻り値で返す。1体目は日付をISO文字列で持ち、3体目はDateオブジェクトで持つ。どれも単体では正しく、レビューでも弾く理由が見つからない。半年後、その差分の集積が「誰も全体を説明できないシステム」になります。
症状はデータにも出ています。GitClear の調査によると、コピー&ペーストされたコードの比率が8.3%から12.3%に、書き直し率が5.5%から7.9%に増加しました。重複が増え、書いたものをすぐ捨て直す回数が増えている。これは生産量が増えた証拠であると同時に、整合性が緩んだ証拠でもあります。
私たちが社内でこれを「理解負債」と呼んでいるのは、まさにこの現象を指しています。コードは速く書けるのに、開発が遅くなる会社の共通点は、量ではなく整合の喪失にありました。
ちなみに、ここに決まった正解があるとは思っていません。ただ対策の方向はひとつに絞られます。先に思想を1本書き、全エージェントに同じものを読ませる。私たちの場合、各リポジトリに設計規約を置き、すべてのセッションに読ませる形を取っています。エージェントを増やす前にやることは、台数の設定ではなく、この1本の文書です。
「分割できる仕事」と「分割すると壊れる仕事」
では何を並列にして、何を並列にしないのか。運用して分かった線引きを表にします。
| 並列が効く仕事 | 並列にすると壊れる仕事 | |
|---|---|---|
| 成果物の関係 | 互いに独立している。 | 前工程の結果に依存する。 |
| 触る対象 | 別のファイル・別の機能。 | 同じコード・同じテーブル。 |
| 統合の仕方 | 最後に合わせる、または1つ選ぶ。 | 途中で常にすり合わせが要る。 |
| 合否判定 | テストで機械的に判定できる。 | 人が触って評価するしかない。 |
| 具体例 | 調査の分担、画面の試作、独立した機能追加、テスト生成。 | 設計、データモデル変更、工程で割った分担。 |
いちばんやりがちな失敗は、右下の「工程で割った分担」です。1体に実装させ、2体にテストを書かせ、3体にレビューさせる——一見きれいに見えますが、これは分割ではありません。直列の工程を3名に渡しているだけで、待ち時間と伝達の手間が増えるだけです。ブルックスが人間について書いたことが、そのまま当てはまります。
逆に、調査の分担はよく効きます。独立した調べ物が5本あるなら、5体に投げて最後に統合する。これは経路が最後に1回しか交わらないので、コミュニケーションコストがほとんど発生しません。
51年前の処方箋は、いまもだいたいそのまま効く
ブルックスは問題を指摘しただけでなく、処方も書いています。少人数の「サージカルチーム」に役割を明確に割り振り、設計の統一を1箇所に集める。この発想は、エージェント運用にほぼそのまま移植できます。私たちが実際にやっていることを4つ挙げます。
ひとつ、Issueの粒度を人間が決める。 AIで議事録から一括起票すると、全部が自分の名前の大きな塊になります。丸まっていると何が本当に残っているか分からなくなるので、管理しやすい単位で切る。順番に検証しないと、ここは直ったがここは直っていない、という漏れが起きます。粒度の設計は、ブルックスの言う「通信経路の設計」そのものです。
ふたつ、プルリクエストを経由させる。 メインに直接マージさせない。PRを上げるとAIが中身を確認してレビューし、妥当性を判断してくれる。ただし自己レビューだけでは甘くなるので、私たちは敵対的に検証させる段を重ねています。人間のレビューの前に機械のレビューを1段挟むことで、検証税の一部を機械側に戻せます。コードレビューが速いチームほどデリバリーの成績が良い、という指摘が繰り返されているのは、この一段が効くからです。
みっつ、非エンジニアにはデータベースを触らせない。 自分のブランチをどれだけ汚してもいい。ただしDBを直接いじると、もう後戻りできません。この線引きだけで、並列数を増やしたときの事故の大半が消えます。
よっつ、本番反映は二段階にし、環境を色で分ける。 先にステージングで直して回帰テストが通ってから本番に出す。トレーニング環境は背景を黄色にして、ひと目で本番と区別できるようにしています。地味ですが、エージェントの台数が増えるほどこの地味さが効いてきます。
私たちの現場経験では、増やす前に「受け取る側」を設計する
結論を一言でまとめます。AIエージェント並列実行の台数は、人間のレビュー容量を超えた瞬間から、増やすほど遅くなります。
だから私たちは、顧客の内製支援に入るとき、エージェントの設定より先に受け取る側を見ます。具体的には3つ。レビューの担い手が何名いて1本に何分かかるか。設計思想を書いた文書があるか。機械が先に検証する一段が入っているか。この3つが整っていない状態で台数を増やす提案はしません。順番を逆にすると、増やした分がそのまま待ち行列になるだけです。
ここで強調したいのは、これが技術の話ではなく設計の話だということです。私たちはFDE(フォワードデプロイドエンジニア:顧客の現場に入り込んで本番コードまで書くエンジニア)として現場に入ります。最初の数週間でやることの多くは、コードを書くことではありません。この受け取り方を顧客と一緒に組み立てることでした。報告書ではなく、現場で毎日動いて使われる仕組みを残す——そのためには、速く作る力と同じくらい、速く受け取る力が要ります。
そしてもうひとつ、率直に書いておきます。ここで挙げた処方は、既存システムが複雑な会社ほど効果が出るまで時間がかかります。DORA の調査が示すブラウンフィールド10%以下という数字から逃げるつもりはありません。ただ、その壁を動かす道は、台数ではなく整合性と検証の側にしかない、と私たちは考えています。
よくある質問
Q. エージェントは結局、何体までが適正ですか。 A. 絶対の正解はありません。決め方だけお伝えすると、「1本のレビューにかかる時間 × 1日に処理できる本数」から逆算します。1本40分・1日4本が上限なら、同時に走らせる数は4本前後が現実的です。私たちは社内ルールとして上限10体を置いていますが、これは機械のレビューを1段挟んだうえでの数字です。
Q. レビューをAIに任せれば、上限は外れますか。 A. 一部は外れます。ただし全部は外れません。機械のレビューは規約違反・重複・明らかな欠陥を拾うのが得意で、「この機能はそもそも要るのか」という判断は人が持ったままです。私たちも単体テストとシナリオテストは自動化していますが、ユーザー受け入れテストは人が触る工程として残しています。AIが苦手なUXの観点が含まれるからです。
Q. METRの「19%遅い」は、2026年のモデルでも当てはまりますか。 A. あの数値をそのまま現在に当てはめるのは無理があります。測定は2025年初頭のツールで行われたもので、エージェントの能力はその後明確に上がりました。それでも使える教訓は残っています——体感と実測は大きくずれるという部分です。ずれる方向はいつも「速くなったと感じる」側でした。
Q. 既存の基幹システムが複雑で、効果が薄いなら意味がないのでは。 A. 全体を一気に作り直すなら、おっしゃる通り割に合わないことが多いです。私たちが取るのは、裏のデータベースはそのまま使い、制御を細かく組みやすい新しいアプリ側を作り直す進め方です。この形だと刷新の範囲が絞れますし、権限や監査を細かく設計できるので、セキュリティレベルはむしろ上がります。
Q. 社内に展開したいのですが、自分のパソコンの中で止まっています。 A. これは本当によく聞きます。ある大手化学メーカーの事業企画の責任者も「今使えているのは自分のパソコンの中まで。なぜ他の人のところまで広げられないのかが分からない」と話していました。止まる原因はツールではなく、権限・コンテキストの配り方・レビューの受け皿が個人の環境にしか無いことです。先に受け取る側の仕組みを会社の側に置くと、同じツールでも広がり方が変わります。
まず試すなら
明日から試せる順に3つ挙げます。
- 並列上限を数字で決める。 1本のレビュー時間を実測し、1日の処理可能数から同時実行数を逆算して、上限を明文化します。感覚で増やすのをやめる、これだけで詰まりが見えるようになります。
- 設計思想を1枚書き、全セッションに読ませる。 エラーの扱い・日付の持ち方・命名・テストの方針。A4で1枚あれば十分です。台数を増やす前にこれを置くかどうかで、半年後の整合性が変わります。
- 人間のレビューの前に、機械のレビューを1段入れる。 直接マージを禁止し、PR経由だけに限定します。これで検証税の一部を機械に戻せます。
そのうえで、「どの業務に並列化が効いて、どこで壁にぶつかるのか」を切り分けたい場合は、業務そのものの棚卸しから入るほうが確実です。AI-Path では、**無償の業務プロセス診断(BPR)**を実施しています。ヒアリングから業務フロー・改善案・投資回収の試算までをたたき台として可視化し、どこにAIが効くかを一緒に見極めるところから始めます。台数を増やす前に増やすべき場所を特定するほうがずっと速い、というのが私たちの実感です。
参考リンク
DORA「AI支援開発のROI」2026.1版 これは生産性・不安定性・Jカーブの出典です。
Martin Fowler の再読エントリ これは概念的整合性の出典です。
Anthropic これはトークン消費の出典です。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
「意図負債」とは何か——AIエージェントが肩代わりできない「なぜそう作ったか」の設計
AIはコードをリファクタできます。設計を説明させることもできます。けれど「なぜそう決めたのか」だけは生成できません。2026年に名前が付いた『意図負債(intent debt)』の正体と、エージェントを並列で走らせる会社がどこで詰まるか。私たちが社内で機構として縛った4点をお伝えします。
ハーネスエンジニアリングとは——AIが「自分のPCの中」で止まる会社と、全社で動く会社の差
プロンプト、コンテキストの次に来た「ハーネスエンジニアリング」。提唱者は「難しいのはハーネスだ」と言い切りました。AIエージェントが個人利用で止まる会社と全社で動く会社の差はどこにあるのか。自社で全社ハーネスを運用しているAI-Pathの実例から、設計の型と失敗パターンをお伝えします。
「敵対的レビュー」は入れただけでは効かない——仕込みバグ15個の実測が示す、AIコードレビューの検収設計
OpenAIの公式プラグインで「敵対的レビュー」はコマンド一つになりました。ところが仕込みバグ15個の実測では、その敵対的レビューが最下位。差がついたのはモデルではなく「観点を誰が決めたか」でした。発注側が決めるべき検収項目を整理します。