Company OSとは何か——AIエージェントに「会社の記憶」を渡す基盤と、大半が止まる3つの壁
「今使えているのは、自分のパソコンの中までなんです。なぜ他の人のところまで広げられないのか、それが分からない」——先日、ある大手化学メーカーで企画業務を統括する部長が、こう漏らしました。生成AIは個人の手元では動いている。けれど会社としては何も動いていない。同じ状態の会社を、私たちはこの1年で何十社も見てきました。
原因はAIの性能ではありません。会社の記憶と判断基準が、AIに渡せる形になっていないこと。ここに尽きます。この穴を埋める基盤を指して、2026年から「Company OS」という言葉が使われ始めました。
この記事では、Company OSとは何か、社内ChatGPTやRAG(社内ナレッジをAIに検索させて回答精度を上げる技術)と何が違うのか、なぜ大半の取り組みが途中で止まるのかをお伝えします。私たちAI-Path自身がこの基盤を毎日動かしています。運用で踏み抜いた失敗も含めて書きます。
- 01Company OSのよくある質問【5問5答】
- 02「自分のパソコンの中までは動く。でも、隣の席には広がらない」
- 03Company OSとは何か——「記憶・規範・実行」の3層で捉える
- 042026年、大手が一斉に「OS」を名乗り始めた——誰の定義に乗るかという経営判断
- 05社内ChatGPT・RAG・業務SaaSと、何がどう違うのか
- 06壁1: 記憶が「追加業務」になった瞬間に、貯まらなくなる
- 07壁2: 貯めても「配られない」——判断基準が共有されない
- 08壁3: 権限と監査が無い基盤は、そもそも業務に入れられない
- 09私たちは自社でCompany OSを回しています——記録から規範までの循環
- 10「AI社員」より先に「会社のOS」——自社に必要かを5つの問いで確かめる
- 11AI-Pathの見解——Company OSは「製品」ではなく「運用」です
- 12まず試すなら
- 13参考リンク
Company OSのよくある質問【5問5答】
私たちがこのテーマでご相談をお受けするとき、ほぼ毎回いただく質問が5つあります。先に1問1答でお答えし、そのうえで詳しくご案内します。
Q1. Company OS(カンパニーOS)とは何ですか
会社の記憶と判断基準を、AIが参照できる形にまとめた土台のことです。議事録・顧客とのやり取り・過去の判断とその理由・現場のルール——こうした情報を、人だけでなくAIエージェントが読める状態に整えます。AIエージェントとは、人の代わりに判断して作業を進めるAIプログラムのこと。その上で業務が回るようにした基盤を、Company OSと呼びます。「企業OS」「会社のOS」も同じ意味です。製品名ではなく状態を表す言葉として使われている点に、注意が必要です。
Q2. 社内ChatGPTやRAGを入れることと、何が違うのですか
社内ChatGPTは「聞いたら答えてくれる窓口」、RAGは「探して引っ張る仕組み」です。業務SaaS(クラウドで提供される既製の業務サービス)なら「決まった型で業務を回すもの」。どれも入口・検索・型の話で、情報が貯まり続ける仕組みは含みません。Company OSは、業務のなかで記憶が自動的に貯まり、それが判断基準として全社のAIと人に配られ、誰が何をどこまで見てよいかが制御される——この循環までを含みます。検索だけ入れて記憶が貯まらない、という状態が最も多い失敗です。
Q3. 何から始めればいいですか。いくらかかりますか
全社一斉ではなく、1部署の1業務から始めてください。私たちは業務プロセス診断(BPR)で業務を棚卸しし、記憶が消えている箇所を特定してから着手します。費用は規模と対象業務で変わるため、ここで一律の金額は書きません。ただし私たちの場合、動くプロトタイプは1日で作ってお見せします。資料ではなく動くものを見ながら判断していただく進め方です。最新の費用感は無償の業務プロセス診断(BPR)でご確認ください。
Q4. 社内情報をAIに渡すことになります。漏洩は大丈夫でしょうか
この質問が一番多く、そして一番大事です。ある大手化学メーカーのDX推進担当者は、導入の手軽さについて「簡単すぎて逆に怖い」と率直に漏らしました。私たちはこれを技術論ではなく設計の問題として扱います。機能単位でのアクセス権分離、操作の監査ログ、人間の承認を挟む工程、閉域環境でのローカルLLM(社外にデータを出さずに社内で動かすAI)という選択肢——この4点を前提に組みます。守れない設計の基盤は、業務に入れるべきではありません。
Q5. 「AI社員を作る」のと、どちらを先にやるべきですか
Company OSが先です。順序を逆にすると、AIエージェントを作るたびに「わが社はこういう会社で、この業務はこう進めて……」という説明から始めることになります。毎回ゼロから教え直す相手が増えるだけで、会社としての蓄積はゼロのままです。記憶と判断基準の置き場所を先に作る。これが遠回りに見えて最短です。
「自分のパソコンの中までは動く。でも、隣の席には広がらない」
まず、冒頭の部長の言葉に戻ります。この一言には、2026年の日本企業が直面している壁がそのまま入っています。
その会社では、生成AIの利用自体は進んでいました。本人も使いこなしている。ところが、その成果が他の部署に渡らない。渡し方が分からない。本人にとっては素朴な疑問でしたが、私たちには原因が見えていました。彼が手元で蓄積していた「このデータはこう読む」「この取引先はこういう事情がある」という文脈が、全部その人のチャット履歴の中にあったのです。
同じ会社の別の担当者は、社内開発の停滞をこう語っていました。「『内製できます』と謳いつつ、実際は難しい」。生成AIの利用は情報システム部門に限られる一方、社長からは「アウトプットが出てこない」というプレッシャーがかかる。この板挟みも、原因は同じところにあります。個人の工夫が、会社の資産になる経路がない。
さて、ここで押さえておきたいことがあります。この問題は「AIをもっと使おう」では解決しません。使うほど個人に知見が溜まり、会社との差が開くだけです。必要なのは、溜まる先を個人の端末から会社側へ移すことでした。
Company OSとは何か——「記憶・規範・実行」の3層で捉える
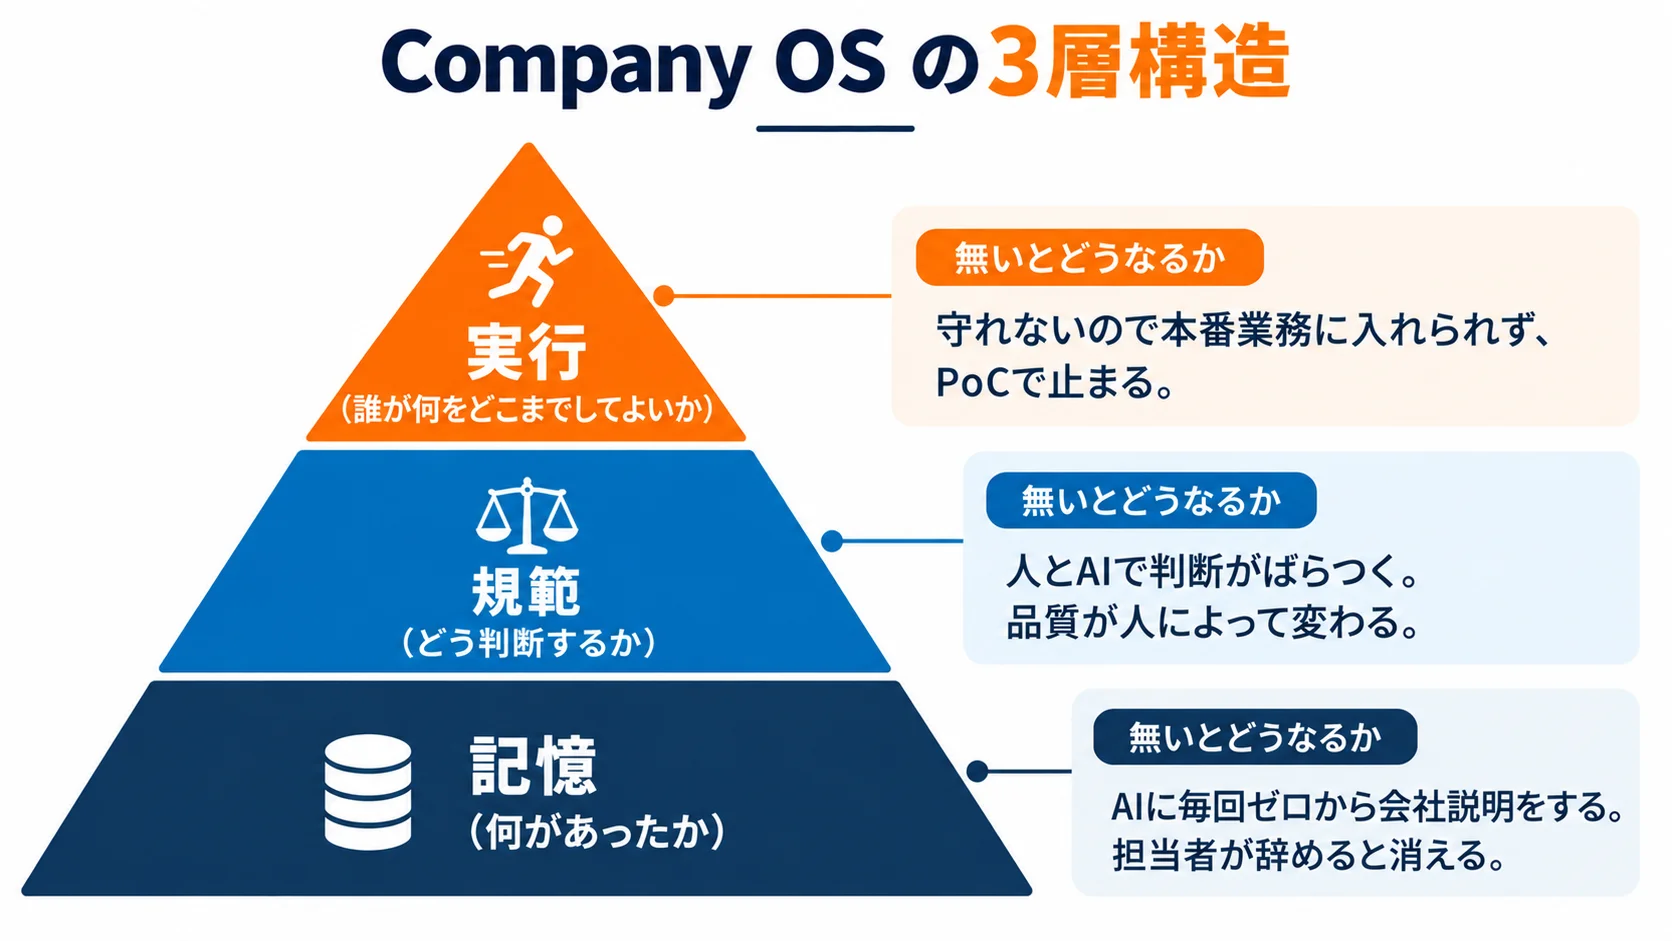
結論から書きます。Company OSとは、会社の記憶と判断基準を、AIが使える形にした土台です。そして、これは買ってくる製品ではなく、会社ごとに作る状態を指します。
言葉の整理から入ります。日本語では「カンパニーOS」「会社のOS」「企業OS」と4通りの表記が混在していて、定義も書き手によって違います。情報基盤の設計として語る人、AI社員の前提条件として語る人、事業承継の文脈で語る人——どれも間違いではありませんが、議論がかみ合いません。私たちは3つの層に分けて整理しています。
| 層 | 何を置くか | 無いとどうなるか |
|---|---|---|
| 記憶 | 議事録・やり取り・過去の判断とその理由・現場の暗黙知 | AIに毎回ゼロから会社説明をする。担当者が辞めると消える |
| 規範 | 判断基準・社内ルール・やってはいけないこと | 人とAIで判断がばらつく。品質が人によって変わる |
| 実行 | 誰が何をどこまでしてよいかの権限・承認・監査 | 守れないので本番業務に入れられない。PoC(概念実証)で止まる |
この3層が揃って、初めて「会社として」AIが動きます。逆に言えば、どの層が欠けているかで、自社の詰まっている場所が分かります。
誤解のないように申し上げると、記憶の層だけを立派にしても動きません。ここは後の「壁2」で詳しく書きます。社内文書を全部ベクトル検索にかけられるようにしたのに、誰の仕事も変わらなかった——という例を、私たちは実際に見ています。
2026年、大手が一斉に「OS」を名乗り始めた——誰の定義に乗るかという経営判断
Company OSという言葉が急に増えたのは偶然ではありません。2026年、この領域に大手が相次いで旗を立てました。時系列で見ると流れがはっきりします。
6月13日、GoogleがAIエージェント向けの文書フォーマット「Open Knowledge Format(OKF)」を発表しました。中身は意外なほど地味です。MarkdownにYAMLのヘッダーを付けるだけ。新しいランタイムもSDKも要りません。組織の知識を「AIが読めるファイル」として持ち運べるようにする、ベンダー中立の仕様です。派手さはありませんが、記憶の層に標準を置こうという動きだと私たちは読みました。
そして10月7日、NTTドコモビジネスと日本IBMが動きました。AIガバナンス領域での協業について、基本合意書を締結しています。NTTドコモビジネスが2026年度末から2027年度にかけて段階提供する「Trusted Data Fabric」は、3つの領域で構成されます。1つめが、AIエージェントの判断と行動を統制する「Trusted AI」。2つめが、AIエージェントに検証可能な身元と委任情報を与える「Trusted Identity」。3つめが、機密情報を守りながら活用する「Trusted Data Access」です。
この発表で私たちが膝を打ったのは、技術の話ではなく問題設定のほうでした。同社は、企業には「誰の代わりに、何を目的に、どの範囲を許されてAIが動いているのかを把握する必要がある」と整理しています。これは私たちが顧客に説明してきた「守れる設計」とまったく同じ論点です。インフラ大手が同じ結論に辿り着いた、という事実は、この領域が思想の段階から実装の段階に移ったことを意味します。
同じ時期に、PwCがAIエージェント基盤「agent OS」を、IBMがwatsonx Orchestrateを「マルチエージェント時代のエージェント制御基盤」として打ち出しました。Cloudflareも10月のイベントで、企業の知識とプロセスを土台にしたAIワークスペースを提示しています。旗の立て方は各社で違いますが、狙っている場所は同じです。
ここで経営判断が1つ発生します。誰の定義に乗るのか、です。ある大手建材・シャッターメーカーの情報システム部長は、複数システムを別々に作る方針をこう警戒していました。「よろしくない。最適なやり方とセキュリティ要件を見定めないと、正直、一時の投資になってしまう」。この懸念は正しいと思います。
ただし、私たちの見方は少し違います。2026年現在、Company OSは「まだ定義が発展途上」の段階です。つまり、今は買う対象ではなく、自社で設計する対象。どのベンダーの枠に自社を合わせるかを急いで決めるより、自社の記憶・規範・実行の3層がどうなっているかを先に把握するほうが得策です。標準が固まってから乗り換えられる形にしておけばいい。OKFがMarkdownという素朴な形式を選んだのは、まさにそのためだと受け取っています。
社内ChatGPT・RAG・業務SaaSと、何がどう違うのか
ここが最も誤解される部分なので、表で整理します。
| 観点 | 社内ChatGPT | RAG検索 | 業務SaaS | Company OS |
|---|---|---|---|---|
| 主な役割 | 聞いて答える。 | 探して引っ張る。 | 決まった型で回す。 | 記憶と規範を配る。 |
| 記憶は貯まるか | 個人の履歴に留まる。 | 既存文書を使うだけ。 | 製品の型に入る分だけ。 | 業務のなかで会社側に貯まる。 |
| 判断の理由は残るか | 残らない。 | 残らない。 | ほぼ残らない。 | 残す対象に含む。 |
| 全社に配られるか | 各自が使うだけ。 | 検索できる人だけ。 | 製品の機能範囲まで。 | 規範として配信する。 |
| 権限・監査 | 製品の設定次第。 | 設計次第で漏れる。 | 製品の粒度に依存。 | 機能単位で設計する。 |
| 担当者が辞めたら | 知見が消える。 | 読み方が消える。 | データは残る。 | 判断の理由まで残る。 |
表の要点は1行です。社内ChatGPTとRAGは入口と検索、業務SaaSは決まった型、Company OSは貯まって配られる循環。役割が違うので、どれかで代替できるものではありません。
そして、ここに業務SaaS側の限界が絡みます。ある大手化学メーカーの上級執行役員は、大手SaaSについて「イニシャルコストも維持コストも高い」と実感として口にしました。別の生産DXグループリーダーは「繋げようとしても縦割りが強く、事業ごとに顧客も機能も全然違う。一つのシステムでは使いづらい」と語っています。既製品に会社を合わせる方式の限界が、AI以前の問題として現場に出ているのです。
私たちが「SaaS is dead」と言うとき、それはSaaSという製品分類が消えるという意味ではありません。業務のロジックを製品ベンダーの中に預けたままにする時代が終わる、という意味です。会社ごとに違う判断基準を、会社の側に置き直す。Company OSはその置き場所になります。
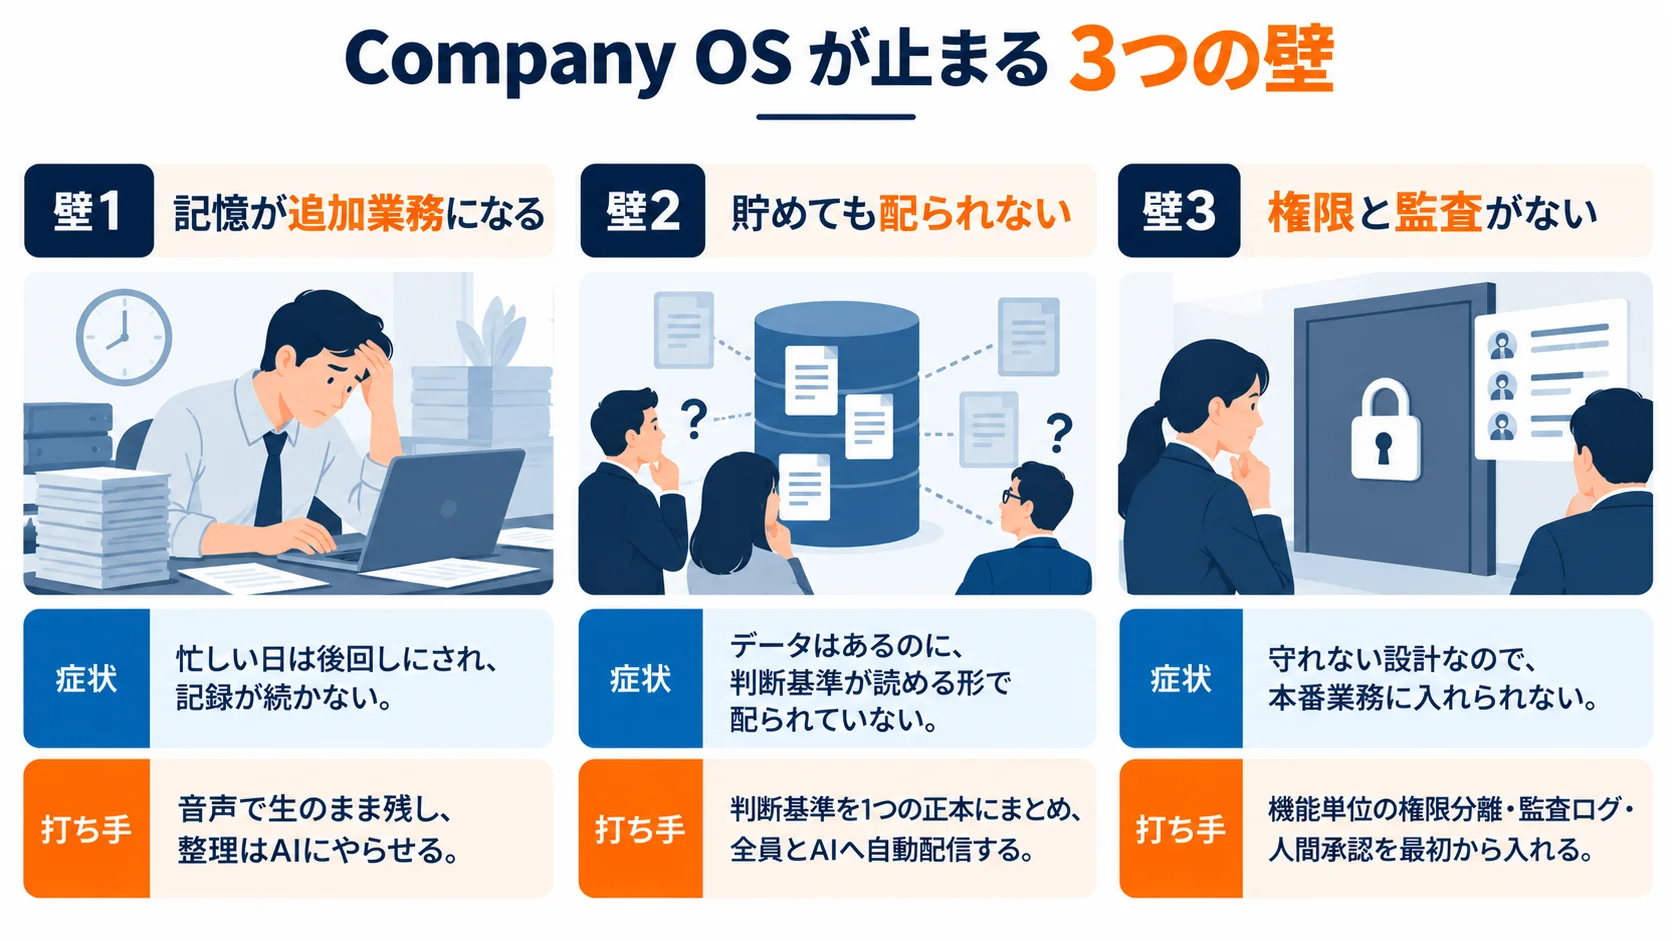
壁1: 記憶が「追加業務」になった瞬間に、貯まらなくなる
ここから、取り組みが止まる3つの壁を順に書きます。1つめは、記憶の入力が誰かの仕事を増やしてしまう問題です。
ある化学メーカーの工場担当者が、記録の実態をこう教えてくれました。「手書きのメモを事務所に戻ってきてから入力しているが、後回しになることもあり、データとして活用しきれていない」「単一のデータとしては存在しても、トレンド管理に落とし込めていない」。同じ工場の保全担当者は、新しい仕組みの定着について「若手社員に『記録が未来に役立つ』という意識を持たせることが必要」と語りました。
正直に申し上げると、意識づけでこの壁は越えられません。私たちも最初はそう考えて、失敗しました。忙しい日に後回しにされる作業は、どれだけ意義を説明しても後回しにされます。
私たちが自社で採った方法は、入力の負荷そのものを下げることでした。「チャットで打つのは大変なので、音声で喋りかけてそれだけ残しておいてもらう。何百件でも何千件でも、ログは多い方がいい。後で横断解析をかけられる」——これが社内の方針です。整った文章を書かせない。要約もさせない。生のまま大量に残して、整理はAIにやらせる。
もう1つ徹底しているのが、記録の目的を監視から切り離すことです。ある大手建材メーカーのグループ会社では、メール解析を導入していますが、現場には一切伝えていません。「評価に使うのではなく、原因分析や課題発見、人を育てるためのフィードバックに限定して使用している」という線引きです。この線を曖昧にすると、記録は歪みます。都合の悪いことが書かれなくなった記憶は、資産になりません。
壁2: 貯めても「配られない」——判断基準が共有されない
2つめの壁は、ここが本題です。記憶を貯める仕組みを作った会社が、次につまずくのはここです。
ある大手化学メーカーのAI推進担当は、AI活用が現場に広がらない理由をこう分析していました。「データはある程度揃ってきているが、そのデータを基に人がどう考え、どう動くかを定義・教育するのが難しい。マニュアルだけでは足りず、行間を読むような仕事をしている」。
この「行間」が、規範の層です。データは記憶、読み方は規範。前者だけ整えても後者が渡らない、というのが日本企業の典型的な詰まり方です。
具体的な形で見たほうが早いでしょう。ある合成樹脂メーカーには、社内で「秘伝のタレ」と呼ばれる工賃表がありました。営業を担当する課長の説明はこうです。「細かすぎて、どこに何が書いてあって、どのケースはどの工賃を使うのかを理解した人じゃないと使えない。新入社員に渡して『これで検索して』と言っても、使いこなすのに時間がかかる」。同社で業務を担当する課長は、原価表についても明かしました。「中身は7割くらいブラックボックス化していて、Excelで配信されるので各担当がそれぞれカスタマイズしてしまう。部材を一つ変えるにも全シートのセルを一個一個探して変える。二重で計上していた箇所もあった」。
データは、ある。むしろ過剰にある。足りないのは「どのケースでどれを使うか」という判断基準が、読める形で配られていないことです。この状態でAIを足すと、間違った表を自信満々に引いてくるAIが1つ増えます。
だからCompany OSでは、配信を仕組みにします。私たちは自社で、判断基準や禁止事項を1つの正本にまとめ、そこから全エージェントの作業環境へ自動配布しています。人が「あのルール、どこだっけ」と探す状態を残さない。ルールを更新したら、次の瞬間から全員と全AIに効く。地味ですが、ここが効きます。
壁3: 権限と監査が無い基盤は、そもそも業務に入れられない
3つめは、最も見落とされていて、最も致命的な壁です。
Gartnerは2025年6月に、こう予測しました。エージェントAIプロジェクトの40%超が、2027年末までに中止される。詳細はRCR Wireless Newsの記事にあります。注目すべきは理由です。コストの増大、不明確なビジネス価値、そして不十分なリスク統制。3つのうち1つが、統制の問題として挙げられています。
この予測を「AIはまだ使えない」と読むのは誤りだと思います。私たちの読み方はこうです。止まっているのはAIの性能ではなく、守れる設計を後回しにしたプロジェクトである。前章で紹介したNTTドコモビジネスと日本IBMの協業が、まさにここを埋めにきています。「判断根拠や評価結果、変更履歴、監査証跡を管理し、説明責任の確保を支援」——大手が揃ってこの文言を出してきたのは、現場でここが詰まっているからです。
顧客の懸念も、だいたいこの層に集まります。先に引いた「簡単すぎて逆に怖い」という言葉のほか、同じ大手化学メーカーの担当者は、技術対策だけでは消えないリスクをこう指摘しました。「工場のPCが破られると中に入られる。ヒューマンエラーのリスクは拭えないのでは」。
私たちがAI-Pathの自社システムで実装している統制を、具体的に挙げます。
- 機能単位の権限分離:資料の閲覧制限ではなく、機能ごとにアクセス権を振り分ける。財務経理・人事系まで分離する。
- 人間の承認を挟む工程:本番への反映は、指示があっても人間確認を通す。
- 二段階リリース:先にステージングで直し、回帰テストが通ってから本番に出す。トレーニング環境は背景色を黄色にして、本番と一目で区別する。
- 移行前の攻撃テスト:顧客の自社環境へ移す前にレッドチームアタックを実施し、本番にはIP制限を入れる。
- 機密を外に出さない選択肢:R&D部門のようにデータ機密性が極めて高い現場では、閉域環境のローカルLLMを前提にする。
誤解のないように書き添えると、これは最初から全部やる話ではありません。1部署の1業務なら、1と2だけで十分始まります。ただし「後で付ける」と決めた統制は、ほぼ付きません。そこだけは経験から申し上げます。
私たちは自社でCompany OSを回しています——記録から規範までの循環
ここまで他社の話が続いたので、自分たちの話を書きます。AI-Pathは、Company OSを顧客に提供する前に、自社で毎日動かしています。「自社で実運用しているものを売る」が、私たちの事業の原則です。
構成は3つのモジュールです。AIPLAが顧客管理・採用・経理・勤怠・ナレッジを束ねる実務のレイヤー。SibylがAIとの対話・業務判断・改善履歴を横断して蓄積する会社のBrain。AI Workspaceが人とAIが同じ業務文脈を共有してタスク・文書・会議を扱う実行環境です。この3つで、記憶・規範・実行の3層を埋めています。
実際に回っているループはこうです。全てのセッションと会議を記録する。記録をAIが解析して、何をやったか・何に詰まったか・何を学んだかに分解する。そこからナレッジの候補を起こし、人が承認したものだけを正本に昇格させる。昇格した判断基準を、全エージェントの作業環境に配信する。次の作業は、その基準を前提に始まる。
私がこだわっているのは、記録の徹底です。会議で「はいはい」と言いながら流していると、1〜2割しか記憶に残りません。記録を残してAIに食わせ、後から再確認する。これだけで成長の速度が変わります。
精度の担保には、別のAIを審判に使っています。あるモデルが出した回答を、より賢いモデルで採点させる。コストは一時的に増えますが、より正しい回答を返すモードが1つ増えます。RAGも一次情報を優先する設計です。「蓄積したナレッジでまず答えて、『ウェブも追加で確認しましょう』と言われたらウェブも入れて答える」と分けています。根拠の出所を混ぜない。これは顧客環境でも同じ設計にしています。
正直に申し上げると、この運用はまだ完成していません。記録の取りこぼし、ナレッジ昇格の滞留、配信の抜け——どれも実際に起きています。ただ、自社で先に踏み抜いて塞いだ穴は、そのまま顧客環境の設計に効きます。RAGのテナント間でのデータ漏れを自社で検知して直した経験も、秘密情報を平文で展開せずに移行する手順も、最初は自社の事故から生まれたものです。
「AI社員」より先に「会社のOS」——自社に必要かを5つの問いで確かめる
順序の話に戻ります。2026年に入ってから、「AI社員を作りたい」というご相談が明らかに増えました。けれど、その前に確かめることがあります。
AIエージェントは、渡された文脈の範囲でしか判断できません。会社の記憶と判断基準が無い状態でエージェントを増やすと、毎回ゼロから会社を説明する相手が増えるだけです。1体なら気になりません。10体に増えたとき、説明コストが会社を止めます。
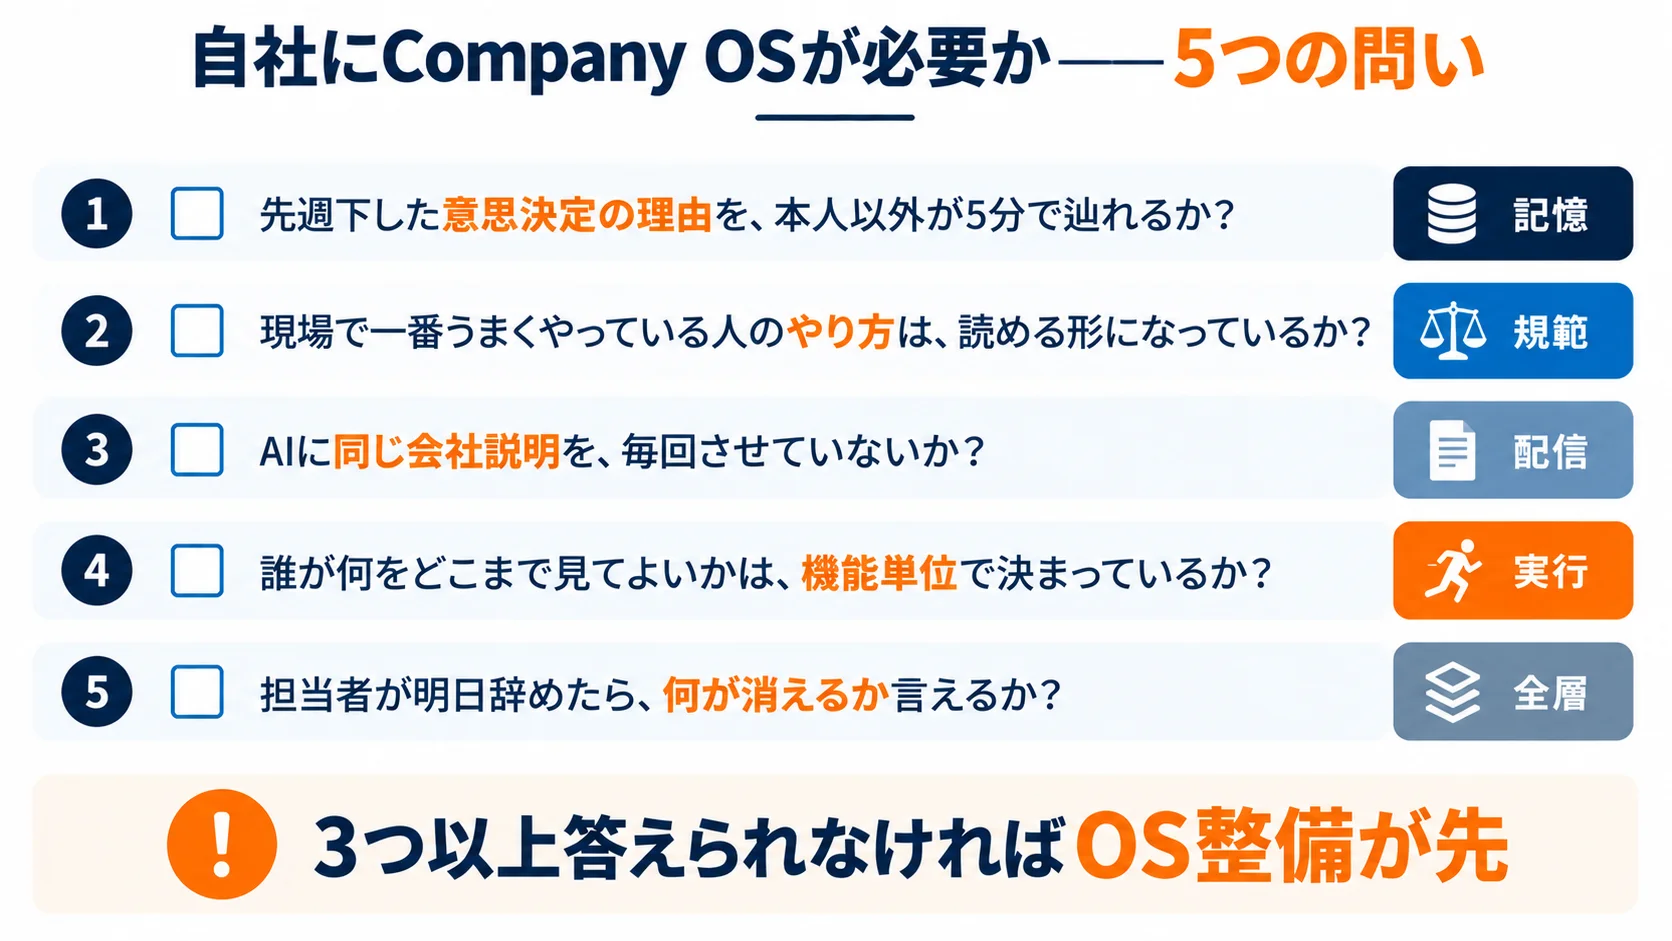
自社の現在地を測るために、私たちが診断で使っている5つの問いを共有します。
- 先週下した意思決定の理由を、本人以外が5分で辿れますか。 (記憶の層)
- 現場で一番うまくやっている人のやり方は、読める形になっていますか。 (規範の層)
- AIに同じ会社説明を、毎回させていませんか。 (配信の有無)
- 誰が何をどこまで見てよいかは、機能単位で決まっていますか。 (実行の層)
- 担当者が明日辞めたら、何が消えるか言えますか。 (全層の総合)
3つ以上に即答できなければ、Company OSの整備が先です。逆に全部答えられる会社なら、エージェントを増やす段階に進んで構いません。
複数の製造業で繰り返し聞くのが「生産管理は会社ごとの違いが大きく、現場の担当者が脳内で判断していることが多すぎる」「優秀な人材がいなくなると業務が滞る」という声です。これは問5が答えられない状態そのもので、AI以前からある課題です。AIはこの課題を解決もしますし、放置すれば加速もさせます。
AI-Pathの見解——Company OSは「製品」ではなく「運用」です
私たちの立場を明確に書きます。Company OSは、買ってきて入れるものではありません。会社ごとに作って、回し続けるものです。
理由は単純で、中身が会社ごとに違いすぎるからです。判断基準は会社の歴史そのものですし、権限の切り方は組織の形そのものです。既製品の型に合わせた瞬間、現場が工夫を重ねてきた業務の強みが削られます。私たちがSaaS導入の時代に何度も見た光景でした。AIによって、ようやくその強みを潰さずにシステム化できる時代が来たと考えています。
ここは意見が分かれるところだと思います。「標準化されたプラットフォームに乗るべきだ」という立場も成り立ちます。実際、病院業界のようにパッケージ文化と標準化が強い領域では、独自開発の余地は製造業より小さい。ある大規模病院の情報システム部長は「スクラッチで作った方が使い勝手は間違いなくいい」と言いました。ただ同部長の説明によれば、診療報酬改定への追随負荷から「今はほとんど99%がパッケージ」に切り替えたそうです。この判断は合理的だと思います。
だからこそ、最初に業務を棚卸しします。競争優位に直結する業務と、標準品で足りる業務を分ける。前者だけを自社の側に置く。全部を自前で持つ必要はありません。
もう1つ、率直に書いておきます。Company OSは短期のROI(投資利益率)が見えにくい投資です。ある重工・製鋼メーカーのシステムグループマネージャーは「開発にAIを入れてコールを30%削減しました、とQC発表で報告したが、全然評価が悪くて、あまり響かなかった」と吐露していました。社内の発表では成果が出ているのに、評価には響かない。基盤の整備となれば、さらに響きません。だから私たちは、目先の疲弊を解消するテーマで先に結果を出しながら、並行して基盤を育てる両輪のロードマップをお示しします。基盤だけを先に立てる提案は、社内で通りません。
関連する論点は別の記事でも書いています。基盤を整えずにエージェントを増やすと何が起きるかは、AIエージェントが『PoC止まり』で終わる本当の理由で書きました。AIが書いたものを誰も理解していない状態の怖さは、「理解負債」というAI時代の新しい借金で扱っています。
まず試すなら
Company OSは全社計画から始めると、ほぼ止まります。翌日から動ける順に3つ挙げます。
- 先週の意思決定を1つ選び、その理由がどこに残っているか探してみてください。本人の頭の中にしかなければ、記憶の層が空だという証拠です。所要時間は10分で足ります
- AIに最も頻繁にさせている説明を、1つだけファイルに出してください。「わが社はこういう会社で」の部分です。毎回打ち込んでいる前提を外に出すだけで、配信の起点ができます
- 1部署の1業務に絞って、記憶が消えている箇所を特定してください。全社の棚卸しは不要です。むしろ有害です
そのうえで、業務全体のどこにAIが効くかを見極めたい段階であれば、AI-Pathの**無償の業務プロセス診断(BPR)**をご利用ください。ヒアリングから業務フロー・改善案・ROIのたたき台までを可視化します。私たちは資料ではなく動くものでご判断いただく方針なので、必要であればプロトタイプを1日で作ってお見せします。
AI導入パートナーの選び方そのもので迷っている場合は、FDEとは何か──AI導入を「成功」させる新しいパートナーの選び方もあわせてご覧ください。
参考リンク
GoogleがAIエージェント向けの文書フォーマット「Open Knowledge Format」を公開(2026年6月13日)。gihyo.jpの記事。
NTTドコモビジネスと日本IBMがAIガバナンス領域で協業し、「Trusted Data Fabric」構想を公表(2026年10月7日)。マイナビニュースの記事。
Gartnerが「エージェントAIプロジェクトの40%超が2027年末までに中止される」と予測(2025年6月25日発表)。RCR Wireless Newsの記事。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
「グッドハートの法則」とAI——「AI活用率」を目標にした瞬間、その数字は成果を測れなくなる
グッドハートの法則とは「指標が目標になると、その指標は良い指標ではなくなる」という経験則です。AIエージェント時代には、この法則が経験則ではなく仕様として働きます。METRの実測、Gartnerの予測、帝国データバンクの調査を手がかりに、壊れにくいAIの測り方を私たちの現場経験からお伝えします。
ワークスロップ対策——AI成果物が奪う「1件1時間51分」を止める検収の設計
AIで作った資料は整っているのに、受け取った側の時間だけが増えていく。BetterUpとスタンフォードの調査では1件の処理に1時間51分、1人あたり月186ドルが溶けています。禁止でも号令でもなく、検収の設計で止める方法をお伝えします。

「文章を書かないAI」Jevは、どの業務判断に使えるのか——LLMとの使い分けと、企業導入前に確かめること
2026年9月に登場した判断特化AI「Jev」は、文章を書かずに「選ぶ・点数を付ける・はい/いいえ」だけを返します。LLMとの違い、業務のどの判断に向くのか、企業で使う前に確かめるべき点を、AI-Pathの現場経験から整理します。