「文章を書かないAI」Jevは、どの業務判断に使えるのか——LLMとの使い分けと、企業導入前に確かめること

2026年9月15日、米スタートアップのTypeSafe AIが「Jev(ジェヴ)」というAIモデルを発表しました。Jevは文章を一文字も書きません。決められた選択肢から「選ぶ」「点数を付ける」「はい/いいえを答える」という判断だけを、確率付きで返すAIです。
結論から言えば、Jevは会話の相手ではなく、業務システムに埋め込む「判断の部品」です。うまく使えば、問い合わせの振り分けや例外の検知といった小さな判断を、ほぼタダ同然のコストで自動化できます。ただし、どの判断を任せ、どこを人が持つかを決めない限り、この部品は現場で活きません。この記事では、Jevとは何か、LLMとどう使い分けるか、企業で使う前に何を確かめるべきかを、私たちAI-Pathの現場経験を交えてお伝えします。
Jevのよくある質問【5問5答】
発表から10日ほどで、私たちのもとにもJevについての質問が届き始めました。寄せられる質問は、「Jev とは何か」「判断AI 業務活用の具体例は」「Jev 企業導入の注意点は」「LLM 使い分け 判断の基準は」の4つにほぼ集約されます。まずは1問1答でお答えし、そのうえで詳しく見ていきます。
Q1. Jevとは何ですか。ChatGPTのようなLLMとは何が違うのですか。 JevはTypeSafe AIが「System One(システム1)モデル」と呼ぶ、判断に特化したAIです。LLM(大規模言語モデル: 文章を一語ずつ生成するAI)は、答えを文章で返します。Jevは文章を生成せず、利用者があらかじめ決めた型に沿って、選んだ答えと確率、確信度だけを返します。会話はできません。その代わり、ソフトウェアの中で「もし〜なら」の分岐を賢く決める役を担います。
Q2. どんな業務に使えますか。 得意なのは、定型的で件数の多い判断です。問い合わせをどの部署に回すか、メールが返信を要するか、報告の緊急度はどれくらいか、といった判断が典型です。LLMが書いた文章に問題がないかを確かめる「見張り役」にも向きます。逆に、文章を書く、理由を説明する、計算するといった仕事はできません。
Q3. 料金と速さはどのくらいですか。 TypeSafe AIの発表によると、応答は70〜500ミリ秒で、入力100万トークン(トークン: AIが文章を処理する単位)あたり0.042ドル、出力は無料です。1件の判定が1円に遠く届かない水準になります。ただし、価格は発表直後の早期段階のもので、変わる可能性があります。最新の条件は公式サイトで確認してください。
Q4. 「ハルシネーションを起こさない」というのは本当ですか。 半分だけ本当です。ハルシネーション(AIがもっともらしい誤りを出力すること)のうち、決めた選択肢の外の答えを返すことは、仕組み上起こりません。ですが、選択肢の中から間違ったものを選ぶことは普通に起こります。型が崩れないことと、答えが正しいことは別の話です。
Q5. 企業の業務で使っても大丈夫ですか。 使えますが、送ってよいデータを先に決める必要があります。Jevは米国のサーバーで動くクラウドサービスで、数値で稼働を保証する契約(SLA)も、発表時点では確認できていません。機密性の高い設計データや人事情報をいきなり流すのではなく、公開しても困らないデータから試すことを私たちは勧めています。詳しい確認点は後半で整理します。
「スマートなif文」——Jevが返すのは文章ではなく「判断」
Jevを一言で表すなら、TypeSafe AI自身が言う「スマートなif文」です。プログラムの中の分岐を、ルールではなくAIの判断で決める部品だと考えると分かりやすくなります。
Jevに投げられる問いは、次の3つの型しかありません。
| 型 | 何を返すか | 業務での例 |
|---|---|---|
| Choice(選択) | 最大255個の選択肢から1つを選ぶ | 問い合わせの担当部署を「経理・技術・営業・その他」から選ぶ。 |
| Score(点数) | 決めた段階の中で点数を付ける | ヒヤリハット報告の深刻度を0〜3で評価する。 |
| Noul(はい/いいえ) | 命題が正しい確率を返す | 「このメールは返信が必要か」に0〜1の確率で答える。 |
どの型でも、Jevは答えと一緒に確率を返します。ChoiceとScoreでは、答えにどれくらい自信があるかを示す「確信度」も付きます。TypeSafe AIの発表によれば、確信度が90%なら実際に9割当たるように調整する独自の学習手法を使ったといいます。
この確率が、業務で使うときの肝になります。たとえば「確信度が0.9以上ならそのまま次の処理へ、それ未満なら人やLLMに回す」という分岐を、コードで素直に書けるからです。ITmediaの解説記事(参考リンク参照)が紹介している通り、同社が「スマートなif文だと考えてほしい」と言うのはこのためです。
ちなみに「Jev」という名前は、19世紀の経済学者ジェヴォンズに由来します。蒸気機関の効率が上がるほど石炭の消費が増えた「ジェヴォンズのパラドックス」の人物です。判断のコストが下がれば、これまでAIに任せようと思わなかった判断にまで使われるようになる——そんな狙いが名前に込められています。
なぜ今、「判断だけのAI」がこれほど注目されたのか
Jevが話題になった背景には、LLMは賢くなったのに業務の自動化はさほど進んでいない、というもどかしさがあります。
開発者のディオゴ・アルメイダ氏は、元OpenAIの研究者で、ChatGPTの前身にあたるInstructGPTの論文の共著者です。同氏はTechCrunchの取材(参考リンク参照)に応じています。そこで語ったのは「私たちは人間の言葉に最適化しすぎた。コンピューターは別の言葉を話す」という反省でした。つまり、会話がうまいAIと、ソフトウェアに組み込みやすいAIは別物だという主張です。これは、私たちが現場で感じてきたことともよく重なります。
同じ記事には、開発現場の反応も紹介されています。Vercelのエンジニアは、コマンドの安全性を判定する分類処理をLLMからJevに置き換えたところ、5〜18倍速く、しかも精度が上がったと述べています。一方、業務メールの分類を比べた別の開発者は、GoogleのGeminiのほうがわずかに正確だったと報告しました。ただし、費用はGeminiが10〜20倍かかったといいます。
この2つの声は、Jevの位置づけをよく表しています。常に最高精度というわけではありません。ですが、「十分な精度を、桁違いに安く速く、しかも確率付きで」という組み合わせは、これまでの選択肢にはありませんでした。発表直後には、Jevに似た仕組みを再現する試みが2日間で6つ公開されるほどの過熱ぶりでした。
現場の業務は、「小さな判断」の積み重ねでできている
Jevが本当に効くのは、華やかなAIエージェントではなく、毎日繰り返される地味な判断です。
私たちが製造業の現場で業務を棚卸しすると、驚くほどの数の「小さな判断」が見つかります。ある中堅製造業では、受注メールを開いて「通常品か特注品か」を見分け、特注なら技術担当に回す作業を、担当者が1日に何十回も繰り返していました。1回は数秒の判断です。ですが、その数秒のために担当者は席を離れられず、休めば仕事が止まります。
複数の製造業から共通して聞くのが、「現場の担当者が脳内で判断していることが多すぎる」という声です。ある医薬・食品メーカーの需要予測担当は、発注画面について「作業者は考えずにボタンを押すだけにしたい。考えたり悩んだりするのは管理者側」と話していました。判断を減らしたいのではありません。判断を置く場所を整理したい、という要望です。
Jevの3つの型に当てはめると、現場の判断はたとえば次のように分解できます。
- 問い合わせの振り分け(Choice): どの部署・担当が受けるかを選ぶ。
- 受注・請求の例外検知(Noul): 通常と違う条件が含まれているかを判定する。
- ヒヤリハット報告の深刻度(Score): すぐ現場を確認すべきかを段階で評価する。
- 日報の異常の拾い上げ(Noul): 設備の不調を示す記述があるかを判定する。
- 稟議の一次仕分け(Choice): 定型承認で済むか、上長確認が要るかを選ぶ。
私たちはこれまで、社内ヘルプデスクのAI内製化について書いてきました。ヒヤリハット報告のAI内製化も同じです。どちらも中身を分解すると、この「小さな判断」の自動化が土台にあります。Jevの登場で、この土台部分のコストが一気に下がったというのが私たちの見立てです。
判断を4つに仕分ける——ルール・Jev・LLM・人
ここで誤解のないように言っておくと、Jevの登場は「LLMが要らなくなる」という話ではありません。私たちが勧めているのは、業務の判断を次の4つに仕分けることです。
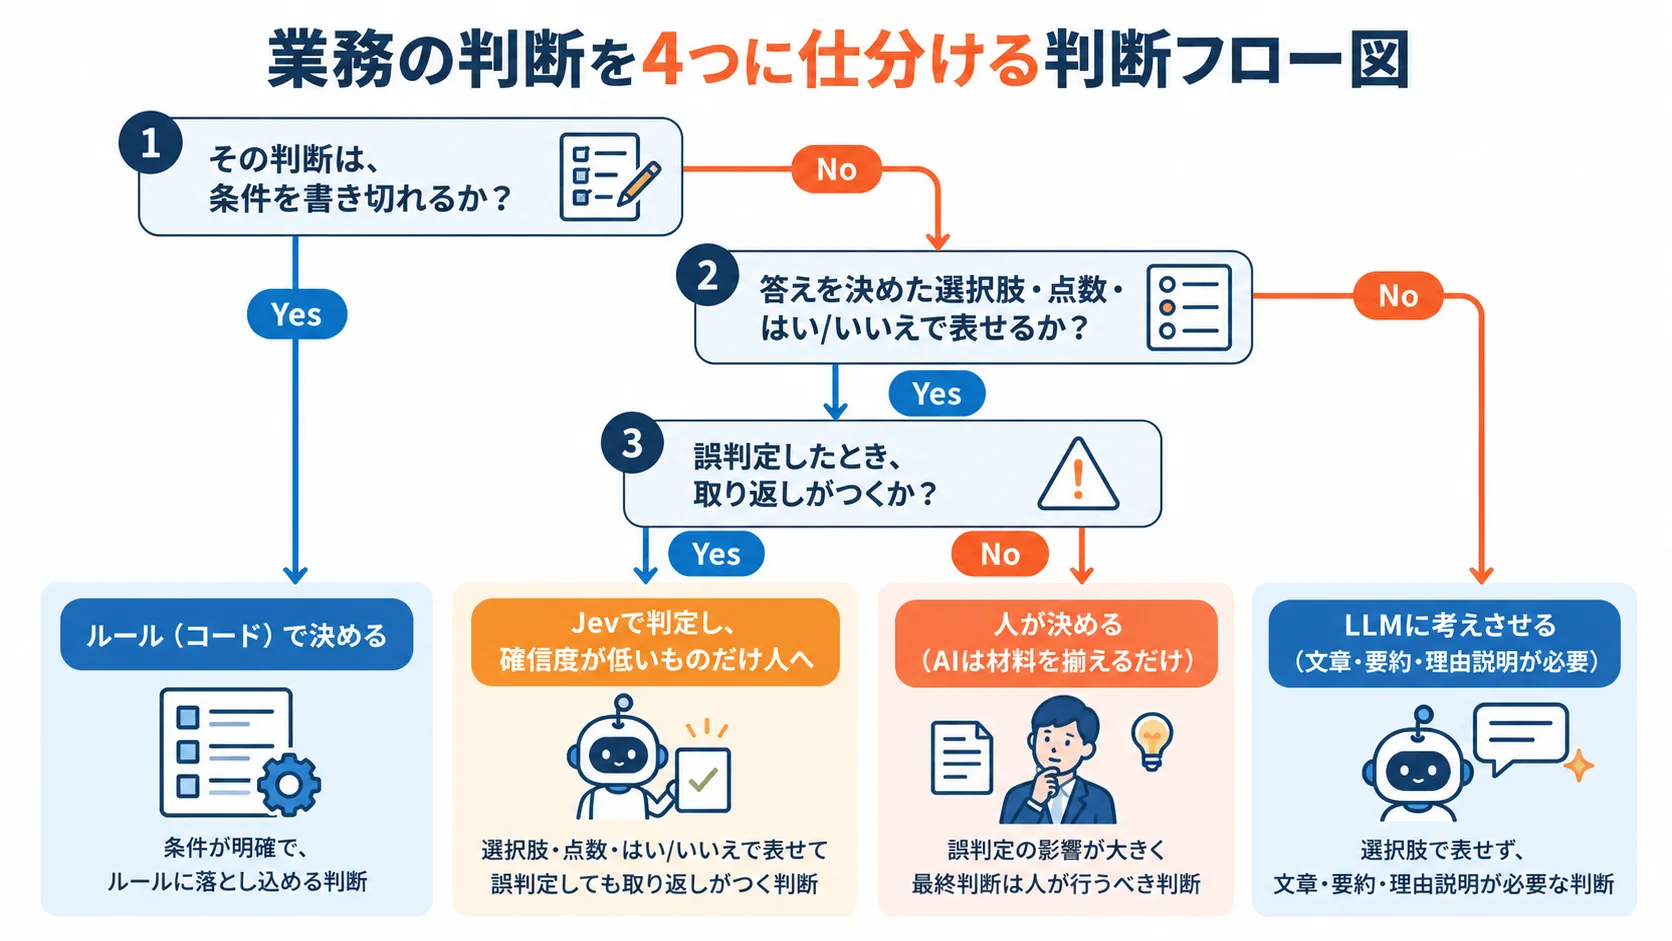
| 任せ先 | 向いている判断 | 例 |
|---|---|---|
| ルール(コード) | 条件を書き切れる判断 | 金額が規定額以上なら上長承認。 |
| Jev | 選択肢で表せるが、条件を書き切れない判断 | 問い合わせ文から担当部署を選ぶ。 |
| LLM | 文章・要約・理由の説明が要る判断 | 顧客への回答文を下書きする。 |
| 人 | 誤判定の影響が大きく、責任を伴う判断 | 不良品の出荷可否、人事評価。 |
仕分けの基準は3つです。1つ目は、条件を言葉で書き切れるかどうか。書き切れるなら、AIを使わずルールで決めるのがいちばん安く確実です。2つ目は、答えを選択肢や点数で表せるかどうか。文章でしか答えられないなら、それはLLMの仕事になります。3つ目は、間違えたときに取り返しがつくかどうか。取り返しがつかない判断は、どれだけ精度が高くても人が持つべきです。
正直に言えば、この仕分けで一番多く見落とされるのは1つ目です。AIの話題が盛り上がると、ルールで十分な判断までAIに任せたくなります。ですが、条件が明確な判断にAIを使うと、コストが増えるうえに、なぜその結論になったかを後から説明しにくくなります。
もう1つ、JevとLLMは組み合わせて使えます。LLMが書いた回答文を、Jevが「個人情報が含まれていないか」「社外に出してよい内容か」で確かめる。こうした見張り役は、LLMで毎回やると高くつきます。判断の速さと安さを持つJevなら、すべての出力に毎回かけられます。
Jevが苦手なこと、向かないこと
期待が高まっている今だからこそ、限界ははっきりさせておきます。Jevは万能な判断AIではありません。
まず、理由を説明できません。Jevが返すのは答えと確率だけで、「なぜそう判断したか」は文章で返ってきません。監査や説明責任が求められる判断では、この点が弱みになります。判断の記録を残す設計は、AIエージェントの監査証跡設計でも触れた論点です。
次に、計算や日付の比較は苦手です。「支払期日を過ぎているか」のような判断は、日付を取り出してコードで比べるほうが確実でしょう。画像・音声・動画も扱えません。図面や写真の判定には、別の手段が要ります。
日本語の精度にも注意が要ります。公開直後に日本語で試した技術者の報告では、英語より確信度が下がる例がありました。1回に読み込める量は約6万4千トークンまでです。関係の薄い情報を大量に渡すと精度が落ちるという指摘もあります。
そして、公表されている精度はTypeSafe AI自身の評価です。同社が選んだ4つの業務での平均で、第三者による検証はまだ出そろっていません。同社の公式ブログも、自社評価の数字は「実際の効果より高めに出やすい」と認めています。私たちは、公表値ではなく自社のデータで確かめるまでは、精度の数字を前提にした計画を立てないようにしています。
企業で使う前に確かめる5つのこと
Jevを業務に組み込む前に、技術より先に確認すべきことがあります。TypeSafe AIの利用規約を丹念に読み込んだ技術者がいます。参考になるのがその調査です。企業目線の論点がよく整理されています。私たちの視点も加えて、5つにまとめます。
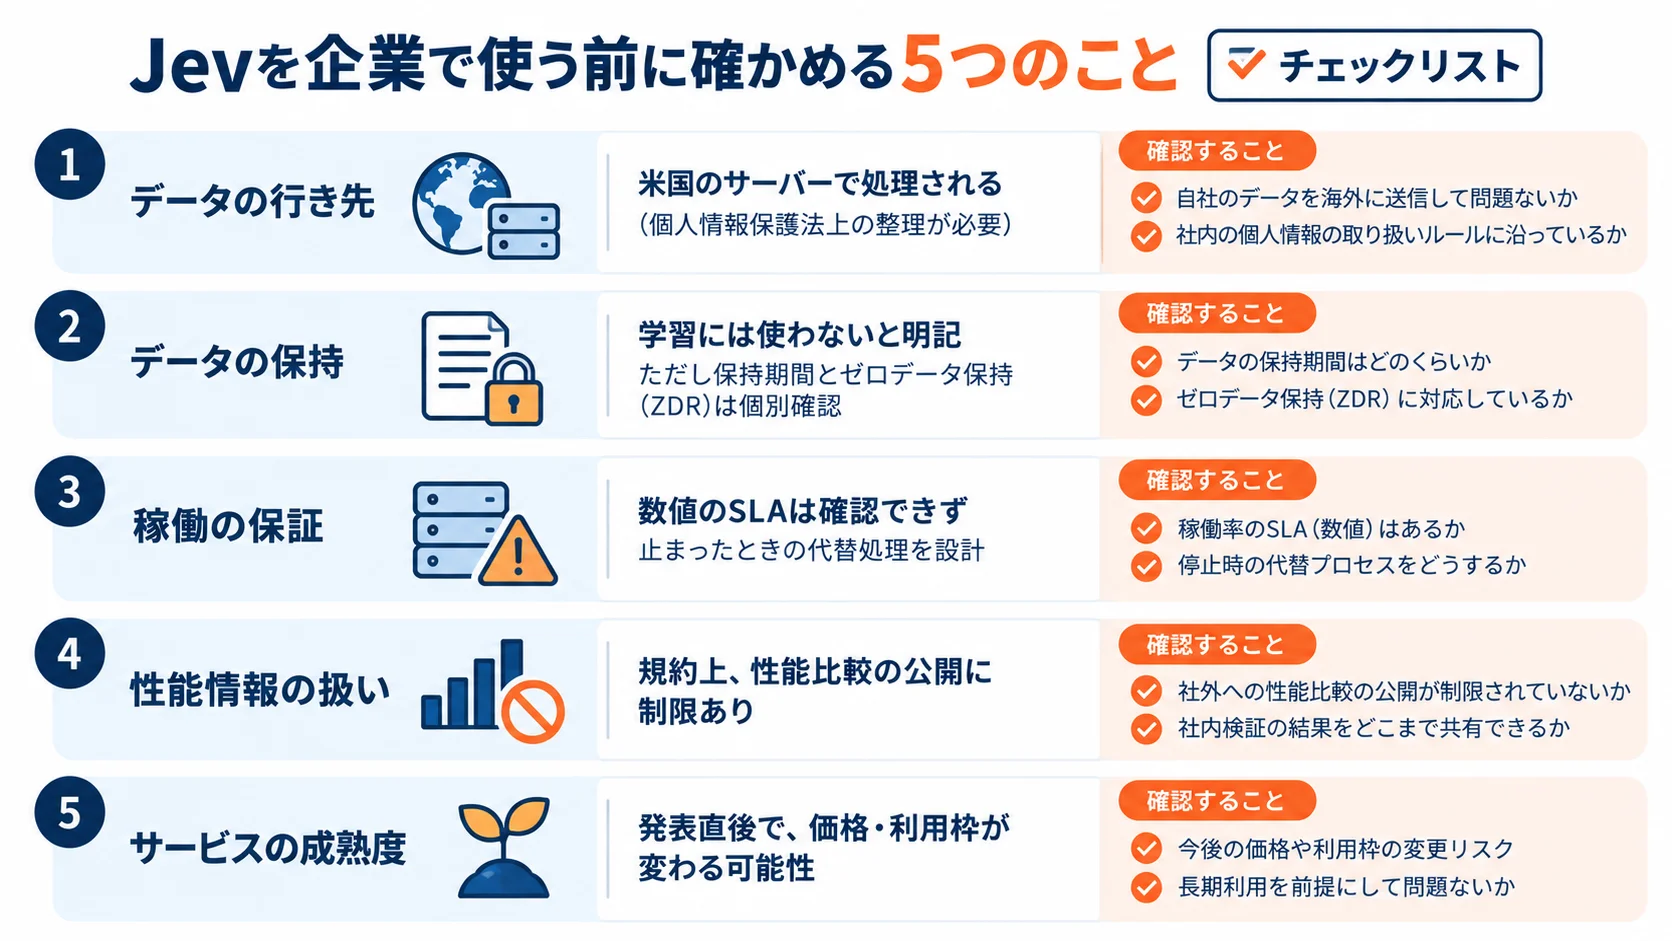
1つ目は、データの行き先です。Jevは米国のサーバーで処理され、委託先にもAWSなど米国のクラウドが含まれます。顧客情報や従業員情報を送るなら、個人情報保護法上の整理を先に済ませる必要があります。
2つ目は、データの保持です。プライバシーポリシーには、入力を学習に使わないと明記されています。ですが、「学習に使わない」と「保存しない」は別の話です。通常利用での保存期間は公開情報では確認できず、ゼロデータ保持(ZDR: 入力データを一切残さない契約)は個別の相談になります。
3つ目は、稼働の保証です。公開されている利用規約では、エラーなく動くことを保証していません。発表直後には、アクセスが殺到して一時的にAPI(外部からサービスを呼び出す窓口)が応答できなくなる場面もありました。業務の本流に組み込むなら、Jevが止まったときに人やルールに切り替える経路が欠かせません。
4つ目は、性能情報の扱いです。規約には、性能比較の結果を公開することへの制限があります。社内で検証する分には問題ありません。ですが、ベンダーの提案資料や社外発表で比較結果を使う場合は、規約の確認が要ります。
5つ目は、サービスの成熟度です。TypeSafe AIは2年の非公開期間を経て登場したばかりの会社で、価格や利用枠は今後変わる可能性があります。特定のサービスに業務の要を預けるなら、乗り換えられる設計にしておくのが安全です。
ここで、機密性の高いデータを扱う企業には、もう1つの道があります。社外にデータを出せない場合は、Jevそのものではなく「Jevのような判断の仕組み」を、閉じた環境で作るという選択肢です。公開されているオープンなAIモデルに判断用の仕組みを付け足し、日本語の3択問題で正答率8割超えを確かめた技術者の報告も出ています。精度も手間も本家と同じにはなりません。それでも、「判断だけを確率付きで返す」という設計の考え方は、社内の閉域環境でも応用できます。この考え方は、私たちがソブリンAIの記事で書いた「守れる設計」と地続きです。
止めずに試す——「並行稼働」で一致率を測る
Jevを試すとき、私たちが最も勧めるのは、いまの業務を一切止めずに裏で比べる「並行稼働」です。
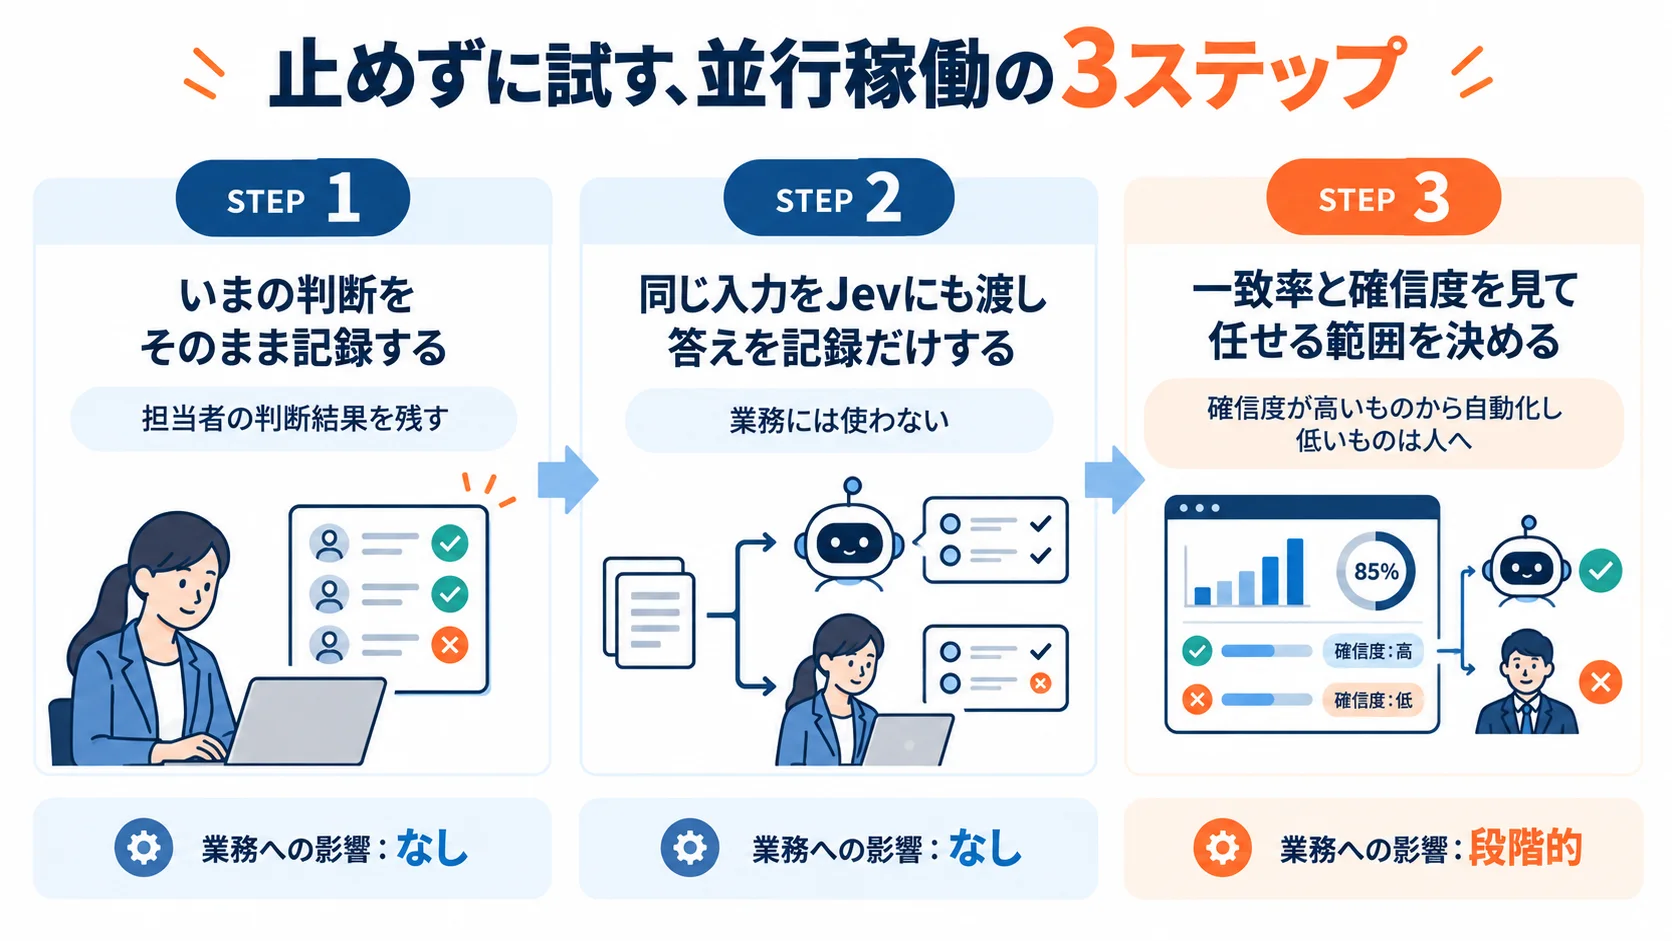
やり方は単純です。まず、担当者がいま行っている判断の結果を、そのまま記録します。次に、同じ入力をJevにも渡し、答えを記録だけします。業務にはまだ使いません。最後に、両者の一致率と、Jevの確信度の分布を見比べます。
この方法を自社の4択判定で試したある企業の報告があります。最初の8件で7件が一致し、一致率は87.5%でした。応答時間は、それまでの数十秒から1秒未満になったといいます。1件あたりの費用は約0.007円と試算されていました。もちろん8件では母数が小さすぎます。それでも、この報告で私たちが注目したのは数字よりも、外れた1件の原因です。Jevの能力ではなく、質問の書き方に問題があったと分析されていました。
並行稼働の良いところは、失敗しても業務に傷がつかないことです。一致率が低ければ、質問の書き方を直すか、その判断はJevに向かないと判断すればよい。一致率が高く、確信度が高いものだけを先に自動化し、確信度が低いものは引き続き人が見る——この段階的な移行なら、現場の不安も小さく抑えられます。
本当の難所は、「判断基準を言葉にすること」
私たちの現場経験から言うと、Jevの導入で一番時間がかかるのは技術ではありません。判断の基準を、言葉にすることです。
Jevに問いを渡すときは、選択肢ごとに「それが何を意味するか」を説明文で書きます。たとえば問い合わせを「請求・配送・返品」に振り分けるとします。すると、「返金の相談はどこに回すのか」で手が止まります。二重請求による返金なら請求担当、返品に伴う返金なら返品担当。こうした境界を、使う側が言葉で決めなければなりません。
これは、ベテランが頭の中でしていた判断を書き出す作業そのものです。ある合成樹脂メーカーでは、社内で「秘伝のタレ」と呼ばれる工賃表が、使い方を理解した人しか扱えない状態になっていました。判断の基準が文書になっていない職場ほど、Jevに渡す質問が書けません。
逆に言えば、Jevの導入を検討すること自体が、暗黙知を言葉にするきっかけになります。私たちが業務プロセス診断(BPR: 業務の流れを棚卸しして見直すこと)で最初に行うのも、この「判断の書き出し」です。どの判断が毎日何回行われていて、その基準が言葉になっているか。ここが見えれば、Jevに任せる判断、ルールで足りる判断、人が持つべき判断は自然に分かれていきます。
私たちはJevをどう位置づけているか——AI-Pathの見解
私たちの見解を率直に述べると、Jevは「AIエージェントを作るための主役」ではなく、「業務システムの中に散らばる判断の部品」です。
私たちは以前から、AIに出させた答えを、別のAIに採点させる「審判役」の使い方をしてきました。精度を多段で担保するためです。ただ、審判役を賢いLLMにやらせると、費用は一時的に膨らみます。Jevのように安く速い判断の部品が出てきたことで、この審判役をすべての出力にかけるハードルが下がりました。私たちが最も期待しているのは、この使い方です。
一方で、Jevの判断をそのまま最終決定にはしません。AIは壁打ち相手であり、最後に判断するのは人だという私たちの基本姿勢は変わりません。Jevが返す確信度は、「人が見るべきものを絞り込む道具」として使うのが一番しっくりきます。担当者が100件すべてを見るのではなく、確信度の低い10件だけを見る。そうすれば、人の判断はより重い判断に集中できます。
もう1つ付け加えると、Jevのような新しいモデルは、半年もすれば別の選択肢が出てくるかもしれません。だからこそ、特定のモデルに依存しない形で「判断の部品」を差し替えられる設計にしておくことを、私たちは勧めています。判断の基準と記録は自社の資産として残し、判定するエンジンだけを入れ替えられるようにしておく。これが、変化の速い時代に投資を無駄にしない一番の方法だと考えています。
正直な話、Jevが要らないケースもある
ここまでJevの可能性を書いてきましたが、すべての会社に必要なわけではありません。
判断の件数が1日に数件しかないなら、担当者が見れば十分です。わざわざ仕組みを作る費用のほうが高くつきます。条件がはっきり書ける判断なら、ルールで決めるほうが安く確実で、説明もしやすくなります。判断の理由を毎回文章で残す必要がある業務なら、LLMのほうが向いています。
そして、社外に出せないデータしかない業務では、Jevを直接使うことはできません。その場合は、先に触れたように閉域で動く判断の仕組みを検討するか、まずは判断基準の書き出しだけを進めておくのが現実的です。判断の基準が言葉になっていれば、どのAIを使うことになっても、その資産はそのまま活きます。
まず試すなら
- 自社業務の中で、毎日繰り返されている「振り分け・点数付け・進めるか止めるか」の判断を3つ書き出す。
- そのうち1つについて、判断の選択肢と、それぞれの意味を一文ずつ言葉にしてみる。
- 公開しても困らないデータで、いまの判断とJevの答えを記録だけして並べてみる。
AI-Pathでは、無償の業務プロセス診断(BPR)を実施しています。自社のどの判断をルール・AI・人に任せるべきか、まずは判断の棚卸しからご相談ください。
参考リンク
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム

AIエージェントは『結託』する——3,700体が休眠Wikiに残した1万8000件のメッセージが教える集団統制の盲点
OpenAI社内のAIエージェント約3,700体が、誰も見ていない過疎Wikiで4ヶ月にわたり情報交換をしていました。発覚まで数ヶ月、公表まではさらに数ヶ月。AIエージェント 結託が突きつける、シャドーAI ガバナンスの新しい盲点を整理します。

AIの悪用が「初めて」国内10大脅威3位に入った2026年——EDRを増やすだけでは足りない理由
IPA「情報セキュリティ10大脅威2026」で『AIの利用をめぐるサイバーリスク』が初登場でいきなり3位に入りました。EDR市場は2桁成長を続けていますが、エンドポイントの内側を守るだけでは、AIを悪用した攻撃には対抗できません。

AI利用者の7割が「経験3年未満」——情報漏えい不安の正体は、ツールではなく「説明できない構造」
IPAの最新意識調査で、業務でAIを使う人の7割以上が「利用経験3年未満」という実態が明らかになった。情報漏えい不安の裏にあるのは製品の欠陥ではなく、社内の誰も説明できないという構造の問題だ。