大規模定量モデル(LQM)とは——需要予測や原価をLLMに任せて外した会社が、次に見るべき「数字のAI」
「需要予測、AIでできませんか」。製造業の計画担当の方からこう聞かれる回数が、この半年で目に見えて増えました。ただ、よく伺うと生成AIに実績を貼り付けて数字を出させ、会議で「その数字はどう出したんですか」と問われて止まっている。原因は性能ではなく、言葉のために作られたモデルへ数量の計算を渡していたことにあります。ガートナーは2026年11月4日、2027年のトレンドに「大規模定量モデル(LQM)」を挙げました。数量を扱うために設計された、言語モデルではないAIです。ここではLQMとLLMの線引きと、どこから手を付けるかを、計画系のシステムを作ってきた現場経験からお伝えします。
大規模定量モデル(LQM)のよくある質問【5問5答】
数字の自動化のご相談をお受けすると、いただく質問はだいたい5つに集まります。まず1問1答でお答えし、そのうえで詳しくご案内します。
Q1. 大規模定量モデル(LQM)とは何ですか
LQMとは、定量データ、つまり数値の処理と分析のために設計されたAIです。ガートナージャパンの2026年11月4日の発表によると、LQMは「定量データの処理や分析向けに設計されたモジュール型のハイブリッド・ニューラル・ネットワーク・アーキテクチャ」と説明されています。ニューラルネットワーク単体ではなく、統計手法や数理の解法、シミュレーションの道具を組み合わせた構成を指します。文章を書くことは目的に入っていません。狙いは、意思決定を「起きてから直す」側から「起きる前に試算する」側へ寄せることです。
Q2. LLM(大規模言語モデル)と何が違うのですか
LQMとLLMの違いは、扱う対象と、正解の作り方にあります。LLMは次に来る言葉を当てるように訓練されていて、数値の桁や単位、制約条件を守る仕組みを内側に持っていません。LQMは物理・化学・数学の法則や統計の構造を土台に置き、同じ入力なら同じ答えを返すことを前提に組まれます。ガートナーは、汎用の言語モデルで数値計算を行うと精度とコンプライアンスの両面で重大なリスクが生じると明示しました。私たちの感覚でも、ここは性能差ではなく設計思想の差です。
Q3. 自社の需要予測をLQMに置き換えるべきですか
いいえ、需要予測のAIを入れ替えるより先に、LLMで数字を出している部分だけを外してください。需要予測のような「過去の揺れから先を当てる」領域は、統計モデルや時系列の基盤モデルで足りる場合が多くあります。LQMが効くのは材料の配合や設備の劣化のように、物理や化学の挙動を試算したいところです。順番を間違えて大きな道具から入ると、検証に半年を使って何も残りません。まず自社の数字の業務を4種類に仕分けてください。
Q4. 生成AIに数字を任せると、具体的に何が起きますか
よくあるのは3つです。桁や単位がずれる。集計の条件を勝手に変える。そしていちばん厄介なのが、間違っていても自信のある文章で返ってくることです。文章は読めるので、会議では気づかれません。気づかれるのは、その数字で発注した後になります。私たちは出力の確からしさを検証する工程を挟まない限り、数値を人の判断材料に載せない方針を取っています。
Q5. いくらかかりますか。どこから手を付ければよいですか
費用の話より前に、対象の選び方で桁が変わります。全社の計画基盤から入ると数年がかりになりますが、1つの製品群・1つの拠点に絞れば、動くものを見ながら判断できる規模に収まります。私たちは1日でプロトタイプを作って数字の出方をお見せする進め方をとっています。自社のどの数字から手を付けるべきかは、業務の棚卸しから見えてきます。最新の進め方と費用感は、無償の業務プロセス診断(BPR)でご確認ください。
「その数字、どうやって出したんですか」で会議が止まった
先日、ある中堅の製造業で計画業務のお話を伺っていたときのことです。担当の方が、生成AIに過去2年の出荷実績を貼り付けて翌月の数字を出させていました。画面はきれいで、説明文まで付いています。ところが上司から「その数字、どうやって出したんですか」と聞かれ、答えられずに会議が止まったそうです。精度の問題ですらありません。根拠を遡れないものは、組織の中では使えないという話でした。
これは珍しい例ではありません。あるシャッター・建材メーカーの工場長は、原価管理について「非常に大変」「今の仕組みだと難しい」「現実的に原価を追いきれない」と率直に話されていました。別の合成樹脂・産業資材メーカーで業務を統括する課長は、原価表の中身が7割ほどブラックボックス化していると明かされました。「Excelで配信されるので各担当がそれぞれカスタマイズしてしまう」「二重で計上していた箇所もあった」。つまり、数字の出どころが人の手元に散っている状態です。追いきれていない数字の上に生成AIを乗せても、出てくるのは速くなった不確かさだけです。
もう1つ、忘れられない声があります。ある重工・製鋼メーカーのシステムグループマネージャーは、開発にAIを入れて問い合わせ件数を3割減らしたと社内のQC発表で報告したものの「全然評価が悪くて、あまり響かなかった」と吐露されていました。数字を出しても信じてもらえない。この壁は、AIの精度を上げるだけでは越えられません。越えるには、その数字がどの道具でどう算出されたのかを言える状態が要ります。
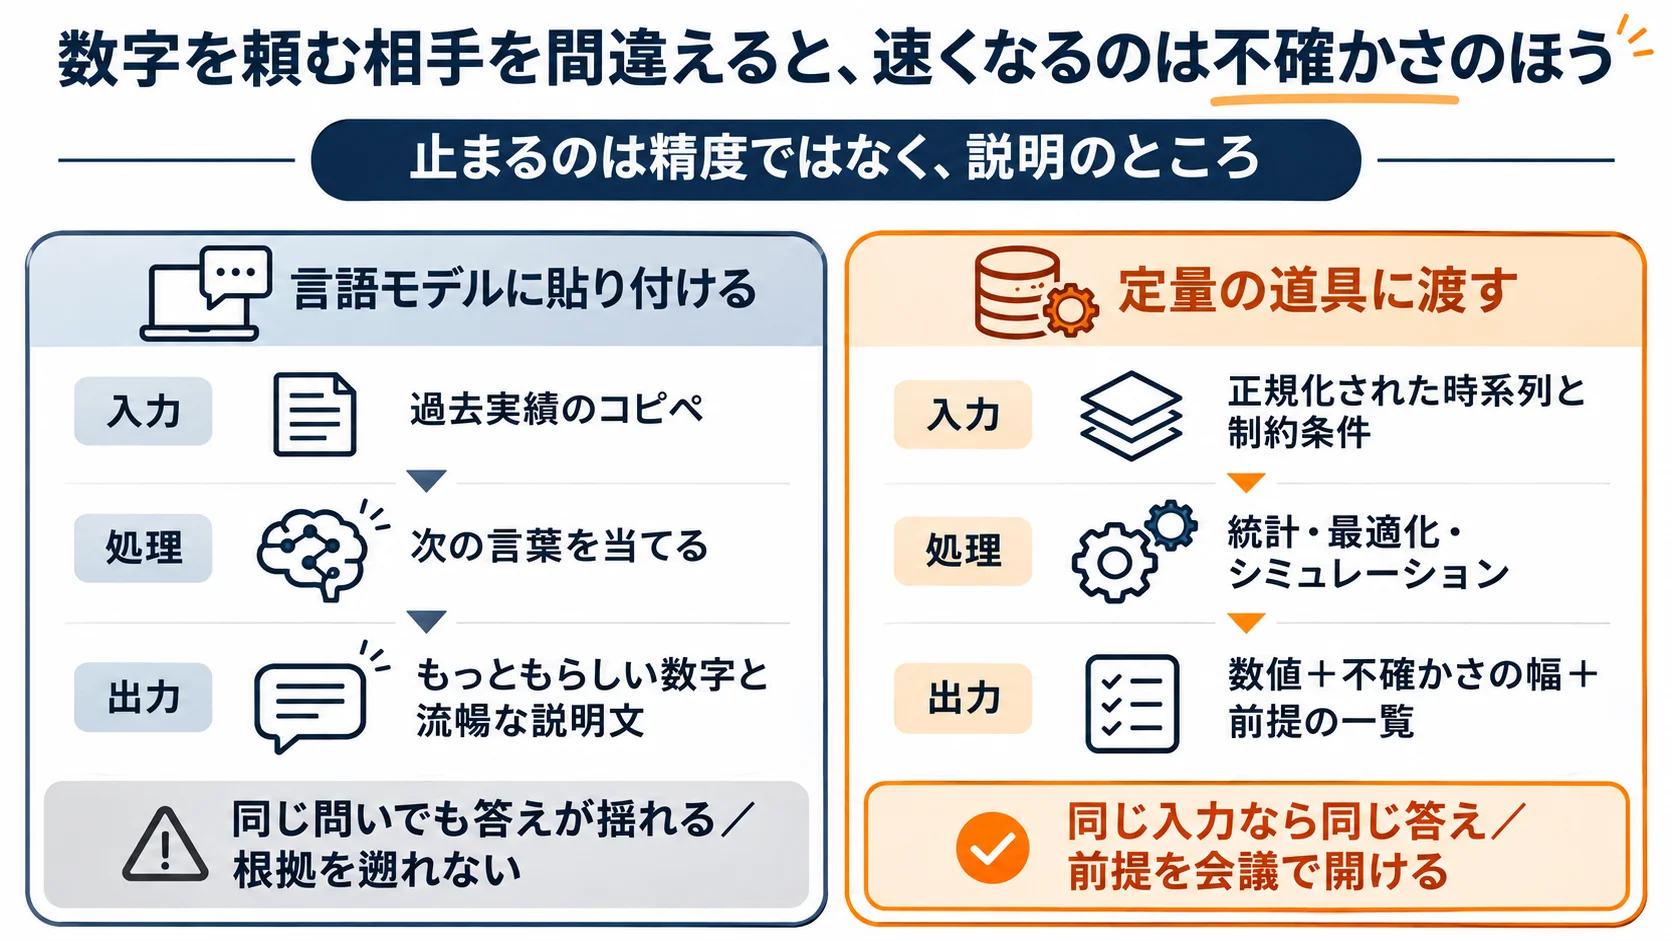
これは、止まるのが精度ではなく説明のところだということを示した図です。
大規模定量モデル(LQM)とは——言語ではなく、数量のために組まれたAI
LQMという呼び名が急に広まったのは、ガートナーの2027年トレンドに入ったからです。2026年11月4日のプレスリリースでは、戦略的テクノロジのトップ・トレンドとして10項目が並びました。前半は大規模定量モデル(LQM)、音声推論モデル、ワールド・モデル、AIコンテキスト・プラットフォーム、エージェント・コーディング・ハーネス。後半はAIエージェントのアイデンティティ、自律型エクスポージャ修復(AER)、ソブリン・テック、使い捨てアプリケーション、サービスとしてのウェットウェア(WaaS)です。この並びに数量の話が入ってきたこと自体が、2026年の空気を表しています。
発表の説明で目を引いたのは、LQMの効用が「速くなる」ではなく「意思決定の在り方が変わる」と書かれていた点でした。事後対応型のトラブルシューティングから、先を見越したシミュレーションへ。つまり、壊れてから直すのではなく、壊れる前に試算する側へ寄せる道具だという位置づけです。応用例として挙がっているのは金融リスク評価、サプライチェーン計画、エネルギー予測です。海外報道では、ガートナーのジーン・アルバレス氏が、この厳密さによって金融やヘルスケアのような規制の厳しい業界でも自律的な予測を安全に展開できると述べています。
商用の実装も、すでに動いています。LQMという言葉を早くから使ってきたSandboxAQは、自社のモデルを「物理・化学・生物・数学で訓練し、現実の系をシミュレーションする」ものだと説明しています。製品ページでは、創薬や材料探索で最大4倍の加速をうたっています。NVIDIAとの協業に加え、2026年6月にはGoogle Cloudのマーケットプレイスでの提供も発表されました。言葉のモデルとは別の系譜で、別の商流ができ始めているわけです。
誤解のないように申し上げると、LQMは製造業の需要予測をすぐ置き換える道具ではありません。現時点の商用ユースケースは創薬・材料・エネルギーのように、物理現象が主役の領域に寄っています。中堅企業の計画業務にとって意味があるのは、製品そのものより「数量はLLMの外側で扱う」という線引きの思想です。ここを先に入れておくと、道具が揃ったときに慌てずに済みます。
「LLMは数字に向かない」は印象論ではない——2つの実測
この線引きを、私たちは体感だけで言っているわけではありません。根拠になる実測が2つあります。
1つ目は、時系列予測の分野で有名になった消去実験です。論文のタイトルは「Are Language Models Actually Useful for Time Series Forecasting?」。Tanらによる研究で、NeurIPS 2024のSpotlightに採択されています。当時流行していたLLMベースの時系列予測手法から、LLMの部分を取り除く、あるいは単純なアテンション層に置き換えるという乱暴な実験でした。結果は、予測精度が落ちないどころか、むしろ良くなる場合が多かったというものでした。著者らは、事前学習済みのLLMはゼロから訓練したモデルより優れていないと書いています。時系列の逐次的な依存関係を表現せず、少数データの設定でも助けにならない。残るのは計算コストだけ、という結論でした。
これは私たちの実感とも一致します。需要予測の案件で生成AIの出番を探すと、たいてい出番は「予測そのもの」ではありません。その前後にある整形や説明の文章づくりに落ち着きます。
2つ目は、集計の正確さです。自然言語からSQL(データベースへの問い合わせ文)を書かせる課題では、BIRDベンチマークが広く使われています。これは37以上のドメイン・95個の実データベースに対する12,751問以上で、生成した問い合わせを実際に実行し、答えが合うかを測るものです。公式のリーダーボードによると、テストセットの実行精度の最上位は83.40%。同じ課題に人間(データエンジニアとデータベース専攻の学生)が取り組んだ場合は92.96%です。差は約9.6ポイント残っています。
この数字の読み方には注意が要ります。実行精度83.40%は、研究の文脈では立派な成績です。ただ、月次の在庫金額や原価の集計で6回に1回ずれるなら、業務にはそのまま載せられません。しかも外れ方が静かです。文章の誤りは読めば気づきますが、集計の誤りは数字の見た目を変えません。私たちが「数値を扱う経路には検証を挟む」と申し上げるのは、この静けさが怖いからです。
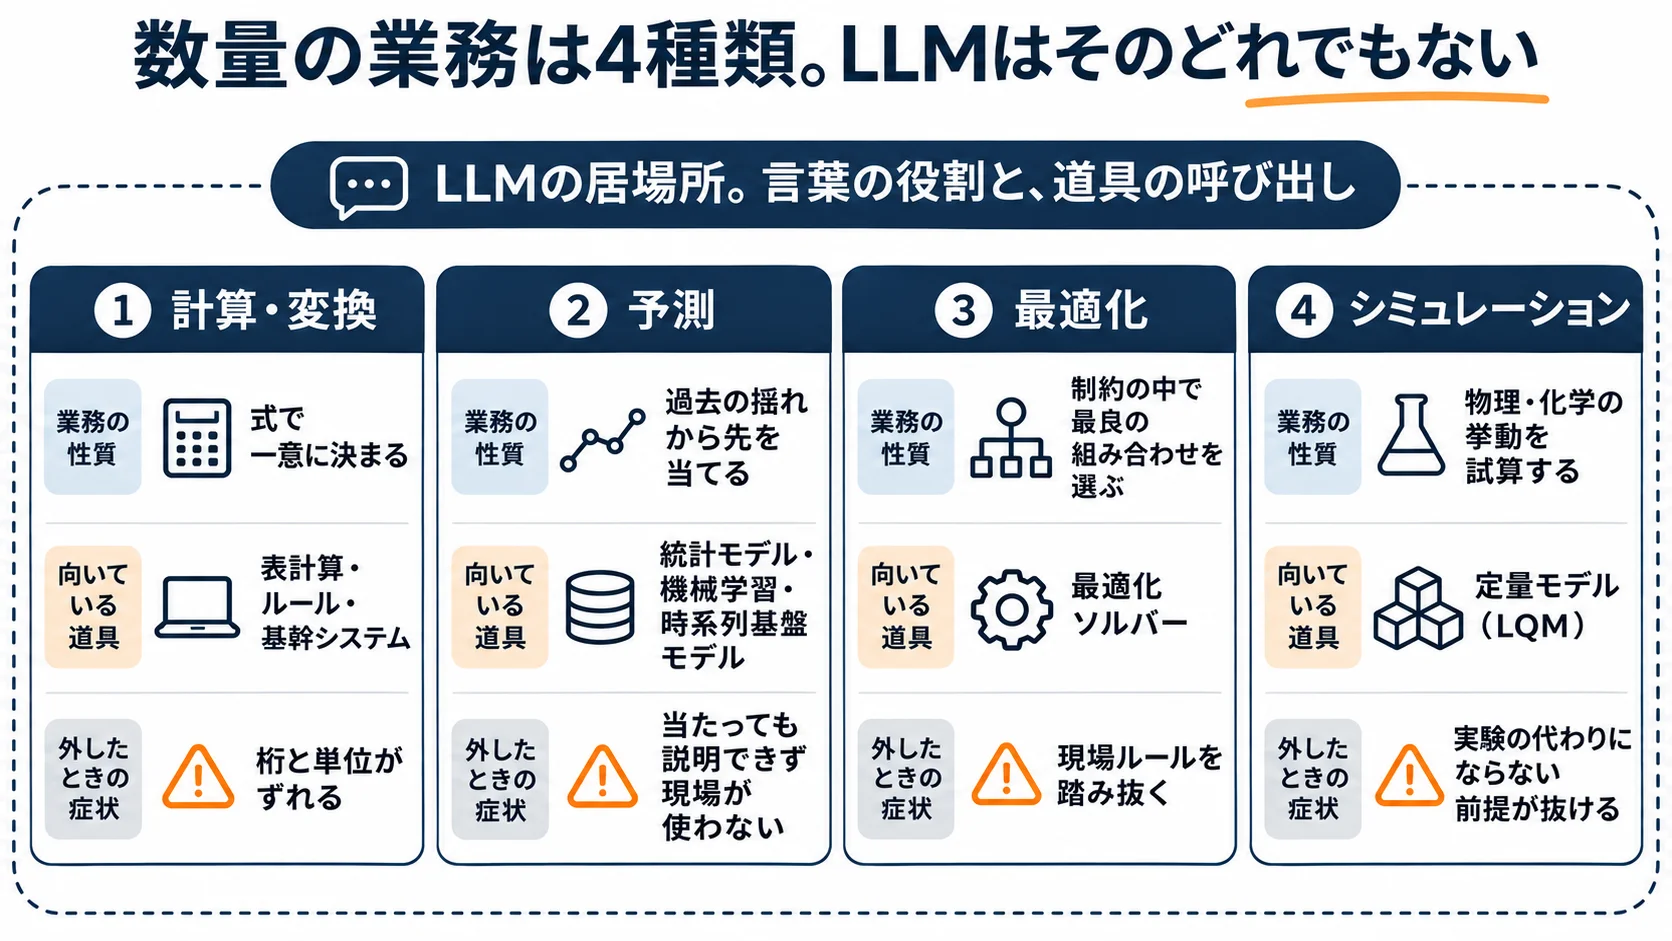
これは、LLMの居場所が4種類の外側にあることを示した図です。
数字の業務を4つに分ける——LLMの居場所は、その外側にある
ご相談の最初に、私たちはまずこの仕分けをします。「AIで数字を」とひと括りにされている作業を4種類に分けるだけで、使う道具と検収の方法が決まるからです。
| 業務の性質 | 向いている道具 | 業務の例 | 道具を外したときの症状 |
|---|---|---|---|
| 決まった式で答えが一意に決まる。 | 表計算・ルール・基幹システム。 | 原価計算、歩留まり、請求、課金。 | 桁や単位がずれる。二重計上に気づけない。 |
| 過去の揺れから先を当てる。 | 統計モデル、機械学習、時系列の基盤モデル。 | 需要予測、来客数、電力使用量。 | 当たっても説明できず、現場が使わない。 |
| 制約の中で最良の組み合わせを選ぶ。 | 最適化ソルバー。 | 生産計画、配車、人員シフト。 | 現場の暗黙ルールを踏み抜いて信用を失う。 |
| 物理・化学の挙動を試算する。 | 定量モデル(LQM)、シミュレーション。 | 材料の配合、設備の劣化、リスク評価。 | 実験の代わりにならない前提が抜ける。 |
| (参考)言葉を扱う。 | LLM。 | 要約、下書き、問い合わせ応答、道具の呼び出し。 | 数字を任せると、静かに外す。 |
この表で大事なのは最後の行です。LLMは4種類のどれでもなく、その外側で言葉と道具をつなぐ役を担います。逆に言えば、1行目から4行目の計算をLLMに直接やらせている箱があれば、そこが危ない場所です。
あるプラスチック成形機メーカーの推進課マネージャーは、AIの回答を100問ぶん評価した結果を率直に話されました。「間違った回答もいくつかあった」「その回答で問題が解決するか微妙で、それを見て結局取説を見に行っちゃうシーンが目に浮かんだ」。これは言葉の領域の話ですが、構図は数量でも同じです。1回でも外せば、現場は元の道具に戻ります。
LLMに計算させるのをやめ、計算器を呼ばせる
では、生成AIは数字の業務で使えないのか。そうではありません。使い方の向きを変えます。計算させるのではなく、計算器を呼ばせるのです。
AI側から外部の道具やデータに接続する約束事として、MCP(Model Context Protocol: AIに社内の道具やデータへの接続口を与える共通規格)が普及しました。LQMの文脈でも、2026年5月にSandboxAQが自社の定量モデルをMCP経由でClaudeに接続したと報じられています。言語モデルが定量モデルを道具として呼ぶ構図が、製品レベルで出てきたわけです。
私たちはこの作法を、顧客の業務システムでも同じ形で採ります。見積や原価の計算はAPI(システム間で機能を呼び出す接続口)にして、言語モデルからは呼ぶだけにする。予測は統計側で出し、言語モデルは「なぜその数字になったか」の説明文を書く。こうすると、数量の責任は計算器側に、言葉の責任は言語モデル側に、きれいに分かれます。ある合成樹脂・産業資材メーカーでは、見積計算をAPI化して受注・見積業務を自動化する形で進めました。基幹のSAPを正としつつ、「秘伝のタレ」と呼ばれていた属人的な工賃表をマスター化していく作業が本体です。
この設計は、精度の担保にもつながります。私たちは社内で、あるモデルが出した回答を別のより賢いモデルで採点させる運用を回しています。コストは一時的に増えますが、より正しい答えを出すモードを足せます。数量でも同じで、予測値の隣に「別の手法で出した値」を並べると、ずれたときに先に気づけます。この接続の作法そのものはMCPとは何かで詳しく書きました。
今日から触れる「定量側」の現実解
LQMという製品が自社の手元に来るのを待つ必要はありません。数量の計算を定量側へ戻す道具は、すでに手に入ります。
時系列の基盤モデルがその一例です。GoogleのTimesFM、AmazonのChronos-2のように、過去データを渡すだけで分位点付きの予測が返るモデルが出てきました。系列ごとにモデルを選んだり特徴量を作り込んだりする手間が減るので、試す敷居ははっきり下がりました。
ただ、ここで期待値を調整しておきたいところがあります。合成した需要データ20系列で古典手法と同条件で比較した検証の報告によると、季節ナイーブを1.00とした誤差指標で、ETSやSARIMAは0.7〜0.9でした。勾配ブースティングの分位点モデルと基盤モデルは、いずれも0.6〜0.8という傾向です。合成データでの傾向値なので幅で読む必要はありますが、点予測の精度では機械学習と基盤モデルが拮抗し、データ次第で順位が入れ替わるという結論です。差が明確に出たのは確率予測の質と運用コストのほうでした。
つまり、基盤モデルに替えたから当たるようになる、という話ではありません。効いてくるのは「毎月のモデル保守が軽くなる」「予測の幅を出せるので在庫判断に使える」という運用側です。私たちが計画系の案件で先に作るのは、たいていこの運用の受け皿です。
説明できない予測は、現場で押されないボタンになる
精度の議論よりも、定着を分けるのはこちらです。
ある医薬・食品メーカーの需要予測担当の方は、発注画面への要望をこう話されました。「推奨発注だと、どう発注すべきか考える思考が発生してしまう。作業者はとりあえず考えずに、発注データが来たらボタンを押すだけにしたい。考えたり悩んだりするのは管理者側」。これは、精度の高い予測を出すだけでは足りず、現場が迷わない形まで持っていく必要があるという指摘です。
一方で、別の中堅製薬・健康食品メーカーの需要予測担当の方は「製販会議自体に課題があり、将来的には会議をなくしたい」とも話されています。発注判断については「1年分積めるような製品もあるため、毎回会議で発注を決めるのではなくシステムで自動化したい。多少の廃棄が出ても金額的な影響は小さいので許容範囲だ」。会議をなくすには、会議で聞かれる問いにシステムが先に答えておく必要があります。
だから私たちは、需要予測を「統計的にどの値がいちばん確からしいかを検証する工程」として設計し、説明できることにこだわります。予測値だけでなく、どの期間のデータを使ったか、どの要因が効いたか、幅はどれくらいか。これを画面に出しておくと、「その数字、どう出したんですか」に現場が自分で答えられます。公開している事例でも、不動産の賃料査定で国や自治体の公開データ9ソースだけを使い、相場や適正賃料を「説明できる」形に可視化したものがあります。物件サイトの数字に依存しない構成にしたのは、根拠を社内で遡れるようにするためでした。
ここは意見が分かれるところですが、私たちは説明の様式を精度目標と同じ重さで要件に入れます。説明のないボタンは、押されないまま画面の隅に残るからです。
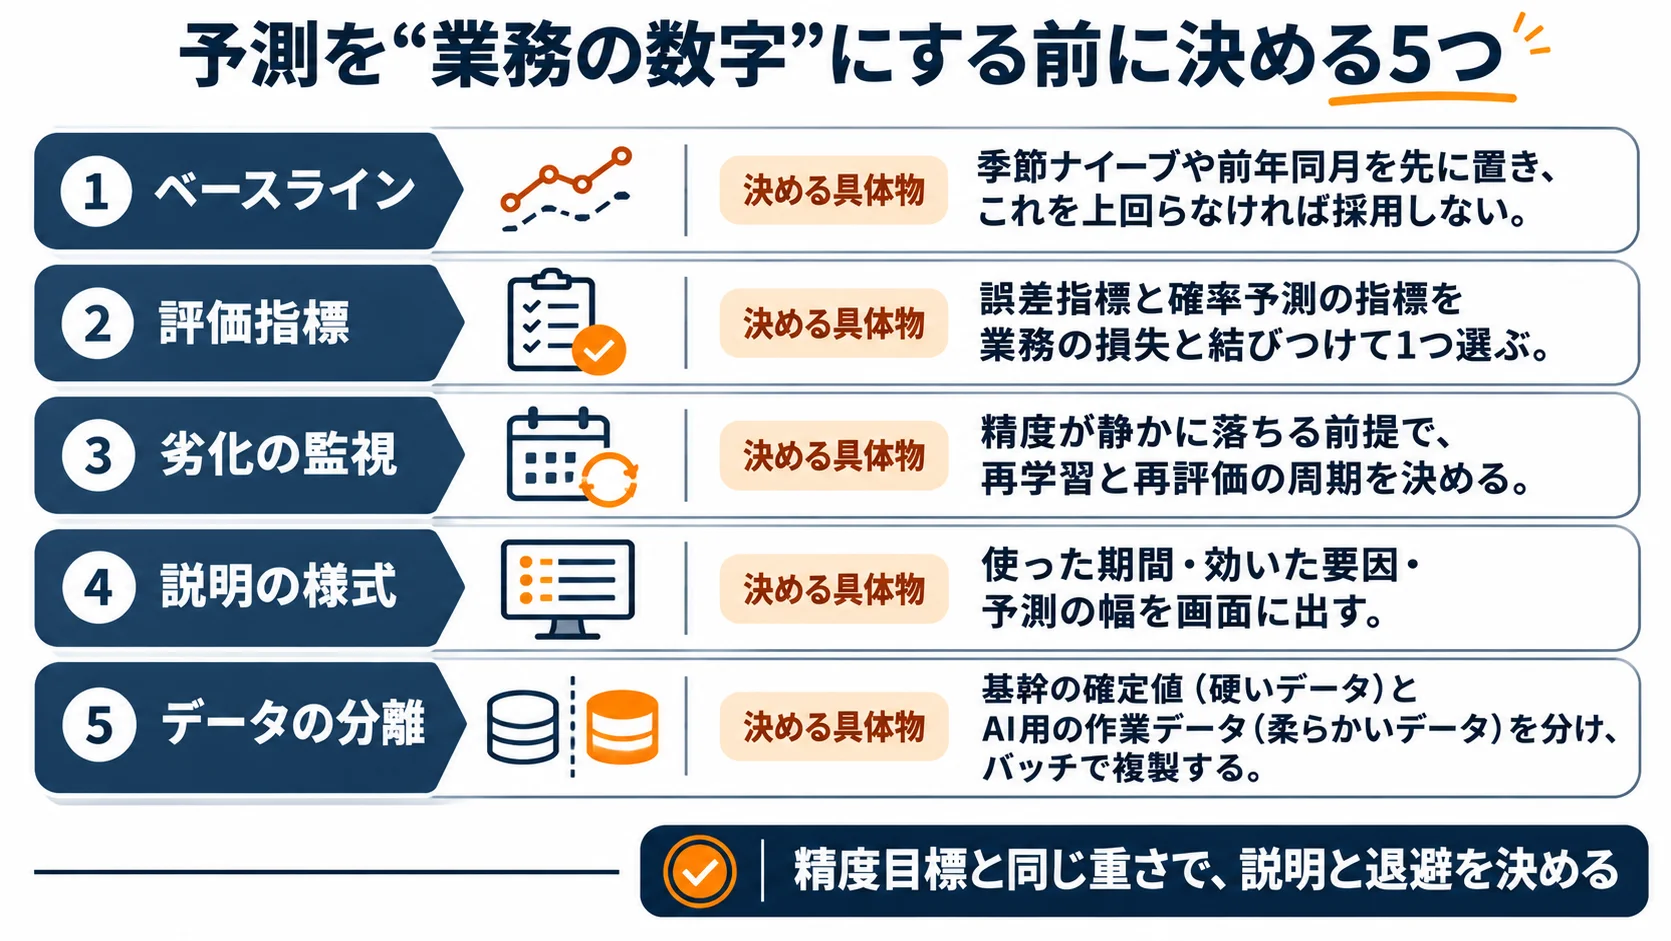
これは、精度目標と同じ重さで説明と退避を決めるという考え方を一覧にした図です。
導入前に確かめる5つのこと
計画系のシステムで痛い目を見ないために、着手前に決めておく項目を挙げます。順番にも意味があります。
- ベースラインを先に置く。 季節ナイーブ(前年同月や直近の季節パターンをそのまま使う素朴な予測)や、現在の担当者の勘を数値化したものを先に測ります。これを上回らないなら、どんな高度な手法も採用しません。ベースラインのない精度の議論は、水掛け論になります。
- 評価指標を業務の損失と結びつける。 誤差を小さくするのか、欠品を避けるのか、廃棄を抑えるのか。先に挙げた製薬メーカーの方のように「多少の廃棄は許容範囲」と言える業務なら、指標の置き方が変わります。
- 劣化の監視を設計に入れる。 予測モデルは学習時のデータ分布が続く前提に立っているので、相場や販売チャネルが変わると精度が静かに落ちます。再学習と再評価の周期を、運用開始前に決めておきます。
- 説明の様式を決める。 使った期間、効いた要因、予測の幅。この3つを画面に出す約束を、要件に書き込みます。
- 硬いデータと柔らかいデータを分ける。 基幹システムの確定値(硬いデータ)と、AIが扱う作業用データ(柔らかいデータ)を混ぜないことです。私たちは基幹の横にデータ空間を設け、バッチで複製する「仮想のブロックエリア」方式を採ります。AIはインフラを選ばないので、オンプレでも閉域環境でも同じ形で組めます。この前提が崩れている状態についてはデータ敗戦とAI-Readyデータの罠に書きました。
正直な話、LQMが要らないケース
万能の道具として紹介するつもりはありません。私たちの経験では、次のような場合は定量モデルの検討より先に別のことをやるべきです。
数字の元になる帳票が人の手で毎回加工されている場合。先ほどの「原価表の7割がブラックボックス」という状態では、どんなモデルを載せても出力の検証ができません。ここは機械が読める形に帳票を直すほうが先です。
月次で十分な判断に、日次の予測を入れようとしている場合。予測の粒度を上げると運用の手間が跳ね上がります。粒度は業務の意思決定の頻度に合わせるのが基本です。
そして、計画の精度より計画の運用に問題がある場合。ある老舗化粧品メーカーの生産計画担当の方は「完璧なものにしようとすればするほど無理が生じることが分かってきた」「臨機応変な修正がどうしても必要だ」と話されていました。満点を目指さず、人が直せる余地を残す設計のほうが現場では回ります。精度を1ポイント上げる投資より、修正を5分で終わらせる画面のほうが効くことがあるのです。
私たちはLQMをどう位置づけているか
ここまで慎重な話をしてきましたが、方向としてこの流れは正しいと考えています。理由は、私たち自身が数量の案件で同じ結論に先に着いていたからです。
ある製薬・ヘルスケアメーカー(従業員330名規模)では、SKU(在庫管理の最小単位)ごとの需要予測コックピットを本番に載せ、発注要否の判定からBOM(部品表)連携まで作り込みました。ある化粧品メーカーでは、生産計画と製造管理のシステムを再構築し、自社管理のクラウドへ全面移行しています。こうした案件で生成AIが担っているのは、予測の本体ではありません。要件の整理、画面の生成、説明文の作成、そしてテストです。数字そのものは統計と計算器が出し、言語モデルはその周りを速くしています。
LQMという言葉が広まることの価値は、この分担に名前が付くことだと思っています。「AIで数字を」という曖昧な依頼が、「どの数字をどの道具に渡すか」という設計の会話に変わります。ガートナーの10項目は毎年トレンド語を増やしますが、現場にとって使えるのは、社内の会話の解像度を上げてくれる語だけです。LQMはその一つになると見ています。同じ10項目からは使い捨てアプリケーションも取り上げました。言語を生成しない判断AIを扱った「文章を書かないAI」Jevの使いどころも、同じ線引きの話として読めます。
もう一点、私たちの立場として申し上げておきます。AIは壁打ち相手であり、判断は人間がするものです。定量モデルが精緻になるほど、「モデルがそう言っている」で会議が終わる危険は増えます。だから説明の様式を要件に入れ、最終判断の主体を画面の上で明示します。数字を自動化することと、責任を自動化することは別の話です。
まず試すなら
明日から動ける順に3つ挙げます。
- いま社内で動いている「数字を出すAI」を書き出す。 誰が、どの業務で、どんな入力を貼り付けて、何を出しているか。4列で十分です。この中で、集計や計算そのものを生成AIにやらせているものが、最初に手を付ける対象になります。
- 1つ選んで、ベースラインを測る。 前年同月や直近の季節パターンをそのまま使った値と、現在のAIの出力を3か月ぶん並べるだけです。ここで勝てていないケースは、私たちが見てきた中でも珍しくありません。測ると議論が一気に進みます。
- その1つに、説明の3点を足す。 使った期間、効いた要因、予測の幅。画面に出すのが難しければ、まずは月次の資料に手で書き添えるだけでも構いません。会議で聞かれる問いに先に答えておくと、数字が使われ始めます。
ここまでやって「どの数字をどの道具に渡すべきか決まらない」「帳票の整理から必要そうだ」という段階で止まるなら、業務の棚卸しから入るほうが早いです。AI-Pathでは、無償の業務プロセス診断(BPR)を実施しています。ヒアリングから業務フロー・改善案・ROI(投資回収の見通し)のたたき台までを一気に可視化し、どの数字を自動化できて、どこを人が持つべきかを一緒に見極めます。
生成AIが来てから2年、私たちは言葉の役割が速くなるのを目の前で見てきました。次に来るのは数量の番です。ただ、その番に備える準備は、新しいモデルを待つことではありません。自社の数字がどう作られているかを、もう一度自分の言葉で言えるようにしておくこと。それが、どの道具が来ても効く土台になります。
参考リンク
マイナビニュース。これはガートナージャパンの2026年11月4日の発表を伝えた報道です。LQMの定義、10項目の日本語名称、汎用言語モデルで数値計算を行うリスクの指摘の出どころになります。
arXiv。これは「Are Language Models Actually Useful for Time Series Forecasting?」(NeurIPS 2024 Spotlight採択)の原典です。LLM部分を除去しても時系列予測の精度が落ちなかった実験結果を確認できます。
SandboxAQ。これはLQMを商用提供している企業の製品ページです。物理・化学・生物・数学を土台にするという説明と、創薬での最大4倍という数値を確認できます。
Zenn。これは時系列基盤モデルと古典手法を同条件で比較した検証の記録です。季節ナイーブを1.00とした誤差指標の傾向値と、確率予測で差が出るという結論の出どころになります。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
使い捨てアプリケーションとは——2030年に新規アプリの8割。難しいのは作るほうではなく、畳むほう
ガートナーが2027年の戦略的テクノロジ・トレンドに「使い捨てアプリケーション」を入れました。2030年には新規アプリの80%を使い捨て・交換容易にするという予測です。1日で作れる時代に本当に難しいのは廃止のほうでした。廃止日・データ・権限・会計の4点から、畳める設計の作り方をお伝えします。
自動化バイアスとは——「人が最終確認しています」が統制にならない理由と、承認フローの作り直し方
AIの出力に人が承認を押す。この一手間があれば統制は効く、という前提が崩れています。放射線科医27名の実験では、AIが誤った提示をすると15年以上のベテランでも正答率が82%から45.5%へ落ちました。自動化バイアスが承認を形だけにする仕組みと、承認フローをどう作り直すかをお伝えします。
「データ敗戦」を3度目にしないために——AI-Readyデータの罠と、経営が最初に決める順番
ガートナーは、AI-Readyなデータに支えられていないAIプロジェクトの60%が放棄されると予測しました。データレイク、マスターデータ統合に続く3度目の「データ敗戦」です。なぜ同じ負け方を繰り返すのか、どの順番で手を付けるのか、ベンダー提案に何を聞き返すのかを、製造業の基幹とデータを作り直してきた経験から整理します。