「データ敗戦」を3度目にしないために——AI-Readyデータの罠と、経営が最初に決める順番
「AIを入れる前に、まずデータを整えましょう」——そう言われて基盤構築の見積書を受け取り、判断に詰まっている経営者の方からご相談をいただきます。ガートナーは2025年2月の発表で、AI-Readyなデータに支えられていないAIプロジェクトの60%が2026年までに放棄されると予測しました。日本ではこれが3度目の「データ敗戦」だと指摘されています。詰まる理由は金額ではありません。整えた先に何が起きるのかが、誰の口からも出てこないからです。ここでは、過去2回と何が同じなのか、どの順番で手を付けるのか、ベンダーの提案に何を聞き返すのかを、製造業の基幹とデータを作り直してきた経験からお伝えします。
- 01「データ敗戦」のよくある質問【5問5答】
- 02「データは揃ってきた。その先が難しい」——ある大手化学メーカーの一言
- 03「データ敗戦」とは何か——3度目だと言われる理由
- 041度目:データレイクは、作った人と使う人が別だった
- 052度目:マスターデータ統合は、IT部門の案件になった瞬間に止まる
- 063度目の罠:「高品質」とAI-Readyは別物——該当するのは約4%
- 07日本の数字は改善している——2.2%→3%→8%の読み方
- 08「データが汚いからAIが動かない」は因果が逆
- 09全社整備から始めない——硬いデータと柔らかいデータを分ける
- 10ベンダー提案に聞き返す7つの質問
- 11私たちの現場経験では、マスター化は「正しさ」より「誰が直すか」で決まる
- 12自己診断:自社はどの敗戦の入口にいるか
- 13まず試すなら
- 14参考リンク
「データ敗戦」のよくある質問【5問5答】
データ整備のご相談をお受けすると、いただく質問はだいたい5つに集まります。まず1問1答でお答えし、そのうえで詳しくご案内します。
Q1. 「データ敗戦」とは何を指す言葉でしょうか。
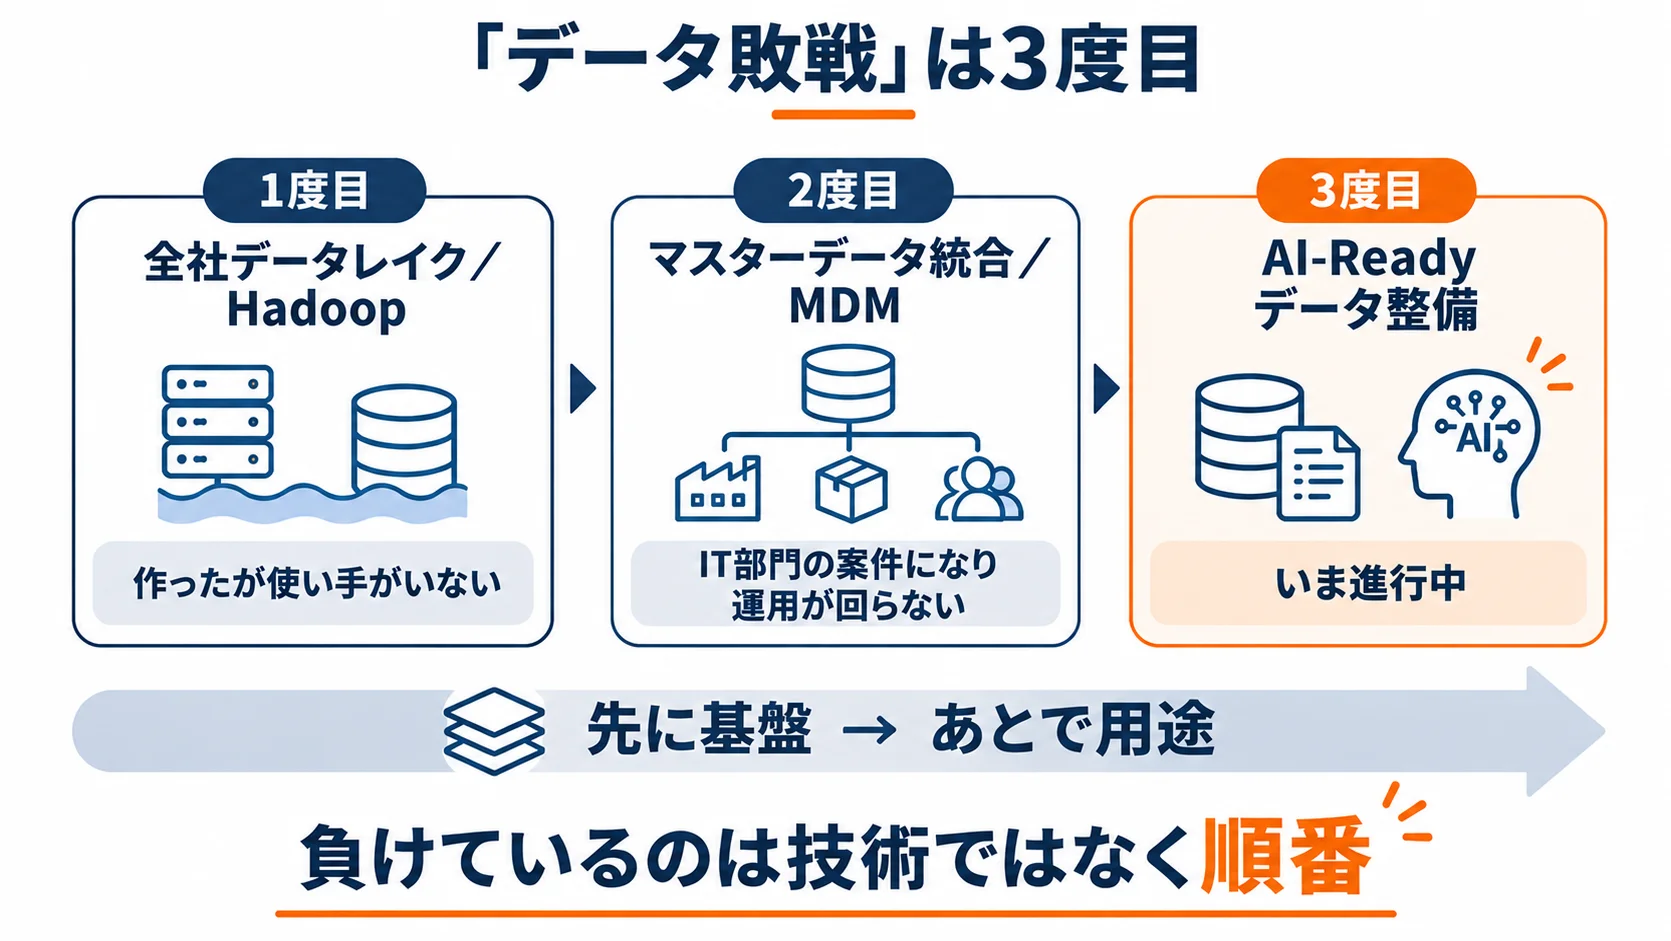
日本企業がデータ活用の取り組みで成果を出せないまま投資を終えてきた、その繰り返しを指す言い方です。ガートナージャパンのアナリストが、AI時代に同じ負け方が再現されつつあると指摘したことから広がりました。1度目は全社データレイクの構築、2度目はマスターデータ統合、そして3度目がいま進行中のAI向けデータ整備です。技術は3回とも違います。それでもデータ活用の失敗の理由は、ほぼ同じでした。
Q2. 「AI-Readyデータ」は、従来の「きれいなデータ」と違うのでしょうか。
違います。ここが3度目の罠の中心です。欠損がなく表記も揃っている——従来の品質基準で合格するデータが、そのままAIに使えるとは限りません。AIが必要とするのは、その数値が業務上どういう意味なのか、どこから来てどう変わってきたのか、という文脈側の情報です。ガートナーの整理では、AI-Readyと言える状態のデータを持つ組織は約4%にとどまります。
Q3. 「まずデータ基盤を作る」という提案は、受けるべきでしょうか。
目的の業務が決まっていないなら、いったん止めることをおすすめします。過去2回の敗戦は、いずれも「基盤を作れば使われるはず」という順番から始まっていました。データ整備の順番は、基盤の設計より先に決まります。先に決めるのは、どの業務の、どの判断を、誰が速くするのか。それが1つ決まれば、必要なデータの範囲は驚くほど狭くなります。基盤の規模はその後に決まる話です。
Q4. データが汚いので、AIは当面無理だと思っています。
逆の順番で考えてみてください。全部きれいにしてから始めると、終わる前に予算と関心が切れます。私たちは1業務分だけを対象に、1日で動くプロトタイプを作って現場に触ってもらいます。そこで初めて「このデータのこの曖昧さが効く」「これは放置でよい」が分かります。直す対象を決めるために動くものを作る、という順番です。
Q5. どこから着手すべきか、社内で決まりません。
その状態でベンダーに相談すると、相手の売り物に合わせた範囲が決まってしまいます。AI-Pathでは無償の業務プロセス診断(BPR)を実施しています。ヒアリングから業務フロー・改善案・ROI(投資収益率:かけた費用に対してどれだけ戻るか)のたたき台までを一気に可視化し、どの業務のどのデータから手を付けるかを一緒に見極めます。最新の進め方や範囲は、この診断の場でご確認ください。
「データは揃ってきた。その先が難しい」——ある大手化学メーカーの一言
このセクションで言いたいのは、現場が詰まっているのはデータの量ではなく、その意味づけだという点です。
ある大手化学メーカーのAI推進担当の方と話していたときのことです。社内のAI活用がなぜ広がらないのかを尋ねると、少し考えてからこう返ってきました。
「データはある程度揃ってきているんです。ただ、そのデータを基に人がどう考え、どう動くかを定義・教育するのが難しい。マニュアルだけでは足りず、行間を読むような仕事をしているので」
正直に言えば、この一言を聞いたとき、私たちが整備の提案で語ってきた順番は逆だったかもしれないと感じました。足りないのはデータではない。そのデータを見て人が何を判断してきたか、という部分が誰にも書き起こされていないのです。
同じ会社の別の担当者は、内製化の実情をこう明かしてくれました。「個別にプログラミングで作ったシステムの運用・管理が昔からの課題で」「『内製できます』と謳いつつ、実際は難しい」。特に止まっているのは設計側、つまりデータモデリングと裏の処理だと言います。その一方で、社長からは「アウトプットが出てこない」というプレッシャーがかかっている。板挟みです。
この構図は1社の特殊事情ではありません。むしろ、これから見ていく3度の「データ敗戦」の共通項そのものでした。
「データ敗戦」とは何か——3度目だと言われる理由
言いたいことは1つです。この言葉は、技術の失敗ではなく順番の失敗を指しています。
2026年11月5日、@ITが「日本企業はAIで再び『データ敗戦』の失敗を繰り返すのか」という見出しで報じました。ガートナージャパンの一志達也アナリストの指摘を軸にした内容でした。要点は、全社的なデータ資産としてデータレイクを構築しても、Hadoopを導入したからといって、使い手がいなければ終わる——そういう例に事欠かない、というものでした。ここではもう1つの失敗にも触れられています。マスターデータ管理(MDM:社内に散らばる取引先・品目などの基礎情報を1つに揃える取り組み)です。その本質はIT部門ではなくビジネス側に位置付けるべきもので、「運用がままならない」と嘆く声も少なくない——そう書かれています。
ここで注目したいのは、2つの失敗が別の話として並んでいないことです。どちらも「作ったが、使い手の業務に接続されなかった」という同じ一点で負けています。
同じ指摘はEnterpriseZineのインタビューでも繰り返されています。これは要約すると、日本企業がデータ活用とAI導入で失敗を重ねる根底には、他者への依存と、自ら考える姿勢の欠如がある、という話です。そして、「データ基盤構築」「AIリテラシー向上」のように目的が曖昧な活動に向かうのではなく、経営層が自社固有の業務課題に自ら向き合うことが大事だと続きます。
辛い指摘です。ただ、私たちが製造業の現場で見てきたものと重なります。目的が曖昧な活動は、進捗が報告しやすい。「基盤を構築しました」「研修を実施しました」は数えられます。一方で「この判断が3日早くなりました」は数えにくい。数えやすいほうへ流れた結果が、3度の敗戦だったように見えます。
1度目:データレイクは、作った人と使う人が別だった
ここで押さえたいのは、1度目の敗戦が「技術が未熟だったから」ではないという点です。
全社のデータを1か所に集める。それ自体は正しい発想でした。実際に大手の製造業・金融業を中心にHadoop基盤が立ち、部門をまたいでデータが流し込まれました。ところが運用が始まると、分析を始めようとした人が最初にぶつかるのは名寄せと整形です。同じ取引先が3通りの表記で入っている。単位が部署ごとに違う。「正常」の定義が課長と係長で揃っていない。集めただけでは、そこから先に進めません。
そして決定的だったのは、集めた人と使う人が別の部署だったことです。集めた側は「要望があれば出します」と言い、使う側は「何があるのか分からないので要望が出せない」と言う。この往復のまま数年が過ぎました。
ある大手化学メーカーの生産DXグループのリーダーは、現状をこう説明してくれました。「基本、システムではつながっていないんです。繋げようとしても縦割りが強くて、事業ごとに顧客も機能も全然違う。一つのシステムでは使いづらい」。これは言い訳ではなく、事業構造の正直な説明だと受け取りました。全社で1つに統合するという前提そのものが、この会社の実態と合っていないのです。
2度目:マスターデータ統合は、IT部門の案件になった瞬間に止まる
このセクションの要点は、MDMが止まる理由が技術でも予算でもなく、「誰が直すか」が決まっていないことにある、という点です。
マスターデータ統合は、データレイクより地味で、はるかに難しい取り組みです。品目コードを1つに揃えるには、「この2つは同じ品目か」を業務の言葉で判断する人が必要になります。システムは判断してくれません。
にもかかわらず、私たちが見てきたほぼすべての会社で、この案件はIT部門に置かれていました。すると、業務側は「情報システム部がやっている件」と理解し、問い合わせへの回答が後回しになる。IT部門は判断できないまま待つ。プロジェクトは静かに止まります。一志アナリストがMDMをビジネス側に位置付けるべきと言うのは、この構造を指していると私たちは読みました。
現場の実害は生々しいものです。ある合成樹脂・産業資材メーカーで業務部門を預かる方は、原価表の状態をこう明かしてくれました。
「中身は7割くらいブラックボックス化していて、Excelで配信されるので各担当がそれぞれカスタマイズしてしまうんです。部材を一つ変えるにも、全シートのセルを一個一個探して変える。二重で計上していた箇所もありました」
同社で営業を統括する方は、社内で「秘伝のタレ」と呼ばれる工賃表についてこう言います。「細かすぎて、どこに何が書いてあって、どのケースはどの工賃を使うのかを理解した人じゃないと使えない。新入社員に渡して『これで検索して』と言っても、使いこなすのに時間がかかる」。
この2つは、どちらもマスターデータが存在しないことの帰結です。そして——ここが大事なのですが——この会社でマスター化が動き出したのは、全社のデータ定義を揃える計画を立てたときではありませんでした。見積と受注という1つの業務を自動化する話になり、その業務が工賃表を参照している、という形で必要が生まれたときです。基幹のSAPを正としたまま、工賃表だけをマスター化する。範囲が狭いから、判断できる人がすぐ決まりました。
3度目の罠:「高品質」とAI-Readyは別物——該当するのは約4%
ここで言いたいのは、従来の品質基準で合格したデータを渡しても、AIはつまずくということです。
ガートナーは2025年2月26日、「Lack of AI-Ready Data Puts AI Projects at Risk」という発表を出しました。予測はこうです。2026年までに、AI-Readyなデータに支えられていないAIプロジェクトの60%が放棄される。ただ、同じ発表に添えられた数字のほうが、私にはこたえました。組織の63%が、AIに適したデータマネジメントの手法を持っていない、あるいは持っているかどうか分からないと答えているのです。2024年第3四半期に、データマネジメント責任者248名への調査で出た数字になります。
「分からない」が含まれている点に注目してください。これは準備不足ではなく、自社の現在地を把握できていない状態を意味します。
では、AI-Readyとは何が違うのか。ガートナーのアナリスト、Roxane Edjlali氏の解説が要件を整理しています。欠損や外れ値の処理といった従来型の品質管理に加えて、意味づけとアノテーション、来歴(どこから来てどう変わったか)、そしてユースケースへの適合性の検証が要る、と。つまり、データを洗う作業ではなく、データに文脈を足す作業です。そしてそこに示された数字が重い——AI-Readyと言える状態のデータを持つ組織は、約4%でした。
言い換えれば、「うちのデータはきれいです」と言える会社のほとんどが、AIから見ればまだ読めない状態にある。ある大手化学メーカーのDX推進担当の方が、AI導入の手軽さについて「簡単すぎて逆に怖い」と漏らしていたのを思い出します。入力は簡単なのに、入れたものが何を意味するかは誰も保証していない。その居心地の悪さは、正しい感覚だったと思います。
日本の数字は改善している——2.2%→3%→8%の読み方
事実を正確に扱うために、日本企業の現状を数字で押さえます。ここは悲観だけで語るべきではありません。
ガートナージャパンの調査では、データ活用で全社的に十分な成果を得ている組織の割合は、2022年7月時点で2.2%、2023年11月時点で3%、そして2025年1月発表の調査で8%となりました。約4年で3.6倍です。同じ調査では、全社的もしくは一部の部門で何らかの成果を得ている割合は89%に達しています。
つまり、成果はちゃんと出始めている。部門単位では、9割近い会社が勝っているのです。
にもかかわらず、全社的に十分な成果に至っていない組織は92%です。この2つの数字を並べると、日本企業が詰まっている場所がはっきりします。「1部門で成功する」ことには成功していて、「それを横に広げる」ところで止まっているのです。
そして同調査は、成果の差が出る要因として、目的や目標を明確にしているかどうかを挙げています。基盤の規模でも予算でもなく、目的の明確さでした。一志アナリストの「目的が曖昧な活動に向かうな」という指摘と、きれいに重なります。
誤解のないように申し上げると、私たちは「全社展開するな」と言いたいわけではありません。順番の話です。1部門の成功を、全社基盤の完成を待たずに横に動かす方法があるかどうか——そこが3度目の勝ち負けを決めると考えています。
「データが汚いからAIが動かない」は因果が逆
このセクションが、この記事でいちばんお伝えしたい部分です。
AIがうまく動かないとき、原因として最初に挙がるのは「データが汚いから」です。この説明は半分正しく、そして半分が致命的に誤っています。何が汚れているのかを特定せずに「汚い」と言っている限り、やるべきことは「全部きれいにする」になります。終わりません。
正確には、こうです。AIがつまずくのは、人間が目と暗黙の了解で補っていた部分を、そのまま渡しているときです。品目コードが3通りあっても、ベテランは文脈で同一だと分かります。「要確認」というメモ欄の一言が何を意味するかも、その部署では共有されています。AIにはそれがありません。だから、汚れを落とすのではなく、補っていた部分を書き起こす作業が要るのです。
これは工程としては地味ですが、範囲が絞れるという大きな利点があります。全社のデータ定義を揃える必要はない。いま自動化したい1つの判断に効く曖昧さだけを、業務の言葉で書き出せばいい。
帳票そのものの形が壁になっている場合も少なくありません。印刷前提で作られたExcelは、人間には読めてAIには読めません。この構造の問題は「神Excel」はAIに読めないに詳しく書きました。社内文書をAIに読ませる仕組みそのものの考え方はRAGとは何かで整理しています。
ここで1つ留保を置きます。ある老舗化粧品メーカーの生産計画担当の方が言っていた「完璧なものにしようとすればするほど無理が生じることが分かってきた」という言葉は、データ整備にもそのまま当てはまります。書き起こしも、完璧を目指した瞬間に終わらなくなる。臨機応変に人が判断する余地は、意図的に残すべきです。
全社整備から始めない——硬いデータと柔らかいデータを分ける
ここからは処方の話です。私たちが現場で採っている形をお伝えします。
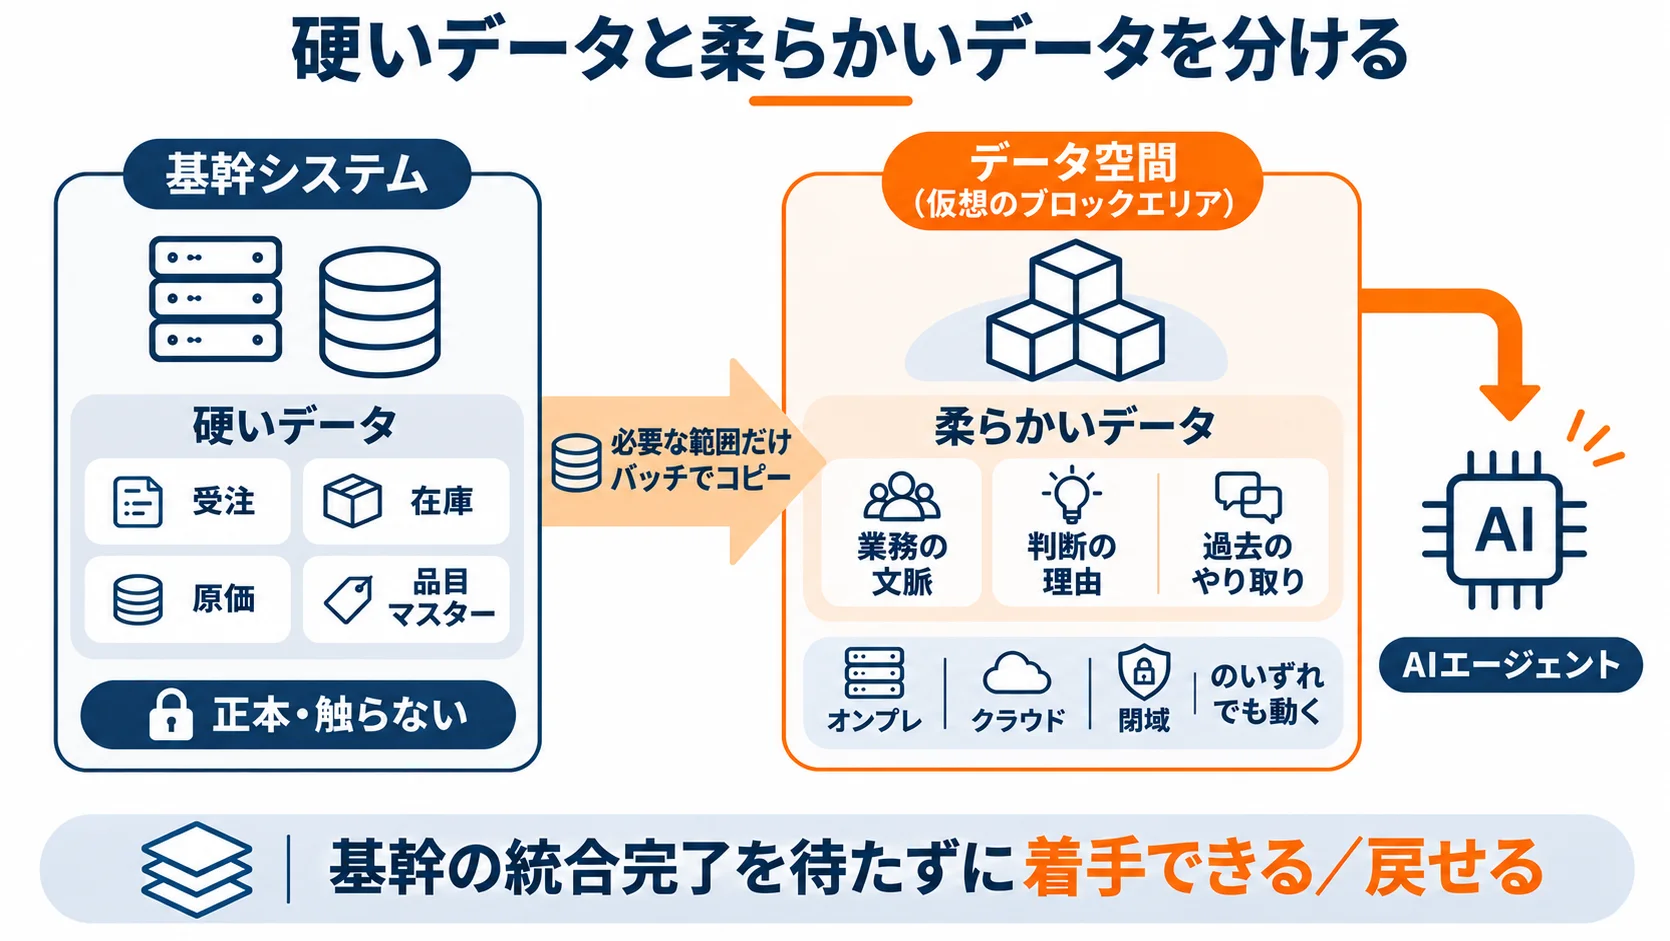
私たちは顧客のデータを、硬いデータと柔らかいデータに分けて考えます。硬いデータは基幹システムが持つ正本です。受注、在庫、原価、品目マスター。これは正しさが最優先で、勝手に形を変えてはいけません。柔らかいデータはAIが活用するために整えるもので、業務の文脈・判断の理由・過去のやり取りが入ります。
この2つを同じ場所で同じルールで扱おうとすると、止まります。基幹を触る話になった瞬間、関係者が増え、承認が増え、半年が過ぎるからです。
そこで私たちは、基幹システムの横にデータ空間を設け、必要な範囲だけをバッチでコピーする形を採ります。社内では仮想のブロックエリアと呼んでいます。基幹は正本として触らない。AI側は、その写しと業務文脈を組み合わせて動く。これならマスター統合の完了を待たずに着手できますし、失敗したときに戻すのも簡単です。
この形の副産物として、置き場所の自由が手に入ります。AIはインフラを選びません。オンプレミスでもクラウドでも、閉域環境でも動きます。研究開発のデータのように外に出せないものを扱う案件では、この前提が決定的になります。
実例を1つ挙げます。西日本にある化学製造業の工場では、紙とExcelに散らばっていた操業日報・工程検査・生産計画・品質会議の記録を1画面に集約し、その上でAIによる分析と異常チェックを動かしています。全社のデータ定義を揃えてから始めたわけではありません。1つの工場の、日々の記録から始めました。全変更が履歴に残り、安全に巻き戻せる作りにしたことで、現場が壊す心配なく触れるようになりました。
ベンダー提案に聞き返す7つの質問
データ基盤の見積書を受け取ったとき、発注する側が握れる手札を具体的に挙げます。そのまま会議で使える形にしました。
- この整備が終わったら、どの業務のどの判断が、どれだけ速くなりますか。 答えが「全社のデータ活用が進みます」なら、目的が決まっていません。1つの業務に落ちるまで戻します。
- 対象データの範囲は、どの業務から逆算して決めましたか。 範囲が「全社」から始まっている提案は、過去2回の敗戦と同じ順番です。
- AI-Readyの定義を、御社はどう置いていますか。 欠損や重複の除去だけを答える提案は、従来のデータクレンジングをAI向けと言い換えているだけの可能性があります。意味づけ・来歴・ユースケース適合性に言及があるかを見ます。
- データの意味を業務の言葉で決めるのは、どちら側の誰ですか。 ここが曖昧なまま始まると、MDMと同じ止まり方をします。自社側の担当者名が出るまで詰めてください。
- 基幹システムは触りますか。触らない選択は可能ですか。 触らない構成が提示できるベンダーは、戻せる設計を考えています。
- 成果が出なかったと判断する基準と、その時点はいつですか。 撤退条件のない整備案件は、延命し続けます。
- 運用開始後、データの定義を変えたいとき、社内の誰が自分で変えられますか。 自走できないと、毎回の変更が追加費用になります。
この7つの中で、私たちがいちばん効くと考えているのは4番です。ある大手化学メーカー(農薬・ファインケミカル系)で企画業務を統括する方は、2027年稼働予定の基幹刷新について、自分も中身を見ているが手応えを感じられない、と率直に漏らしていました。それでも、もう後戻りはできない。要件は固めた、あとはどうにでもしてくれ——という状態です。4番を最初に詰めておけば、この地点には立たずに済みます。
私たちの現場経験では、マスター化は「正しさ」より「誰が直すか」で決まる
ここは意見が分かれるところですが、私たちの立場を書きます。
マスターデータを整える案件で最初に決めるべきは、正しいコード体系ではありません。間違いが見つかったときに、誰がその場で直せるのかです。
理由は単純です。データの定義は、いずれ業務の実態と合わなくなります。品目の括り方は事業の変化で変わります。新しい取引形態が出れば区分が足りなくなる。最初に完璧な体系を設計しても、3か月後には例外が出ます。そのとき、情報システム部に依頼を出して2週間待つ運用なら、現場は自分のExcelに戻ります。原価表が7割ブラックボックス化するのは、こうして起きます。
ですから私たちは、非エンジニアの担当者が自分で触れる範囲を先に決めます。社内の内製支援でも顧客の内製担当への指導でも、線引きは同じです。データベースを直接いじらないものに留める。メインに直接反映せず、まず変更案として上げる。上げると機械が中身を確認して妥当性を見る。この範囲なら、何を壊しても戻せます。
もう1つ、効果の伝え方にも触れておきます。ある重工・製鋼メーカーのシステムグループのマネージャーが、こう吐露していました。「開発にAIを入れてコールを30%削減しました、とQC発表で報告したんですが、全然評価が悪くて。あまり響かなかった」。社内の報告としては、削減率の出し方そのものは正しいものでした。けれど聞いている側が知りたかったのは、金額と人の話だったのです。データ整備の成果も同じで、「名寄せが完了しました」では誰も評価しません。「この判断にかかっていた3日が、半日になりました」まで翻訳して初めて、次の予算がつきます。ROIの数え方そのものはAIエージェントのROIとデータ設計も参考になるはずです。
自己診断:自社はどの敗戦の入口にいるか
最後に、現在地の見分け方を置きます。社内で読み合わせできる形にしました。
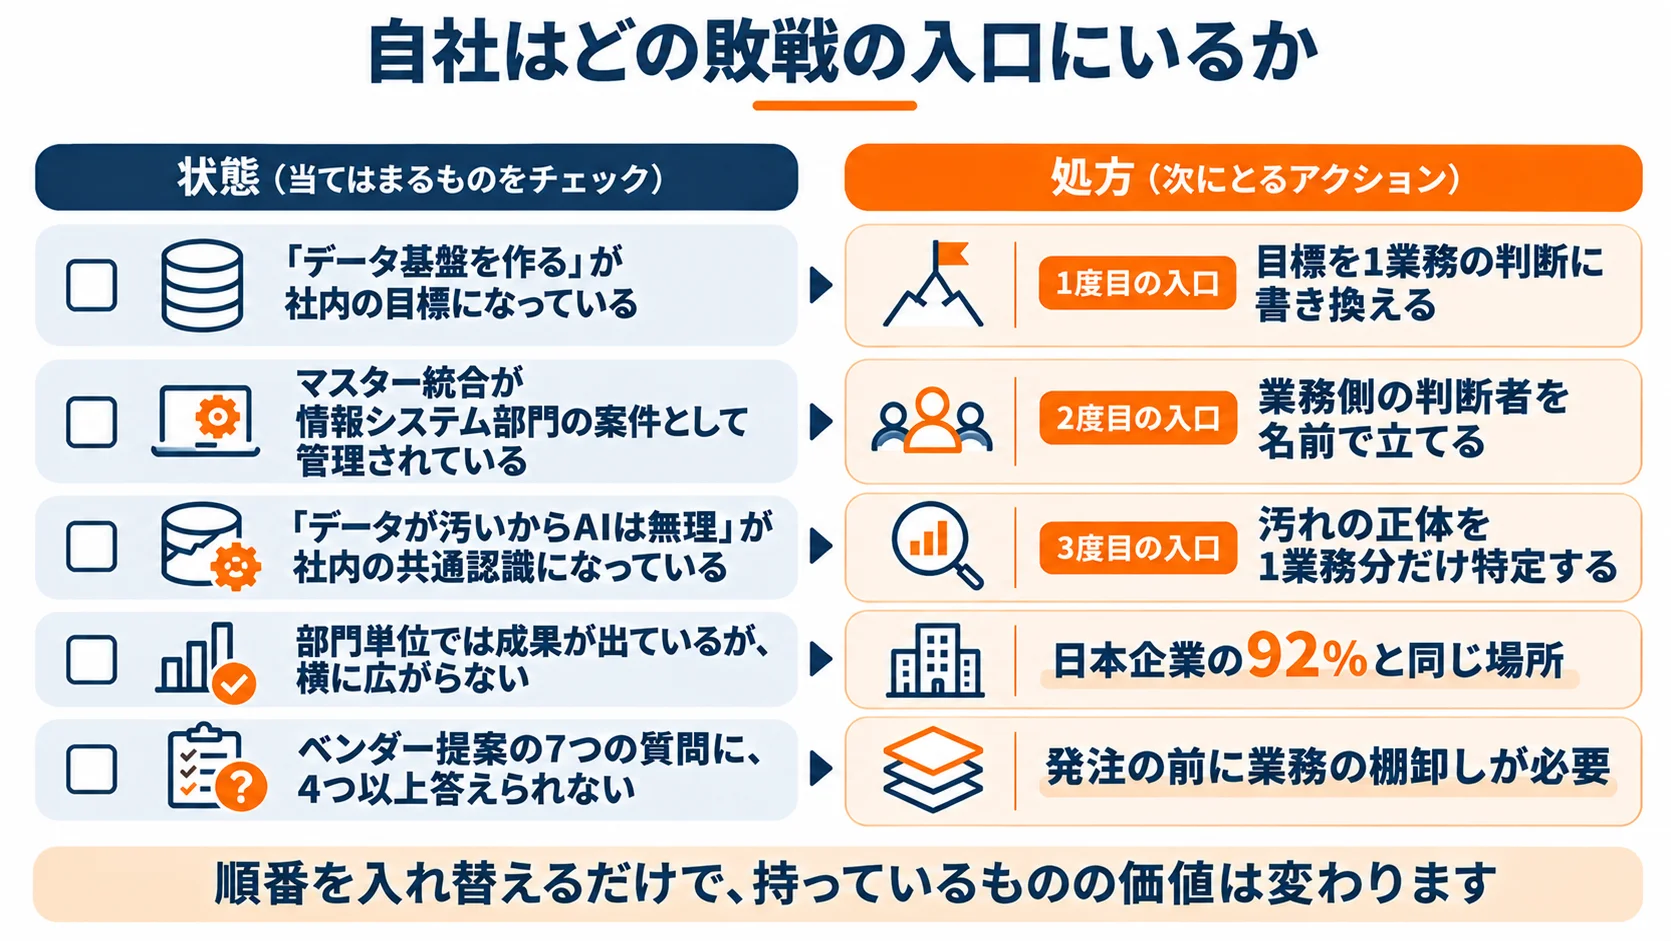
- 「データ基盤を作る」が社内の目標になっている → 1度目の入口です。目標を1つの業務の判断に書き換えてください。基盤の規模はその後で決まります。
- マスター統合が情報システム部門の案件として管理されている → 2度目の入口です。業務側の判断者を名前で立てるところからやり直します。
- 「データが汚いからAIは無理」が社内の共通認識になっている → 3度目の入口です。汚れの正体を1業務分だけ特定してください。全部ではありません。
- 部門単位では成果が出ているが、横に広がらない → 日本企業の92%と同じ場所にいます。全社基盤の完成を待たずに横展開する構成を検討する段階です。
- ベンダー提案の7つの質問に、4つ以上答えられない → 発注の前に業務の棚卸しが必要です。
誤解のないように申し上げると、どれかに当てはまったからといって、投資が無駄になったわけではありません。データレイクを作った会社には、集める仕組みと流す経路が残っています。MDMに着手した会社には、定義を議論した記録があります。3度目で勝つために使える資産です。順番を入れ替えるだけで、持っているものの価値は変わります。
まず試すなら
明日から動ける順番で3つ挙げます。
- 業務を1つだけ選び、その判断を1行で書く。 「毎週の発注量を決める」「見積の工賃を引く」など、人が繰り返している判断を1つ選びます。対象データの範囲は、この1行から逆算すると自然に狭くなります。全社の棚卸しから始めないことが、この工程の肝です。
- その判断でベテランが補っている暗黙の了解を、3つ書き出す。 「この表記は同じ品目として扱う」「この欄が空なら前月を踏襲する」といった類です。3つで構いません。ここがAI-Readyの出発点で、データクレンジングとの違いが出る場所でもあります。
- 受け取っている提案に、7つの質問をぶつける。 特に4番(データの意味を業務の言葉で決めるのは誰か)と6番(成果が出なかったと判断する基準と時点)です。この2つに答えが返ってくるかどうかで、相手が整備を売りたいのか成果を出したいのかが分かります。
ここまでやって「どの業務から手を付けるか決まらない」「社内の合意が取れない」という段階で止まるなら、業務の棚卸しから入るほうが早いです。AI-Pathでは、無償の業務プロセス診断(BPR)を実施しています。ヒアリングから業務フロー・改善案・ROIのたたき台までを一気に可視化し、どのデータにAIが効くかを一緒に見極めます。そして私たちは、この議論を資料で止めません。1日で動くプロトタイプを作り、実際のデータを食わせて何が返るかを見ていただきます。診断そのものの考え方はAI導入より先にやるべきこと:業務プロセス診断(BPR)が成否を決める理由にまとめました。
3度目の敗戦は、まだ決まっていません。決めるのは基盤の大きさではなく、最初に選ぶ1つの業務です。
参考リンク
Gartner のプレスリリース(英文)。これは2025年2月26日の発表です。60%放棄の予測と、組織の63%が「AIに適したデータマネジメント手法がない/分からない」と答えた調査(2024年第3四半期・248名)の出典になります。
ガートナージャパンの調査結果。これは2025年1月23日の発表です。全社的に十分な成果を得ている組織は8%(前回調査3%)、全社または一部で成果ありは89%という数字の出典になります。
@IT「データ敗戦」の記事。これは2026年11月5日に公開されました。データレイクとMDMの失敗がAIで再現されつつあるという、ガートナージャパンの一志達也アナリストの指摘を扱っています。
@IT「データをAI-Readyにするには」。これはGartner Insights Pickup の翻訳にあたります。従来のデータ品質とAI-Readyの違い、および「AI-Readyと言えるデータを持つ組織は約4%」の出典になります。
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム
使い捨てアプリケーションとは——2030年に新規アプリの8割。難しいのは作るほうではなく、畳むほう
ガートナーが2027年の戦略的テクノロジ・トレンドに「使い捨てアプリケーション」を入れました。2030年には新規アプリの80%を使い捨て・交換容易にするという予測です。1日で作れる時代に本当に難しいのは廃止のほうでした。廃止日・データ・権限・会計の4点から、畳める設計の作り方をお伝えします。
自動化バイアスとは——「人が最終確認しています」が統制にならない理由と、承認フローの作り直し方
AIの出力に人が承認を押す。この一手間があれば統制は効く、という前提が崩れています。放射線科医27名の実験では、AIが誤った提示をすると15年以上のベテランでも正答率が82%から45.5%へ落ちました。自動化バイアスが承認を形だけにする仕組みと、承認フローをどう作り直すかをお伝えします。
「トークン爆発」で予算が半年で尽きる——AI利用料を読めるようにする予算設計と、見積書の7項目
トークンの単価は下がり続けているのに、AIの請求額は増えます。日経ビジネスは1年分の予算を5カ月半で使い切る企業を「トークン爆発」と報じました。請求が増えた原因の切り分け方、「1件あたり」で予算を立て直す手順、ベンダー見積書に書かせる7項目を、自社でトークンを計上してきた経験からお伝えします。