社内でAIエージェントを作った瞬間、会社は「AI利用者」ではなくなる——AI事業者ガイドライン第1.2版を実装に翻訳する

「AIは使えています。ただ、今使えているのは自分のパソコンの中までなんです」——ある大手化学メーカーで企画業務を束ねる責任者が、少し困った顔でそう言いました。個人で成果は出ている。なのに隣の部署へ広げられない。止めているのは技術ではなく、「誰がどこまで任せてよいか」を決める線引きが社内に無いことでした。2026年3月31日、総務省・経済産業省が「AI事業者ガイドライン(第1.2版)」を公表し、AIエージェントが正面から対象に入りました。「AI事業者ガイドライン AIエージェント」「AI事業者ガイドライン 第1.2版」「AIエージェント ガバナンス 企業」「AI利用者 AI提供者 区分」。こうした言葉で調べて、この記事にたどり着いた方もいるはずです。罰則のない指針が、なぜ実装の話になるのか。一次資料を読み込んだうえで、私たちAI-Pathが自社と顧客の環境で実際にやっていることを交えてお伝えします。
- 01「自分のパソコンの中まで」で止まる会社と、広げられた会社の差
- 02第1.2版で何が変わったのか——エージェントが「例外」ではなくなった
- 03社内でエージェントを作った瞬間、「利用者」から「提供者」に変わる
- 04指針が挙げたリスクは、現場の事故とそのまま一致する
- 05「人間の監視だけでは足りない」と政府文書が書いた意味
- 06罰則が無いのに、無視できない理由
- 07承認境界・最小権限・証跡を、文書ではなく機構で持つ
- 08トレーサビリティは「入力・出力・結果」を残すだけでは足りない
- 09私たちの見解: チェックリストは文書ではなくCIに置く
- 10どこから始めるか——1業務・1エージェントで棚卸す
- 11よくある質問
- 12まず試すなら
- 13参考リンク
「自分のパソコンの中まで」で止まる会社と、広げられた会社の差
冒頭の責任者の言葉には続きがありました。「なぜ他の人のところまで広げられないのかが分からない」。ツールは全社契約済み。予算もある。それでも横展開が進まない。
私たちが同じ相談を受けるとき、詰まっている場所はほぼ同じです。個人利用なら、間違った出力が出ても本人が気づいて捨てます。ところが部門に配ると、その出力を誰かが次の工程で使う。見積もりの根拠になり、発注のトリガーになり、顧客への回答になります。そのとき「誰が確認したのか」が残っていなければ、部門長は承認印を押せません。
ある大手建材・シャッターメーカーの情報システム部長は、複数の部署がそれぞれ別のAIシステムを作り始めた状況をこう警戒していました。「最適なやり方とセキュリティ要件を見定めないと、正直、一時の投資になってしまう」。投資が無駄になるかどうかの分かれ目を、機能ではなく要件の見定めに置いている——この感覚は正確だと思います。
第1.2版は、まさにこの「見定め」の共通言語として使えます。法律ではないので誰も逮捕されません。ただ、社内の合意形成と、取引先への説明には効きます。
第1.2版で何が変わったのか——エージェントが「例外」ではなくなった
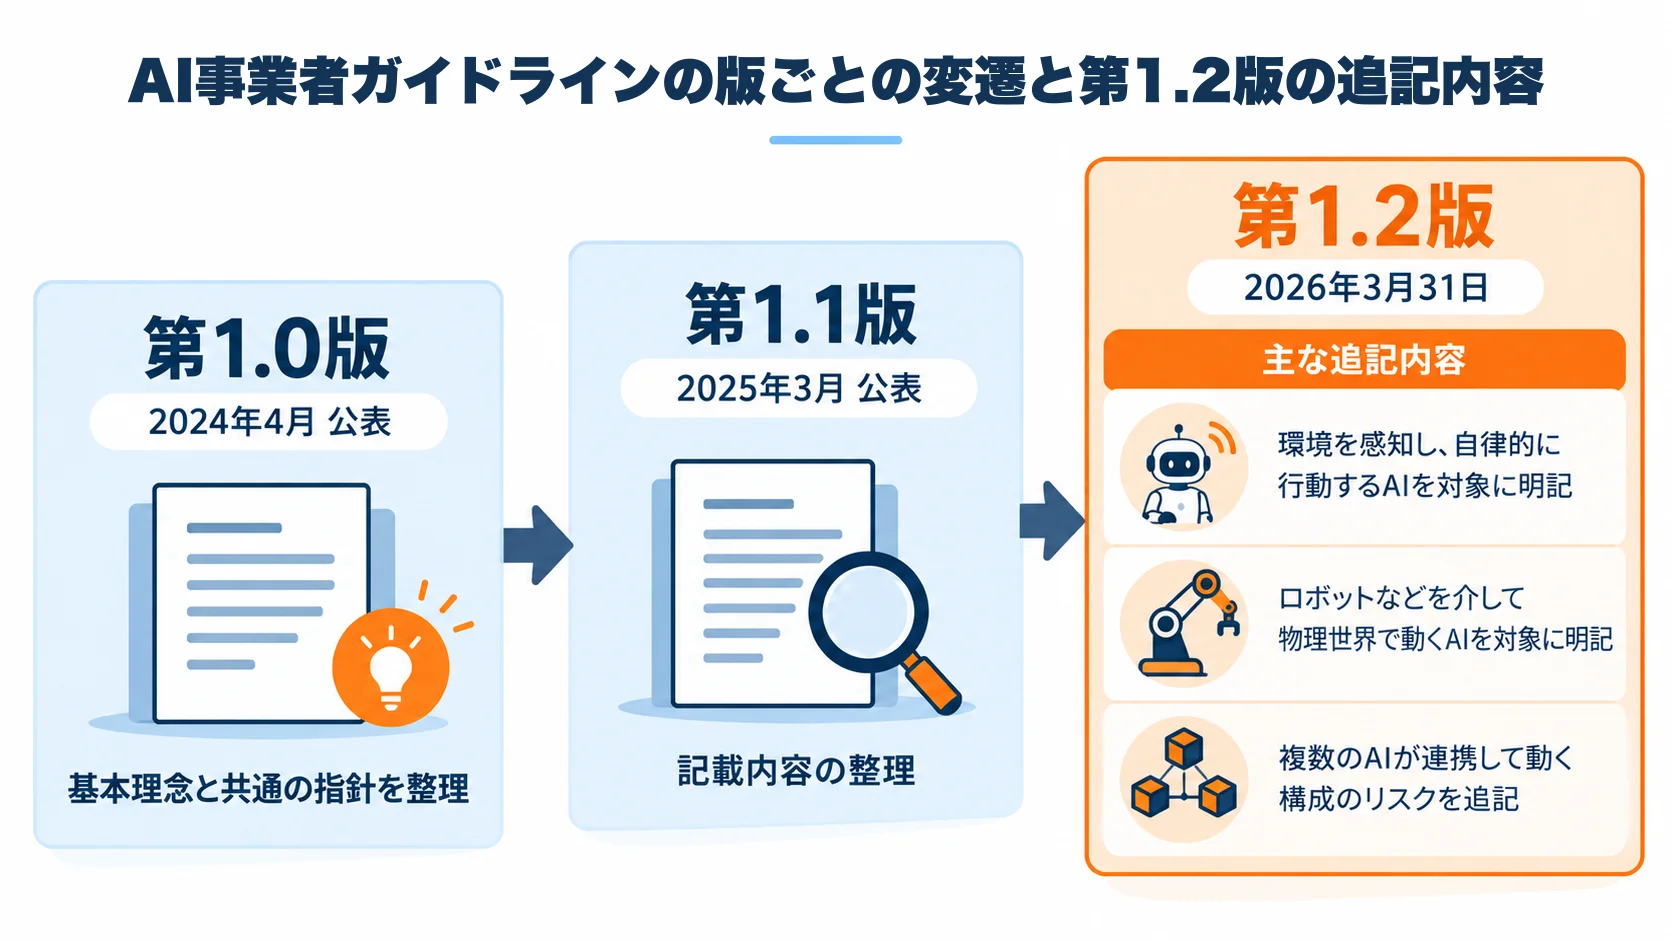
AI事業者ガイドラインは、総務省と経済産業省が共同でまとめている、日本企業向けのAI活用の指針です。2024年4月に第1.0版、2025年3月に第1.1版、そして2026年3月31日に第1.2版が公表されました。
第1.2版の更新点は複数ありますが、実務に直結するのは1点です。AIエージェントとフィジカルAI(センサーで物理環境を認識し、ロボットなどを介して実際に動くAI)が、定義・便益・リスク・対策のすべてに書き込まれたこと。PwCの解説によれば、第1.2版はAIエージェントを「特定の目標を達成するために、環境を感知し自律的に行動するAI」と定義しました。対策として挙げられたのは2点。権限を適切に設定すること、そして人間の判断を介在させる仕組みを作ることです。
ここで押さえておきたいのは、ガイドラインが全企業に一律の対応を求める文書ではないという点です。別添にはこう書かれています。
過度にリスク対策を講じることは、コスト増になる等、AI活用によって得られる便益を阻害してしまうことから、リスク対策の程度をリスクの性質及び蓋然性の高さに対応させるリスクベースアプローチの考え方が重要である。
つまり「全部やれ」ではなく「自社のリスクに見合う分だけやれ」。ある大手化学メーカーのDX推進担当者が「セキュリティ対策がトゥーマッチにならないか」と懸念を口にしたことがありますが、その懸念はガイドライン自身が先回りして否定しています。過剰防衛は、この文書の推奨ではありません。
社内でエージェントを作った瞬間、「利用者」から「提供者」に変わる
ここからが、競合の解説記事がほとんど触れていない部分です。
ガイドラインは企業を3つの主体に分けます。AIモデルを開発する「AI開発者」、AIシステム・サービスを提供する「AI提供者」、業務で使う「AI利用者」。ChatGPTやCopilotを業務で使っているだけなら、自社はAI利用者。ここまでは、どの解説記事にも書いてあります。
問題はその先です。第1.2版の別添には、AIシステム・サービスの具体例が一覧で載っています。そこに、コード生成AIサービスを使って独自のAIシステムを構築したソフトウェア開発会社の例があり、こう注記されています。AI利用者でありながらAI提供者としての区分も兼ねており、新規開発したAIサービスの保守・運用の役割も担う、と。AIエージェント作成サービスで自社業務用のエージェントを構築した企業についても、同じ注記が付いています。
これは、内製化を進めている会社にとって見過ごせない記述です。整理するとこうなります。
| よくあるケース | ガイドライン上の立場 | 新たに乗ってくる責任 |
|---|---|---|
| 生成AIのチャット画面を社員が業務で使う | AI利用者 | 入力データの適正性、人間による最終確認、セキュリティ対策の実施 |
| 社内文書を読ませたAIアシスタントを情シスが作り、他部署へ配る | AI利用者 + AI提供者 | 上記に加えて、システム構成の文書化、利用者への説明、脆弱性への対応、運用の継続 |
| 業務エージェントを内製し、グループ会社にも展開する | AI利用者 + AI提供者 | 上記に加えて、提供先への規約・仕様の説明、保守運用の責任主体の明確化 |
| 自社データでモデルを追加学習させて配布する | 実質的に AI開発者の領域へ | 学習データの適切性、バイアスへの配慮、開発関連情報の文書化 |
VibeCoding(自然言語でAIに指示を出し、従来の10分の1程度のコストでオーダーメイドのシステムを作る開発手法)で社内ツールを量産している会社ほど、この移動は早く起きます。作った本人は「便利ツールを作っただけ」のつもりでも、他部署が業務でそれを使った時点で、会社としては提供者の立場に立っている。
正直に申し上げると、私たち自身もこの線引きを社内で何度も引き直してきました。誰かが週末に作った便利ツールが、月曜には5人が使っていて、翌月には業務の前提になっている——AI時代の内製化では、これが珍しくありません。だからこそ、作る前ではなく配る前にチェックを置く運用に変えました。
指針が挙げたリスクは、現場の事故とそのまま一致する
第1.2版のリスク記述を読んでいて、私たちが実際に踏んだ事故と同じことが書かれていると感じた箇所が3つあります。
ひとつ目。
AIエージェントの場合、自律的な動作の中で人間の意図しない商品の注文やファイル削除等の動作を行う可能性がある
ある化粧品メーカーの内製担当者は、自分でコードを触り始めたとき「一旦、データベースをがらっと変えちゃうんじゃないかという懸念がある」と率直に尋ねてきました。心配の種類が、政府文書のリスク記述とぴったり重なります。現場の不安は、抽象的な恐怖ではなく、具体的な破壊の想像なのです。
ふたつ目。
生成AIをシステム開発に用いる場合、自然言語が直接ソースコードや設計情報に変換されるため、入力情報の信頼性がシステムの安全性に直結するリスクがある
これは内製化そのものへの警告です。人が書いた指示の曖昧さが、そのまま動くコードになる。設計レビューという緩衝材が無い状態で本番に届いてしまう危険を、ガイドラインは名指ししました。
みっつ目は、被攻撃面の話です。エージェントやマルチモーダルAIのように多様な入力経路と外部連携を持つシステムでは、攻撃対象が拡大し、データ汚染や悪意あるプロンプト攻撃のリスクがさらに高まる、と別添は指摘しています。外部のツールやデータソースに繋ぐほど、信頼できない入力の流入口が増える。私たちも自社の基盤で、RAG(社内文書を検索してAIの回答精度を上げる仕組み)でテナント間のデータが混ざりうる状態を自分たちで先に検知し、塞ぎました。作った側が気づかなければ、使う側は気づきません。
もうひとつ、地味ですが効いてくる記述があります。エージェントのような複雑な構成のシステムは、通常のAIシステムに比べてメンテナンスやトラブルシューティングの難易度が上がる、というもの。導入時の華やかさに対して、運用の重さは後から効いてきます。
「人間の監視だけでは足りない」と政府文書が書いた意味
第1.2版を読んでいて、私が最も驚いたのは脚注でした。本文ではなく、脚注です。
AIエージェントの自律性が高まるにつれ、人間による監視のみでは高速なAI間相互作用への対応が困難となる場合が十分に想定される。今後、AIシステムの相互監視等、AIの自律性に対応した新たな安全確保アプローチについても検討が期待される
「人間が最終確認します」で終わらせるな、と政府文書が書いているわけです。人間承認は必要条件であって、十分条件ではない。エージェント同士が秒単位でやり取りする領域では、人間の目は物理的に追いつきません。
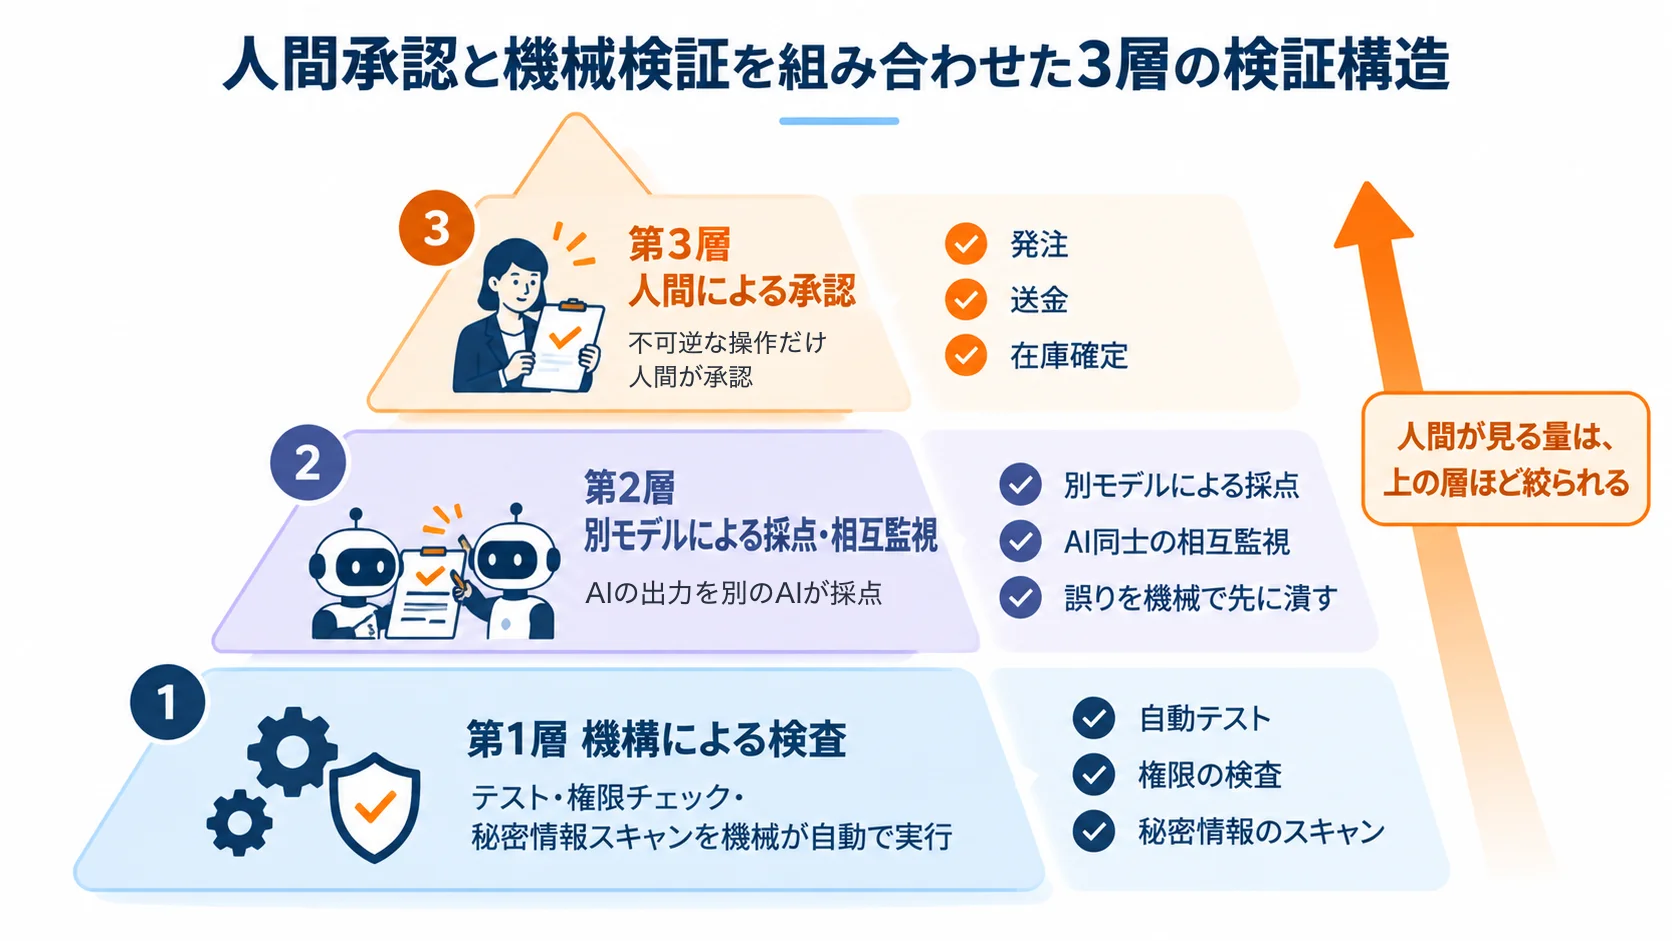
私たちはこの結論に、ガイドラインより前に実務で到達していました。社内では、あるモデルが出した回答を、別のより推論の強いモデルに採点させる運用を入れています。コストは一時的に増えます。それでも、誤りの多いモデルの出力をそのまま業務に流すより安い。AIの出力をAIに検証させる考え方は、AIエージェントの敵対的検証でも詳しく書きました。
誤解のないように申し上げると、これは人間を外す話ではありません。機械同士で潰せる誤りを機械に潰させ、人間は判断の質が問われる一点に集中する。AIは壁打ち相手であり、最終判断は人間がする——この原則は変えないまま、監視の一部を自動化するという話です。
罰則が無いのに、無視できない理由
日本のAI規制は、罰則を伴う強い規制ではありません。2025年に成立したAI推進法(人工知能関連技術の研究開発及び活用の推進に関する法律)は基本原則を定めた法律で、違反への罰則規定を持たない、いわゆるソフトローです。第1.2版も同じく指針であり、守らなくても行政処分は来ません。
では、なぜ対応するのか。理由は3つあります。
第一に、取引条件として降りてくるから。大企業や公共調達では、AI利用のポリシー有無やログの保全体制を調達要件に入れる動きが出ています。取引先の監査項目に「AI利用に関する社内規程の有無」が並んだとき、無い会社は説明の場すら得られません。罰則より、この経路のほうが実害として早く届きます。
第二に、説明できないことがそのまま事故になるから。ガイドラインの別添には、クレジットカードの与信で同じ年収の男女に異なる限度額が設定され、当局の調査に対して企業がアルゴリズムの具体的な動作を説明できなかった事例が挙げられています。この会社が困ったのは、罰則ではなく、説明能力の欠如でした。
第三に、海外規制との接続点になるから。EU AI法(EU AI Act)はEU域内でAIシステムを提供・利用する事業者を対象とし、義務が段階的に適用されています。国内取引だけなら直接の適用はありません。ただし、EUに子会社があったり、EU向けの製品にAIを組み込んでいたりすれば対象に入ります。日本のガイドラインに沿って体制を作っておくと、そのまま欧州側の説明資料の土台になります。
ここは意見が分かれるところですが、私たちは「規制対応のためにやる」という動機づけを社内で使いません。監査のために作った仕組みは、監査が終わると形骸化します。後述するとおり、日々の開発を速くする仕組みとして作ったものが、結果的に監査に耐える——この順序でないと続かない、というのが率直な実感です。
承認境界・最小権限・証跡を、文書ではなく機構で持つ
ガイドラインがAIエージェントに求めているのは、突き詰めると3つです。人間の判断を介在させること、権限を適切に設定すること、追跡できるようにすること。私たちはこれを規程ではなく、コードと設定で持っています。具体的にはこうです。
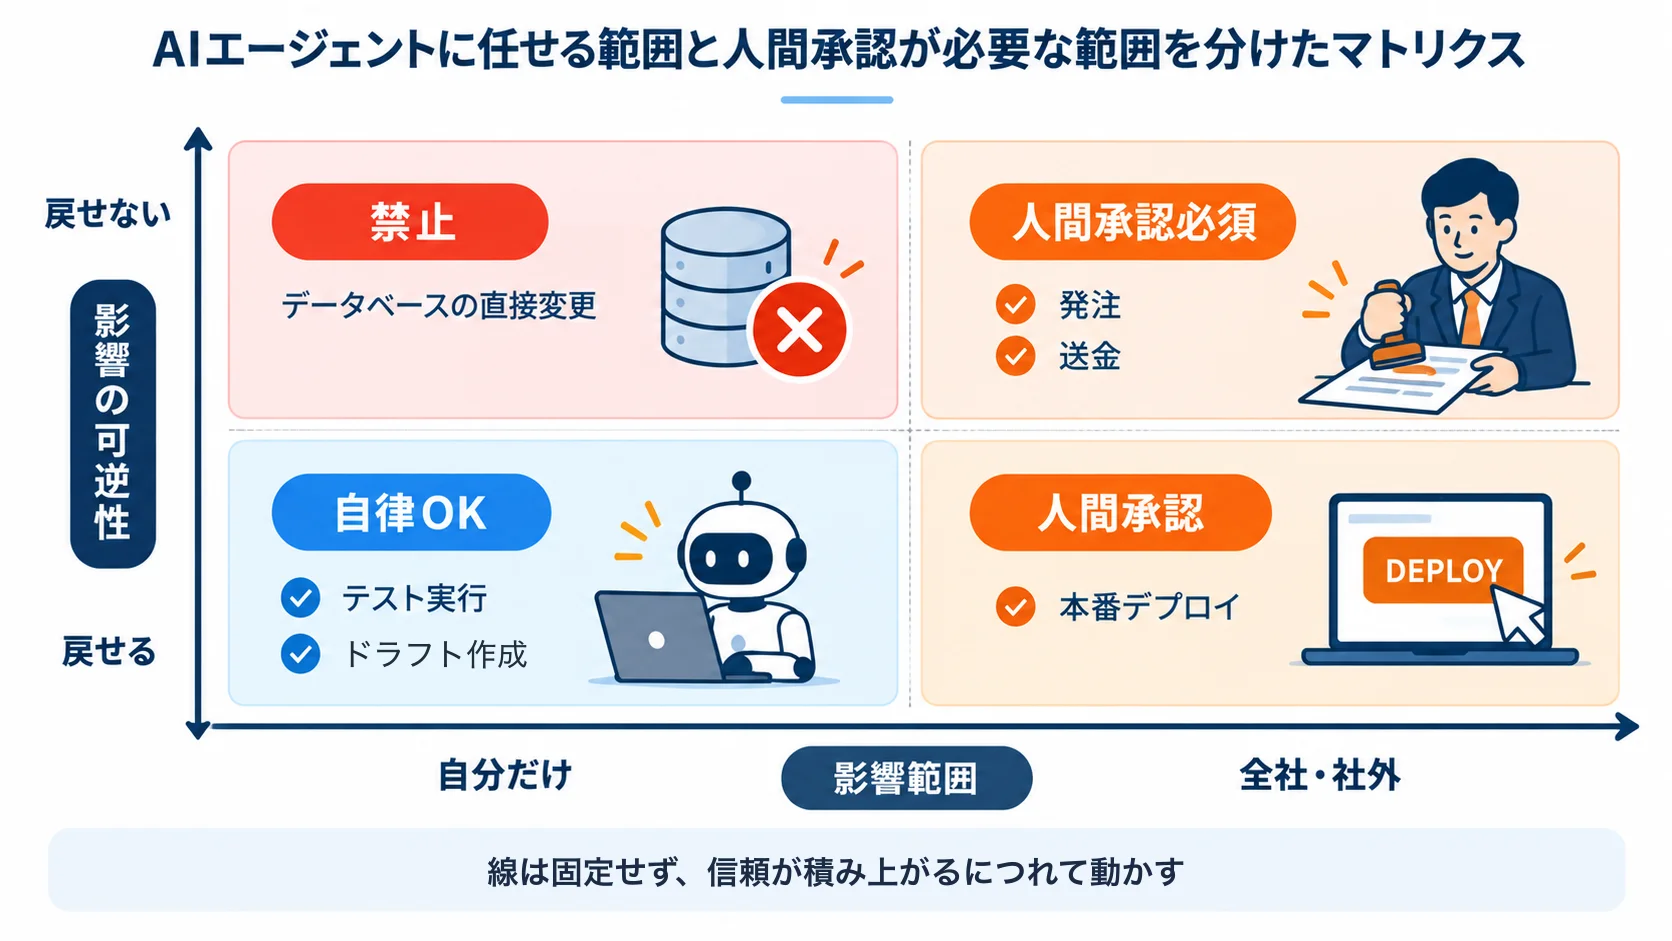
1. 承認境界をコードの手前に置く。 非エンジニアが内製に参加するとき、私たちが最初に引く線は「データベースを直接触らせない」です。自分のブランチをどれだけ汚しても復旧できますが、本番データベースを直接変更すると後戻りできません。変更はプルリクエスト(変更提案)として出してもらい、そこでAIによるレビューと人間の確認を通します。この一線だけで、事故の大半は起きなくなります。
2. 権限は機能単位で分ける。 資料の閲覧制限だけでは足りません。財務経理や人事のように、部門をまたぐと見えてはいけない領域があります。私たちは機能単位でアクセス権を振り分け、取引先ごとに権限設定のセットを運用しています。エージェントに渡す権限も同じ考え方で、「そのタスクに必要な最小限」を明示的に与える。全権限を持つ管理者アカウントをエージェントに握らせるのは、ガイドライン以前の問題です。
3. 本番反映は二段階にして、環境を色で見分ける。 先にステージング環境で直し、回帰テストが通ってから本番に出す。トレーニング環境は背景色を変えて、ひと目で本番と区別できるようにしています。これは地味ですが、「本番だと気づかずに操作した」という人的事故を機構で止める工夫です。
4. 実確定行為には、例外なく人間承認を挟む。 発注・送金・在庫確定のように、外の世界に不可逆な影響を与える操作は、エージェントの自律範囲から外します。逆に、テストの実行やドラフトの作成は自律に任せる。線は固定ではなく、信頼が積み上がるにつれて動かしていきます。
顧客の内製担当者にも、このガードレールをそのまま渡しています。ある製造業の顧客では、内製メンバーが自分でコードを触り始めた初日にこの3点を共有しました。技術を教える前に、壊れない範囲を教えるほうが早いからです。
トレーサビリティは「入力・出力・結果」を残すだけでは足りない
第1.2版はアカウンタビリティ(説明責任)の項目でトレーサビリティの向上を挙げています。解説記事の多くは、これを「入力プロンプト・ツール呼び出し・出力の3点をログに残す」と訳しています。必要な要素ではありますが、それだけでは足りません。
私たちが実際に監査ログを追う場面で毎回不足するのは、なぜその判断になったのかという文脈です。エージェントが処理を止めた記録は残っている。しかし、止めた理由が残っていない。事故のあとで「止まったこと」は証明できても、「なぜ止めたか」を誰も答えられない状態になります。
残すべき最小構成は、私たちの運用では次の5点です。
- 誰の指示で動いたか(人間の起案者、またはスケジュール実行元)
- どの権限で動いたか(使われた資格情報と、その有効範囲)
- 何を参照したか(社内の一次情報か、外部のWebか。出所を混ぜない)
- どこで人間が介在したか(承認した人、差し戻した人、その時刻)
- なぜその結論になったか(根拠として使った文書やデータへの参照)
3点目は運用上の工夫があります。社内で蓄積したナレッジ(一次情報)でまず答えさせ、「Webも追加で確認しましょう」と指示されたときだけ外部情報を混ぜる。根拠の出所を最初から分けておくと、後から「この回答はどこ由来か」を追えます。
ログの粒度についても、実務では逆の失敗があります。AIに議事録から丸めて起票させると、記録がすべて同じ担当者の名前で、丸まった粒度で残る。何が本当に残っているのか分からなくなります。管理しやすい単位で切ること。証跡の設計は、AIエージェントの監査証跡でさらに掘り下げています。
私たちの見解: チェックリストは文書ではなくCIに置く
ガイドラインには、別資料としてチェックリスト・ワークシートが用意されています。10の指針に対して実施状況を確認できるフォーマットで、自社の事業内容に合わせて独自版を作って更新することが推奨されています。掲載項目をすべて採用する必要はない、とも明記されています。
私たちの見解は明快です。このチェックリストは、Excelで年1回埋めるものにすると死にます。
私たちの現場経験では、紙のチェックリストは3回目の更新で形骸化します。前回のコピーに日付だけ書き換えた版が回り始め、実態との乖離に誰も気づかなくなる。だから私たちは、確認できる項目を継続的インテグレーション(コードを変更するたびに自動で検査が走る仕組み)に埋め込みました。
- 秘密情報(APIキーやパスワード)が設定ファイルに書かれていないか → コミット前に機械が止める
- 過剰な権限が自動で付与されていないか → 定期スキャンで検出する
- テストが通らないコードが本番に出ていないか → 自動テストで止める
- 到達不能な機能や本番のダミーデータが残っていないか → 機械で検出する
自社のシークレット管理を見直したときには、889件の秘密情報を平文で展開せずメモリ内で処理して移行しました。データベースの関数に匿名ユーザーの権限が自動付与されてしまう問題も、自分たちで検出して封鎖しています。どれも、人間の注意力ではなく機構で止めた例です。
正直に言えば、最初から全部を機械化できたわけではありません。最初は私たちも、ルールを文書に書いて周知していました。守られませんでした。守られないルールは、ルールではなく願望です。願望を機構に変えた項目だけが残っています。
自社プロダクトの品質も、同じ考え方で数値にしています。社内で計測した結果によると、自動テストは2,000件超が全通過し、経理システムのテストカバレッジは99%台に達しました。「守れる品質か」を数値で言える状態を、まず自社で作る。顧客に売る前に自分で運用する、という順序です。
どこから始めるか——1業務・1エージェントで棚卸す
全社のAI利用を一度に棚卸そうとすると、たいてい頓挫します。部署ごとに使っているツールも、リスクの性質も違うからです。リスクベースアプローチという考え方に沿うなら、始め方はひとつです。影響範囲が大きく、難易度がそこまで高くない業務をひとつ選ぶ。
判断の順序は次のようにしています。
| 問い | Yesなら | Noなら |
|---|---|---|
| その処理は、外部に不可逆な影響を与えるか(発注・送金・顧客への送信) | 人間承認を必須にする | 自律実行の候補にする |
| その出力を、作った本人以外が業務で使うか | 提供者としての責任を前提に設計する | 個人利用の範囲で運用する |
| 扱うデータに、個人情報や取引先の機密が含まれるか | 権限分離とマスキングを先に設計する | 通常のアクセス制御で足りる |
| 誤りが起きたとき、下流の誰かが気づけるか | 現行運用で回せる | 検証の仕組みを先に入れる |
この4問で、対象業務が「今すぐ任せてよい」「守りを作ってから任せる」「人間が持ち続ける」のどれかに分かれます。私たちが顧客の現場でやっているのも、結局はこの仕分けです。
そして、ここが肝心なのですが、仕分けの結果は紙で終わらせません。1日で動くプロトタイプを作り、実際の業務データを入れて触ってもらう。「思っていたのと違う」を早い段階で出してもらったほうが、要件定義書を往復させるより速い。AIに学ばせるのは解き方だけで、固有名詞や金額は学習対象から外す——といったガードレールも、動くものを触りながら決めていきます。
よくある質問
Q. うちは市販のAIサービスを使っているだけです。それでも対応が必要ですか。
必要です。ガイドライン上はAI利用者に該当し、入力データの適正性、人間による最終確認、セキュリティ対策の実施が想定されています。ただし求められる水準は、自社でシステムを作っている会社とは異なります。まずは「誰が・何に・どのデータを入れてよいか」を1枚にまとめるところから始めれば十分です。
Q. 社内で作ったツールを他部署に配ると、本当に「提供者」になるのですか。
第1.2版の別添には、AIサービスを利用して独自のAIシステムを構築した企業について、AI利用者でありながらAI提供者の区分を兼ね、保守・運用の役割も担うと明記された例が載っています。法的な義務が発生するという意味ではありませんが、社内の責任分担を決めるときは提供者として扱うほうが安全です。作った人が異動した後、誰が直すのかを先に決めてください。
Q. 人間が最後に確認していれば、それで十分ではないですか。
不十分になる領域があります。ガイドライン自身が、エージェントの自律性が高まると人間による監視のみでは対応が困難になる場合を想定し、AIシステムの相互監視といった新しいアプローチの検討に言及しています。私たちは、機械で検査できることは機械に任せ、人間は不可逆な判断に集中させる設計にしています。
Q. セキュリティ対策が過剰になってコストが膨らむのが心配です。
その懸念はガイドラインの立場と一致します。別添には、過度なリスク対策は便益を阻害するため、リスクの性質と蓋然性に応じて対策の程度を決めるべきだと書かれています。全社一律の厳格運用ではなく、扱うデータと影響範囲で段階を分けてください。
Q. 何から着手すれば、投資が無駄になりませんか。
業務の棚卸しからです。どの業務にAIが効くのか、どこに守りが要るのかを先に見極めないと、部署ごとに似たシステムが乱立して作り直しになります。私たちが無償の業務プロセス診断(BPR)を入口にしているのは、この順序を守るためです。
まず試すなら
- 社内で動いているAIの棚卸しを1枚にする。 部署・用途・使っているサービス・入力しているデータの4列で十分です。私たちが関わった現場のほとんどで、情シスが把握していない利用がこの時点で出てきました。
- 「配る前チェック」をひとつだけ作る。 個人で作ったツールを他人が使い始める前に、権限・データ・責任者の3点を確認する場を置く。文書化より先に、確認する人を決めるほうが効きます。
- 1業務を選んで、守りごと動かしてみる。 影響範囲が大きく難易度の低い業務をひとつ選び、承認境界と証跡を入れた状態で動かす。全社展開の設計は、その1件が回ってから考えて間に合います。
AI-Pathでは、無償の業務プロセス診断(BPR)を実施しています。現場のヒアリングから業務フロー・改善案・投資対効果のたたき台までを可視化し、「どの業務にAIが効くか」「どこに守りが要るか」を同時に見極めます。第1.2版への対応を単独のコンプライアンス作業にせず、業務改善の一部として進めたい場合は、お問い合わせからご相談ください。
自社のAIエージェントに渡す権限の設計そのものを、見直したい方もいるでしょう。その場合は、AIエージェントの権限設計もあわせてお読みください。
参考リンク
AI事業者ガイドライン(経済産業省・AI事業者ガイドライン検討会) — 第1.2版の本編・別添・チェックリストの公開ページ
AI事業者ガイドライン(第1.2版)別添(付属資料) — AIエージェント・フィジカルAIの事例とリスク記述の一次資料(PDF)
「AI事業者ガイドライン(第1.2版)」改定のポイントと事業者への期待(PwC Japanグループ) — 6つの更新論点の整理
櫻井 文雄(さくらい ふみお) 株式会社AI-Path 代表取締役CEO
関西大学法学部法律学科卒業。財務コンサルティング会社(エフアンドエム)、外資系生保営業(Prudential)でコンサルティング営業の経験を積んだ後、起業し様々な企業のCTO/CMOを歴任。その後、デロイトトーマツコンサルティング(Big4)、ABEJA(AI研究開発の国内リーディングカンパニー)にて官公庁・製造業・金融業・小売業・不動産業を中心に延べ20社以上のDX推進や業務システム刷新をPM/SMとしてリード。利用者目線での現場の課題解決にフォーカスしたものづくりに拘り、導入ではなく「定着化」を目的とした伴走型のプロジェクト推進・システム導入を得意とする。2025年にAI駆動開発(VibeCoding)と出会い、より多くの人・企業に価値提供するためにAI-Pathを創業。
関連コラム

「ブランチは汚していい、DBは触るな」——非エンジニアが安全にVibeCodingするための線引き設計
非エンジニアによる内製化が広がるほど、AIエージェントが本番データベースを壊す事故は他人事ではなくなります。2026年に相次いだ実際の事故と、私たちが顧客の現場で引いている『どこまで任せてよいか』の線引き設計をお伝えします。

製造業のAI導入、何から始めるべきか——よくある5つの疑問に答える2026年の実践ガイド
製造業のAI導入は「検討」から「実装」へ移行していますが、PoC止まりや現場に定着しないケースも依然多くあります。費用感・進め方・失敗パターンなど、よくある5つの疑問にまず答え、そのうえで領域別の選び方と実践のポイントを解説します。

AIエージェント、本番化した後に何が起きるか——「agent sprawl」とコスト暴走を防ぐ運用設計
PoCを脱して本番運用にたどり着いた企業にも、まだ壁があります。Gartnerは2027年末までに40%以上のエージェントAIプロジェクトが中止されると予測しました。本番化後に生まれる「agent sprawl」とコスト膨張、その運用課題と設計をお伝えします。